ARTICLES
-
♣ 《笑傲股市》的记录
📅 July 18, 2026 📂 INVESTMENT
笑傲股市由威廉-欧奈尔著,主要关注在景气类投资标的的思考,介绍了技术形态、财报指标以及止盈止损的定量建议
笑傲股市由威廉-欧奈尔著,主要关注在景气类投资标的的思考,介绍了技术形态、财报指标以及止盈止损的定量建议
价值投资需要忍受不断下跌的痛苦,而波段操作需要对技术指标运用自如。而如何使用中间态的手段呢
我们既不必做买入并持有的价值投资的殉道士,也不必做波段操作的趋势投资的牺牲品,完全可以按照中国人中庸之道的处事方法,从容应对牛市和熊市
炒股或者说投资其实是对自己心性的磨练与对人性的探查
学会CAN SLIM法则,不仅有助于在投资领域克服人性的弱点,而且能够在生活领域锻造完美的人格
做对的事情和把事情做对。如果发现错了,就应该马上停止,停止这时已经赚了
人类真是一种很奇怪的动物,有时候,明明知道自己错了,却仍然执迷不悟,在错误的泥沼中越陷越深,甚至无法自拔,投资者当然也不例外。也许是贪婪使然,股市中总有这样一批人,他们从不对市场进行理性的分析与思考,而是急功近利,试图寻求一条通往成功的捷径,做着一夜暴富的黄粱美梦,最终却要为此付出惨痛的代价,甚至丢了性命
书中提到从曾经的犯错中得到的启示:
- 右侧交易,并且浮盈加仓。为的是趋势确定
- 在即将突破年度最高点的时候买入这里的止损应该怎么设置,没有突破怎么办 ,而不是捡垃圾股
- 迅速止损,不要硬扛
- 降低对帐面价值、红利或者市盈率的关注,关注收益增长率、股价、成交量的变动
- 不要过度相信专家的分析,多数也是个人观点
- 熟练掌握各类线图
价格形态的研究
书中介绍了不同的线图价格形态,包括:带柄茶杯、双重底、平地价格、方盒子、窄而高旗
线图价格形态,这里也称为“基底”,就是指经过前期的上涨之后的一段价格回调并筑底的区域。它们大都(80%~90%)形成于总体市场调整的过程中
几个经典的价值形态
带柄茶杯形态
顾名思义就是一个带柄的茶杯,其中杯状形态可以持续 7 ~ 65 周,杯的回调深度为 12% ~ 15%,一般不会超过 33%。一般呈现 U 形,而非狭窄的 V 形
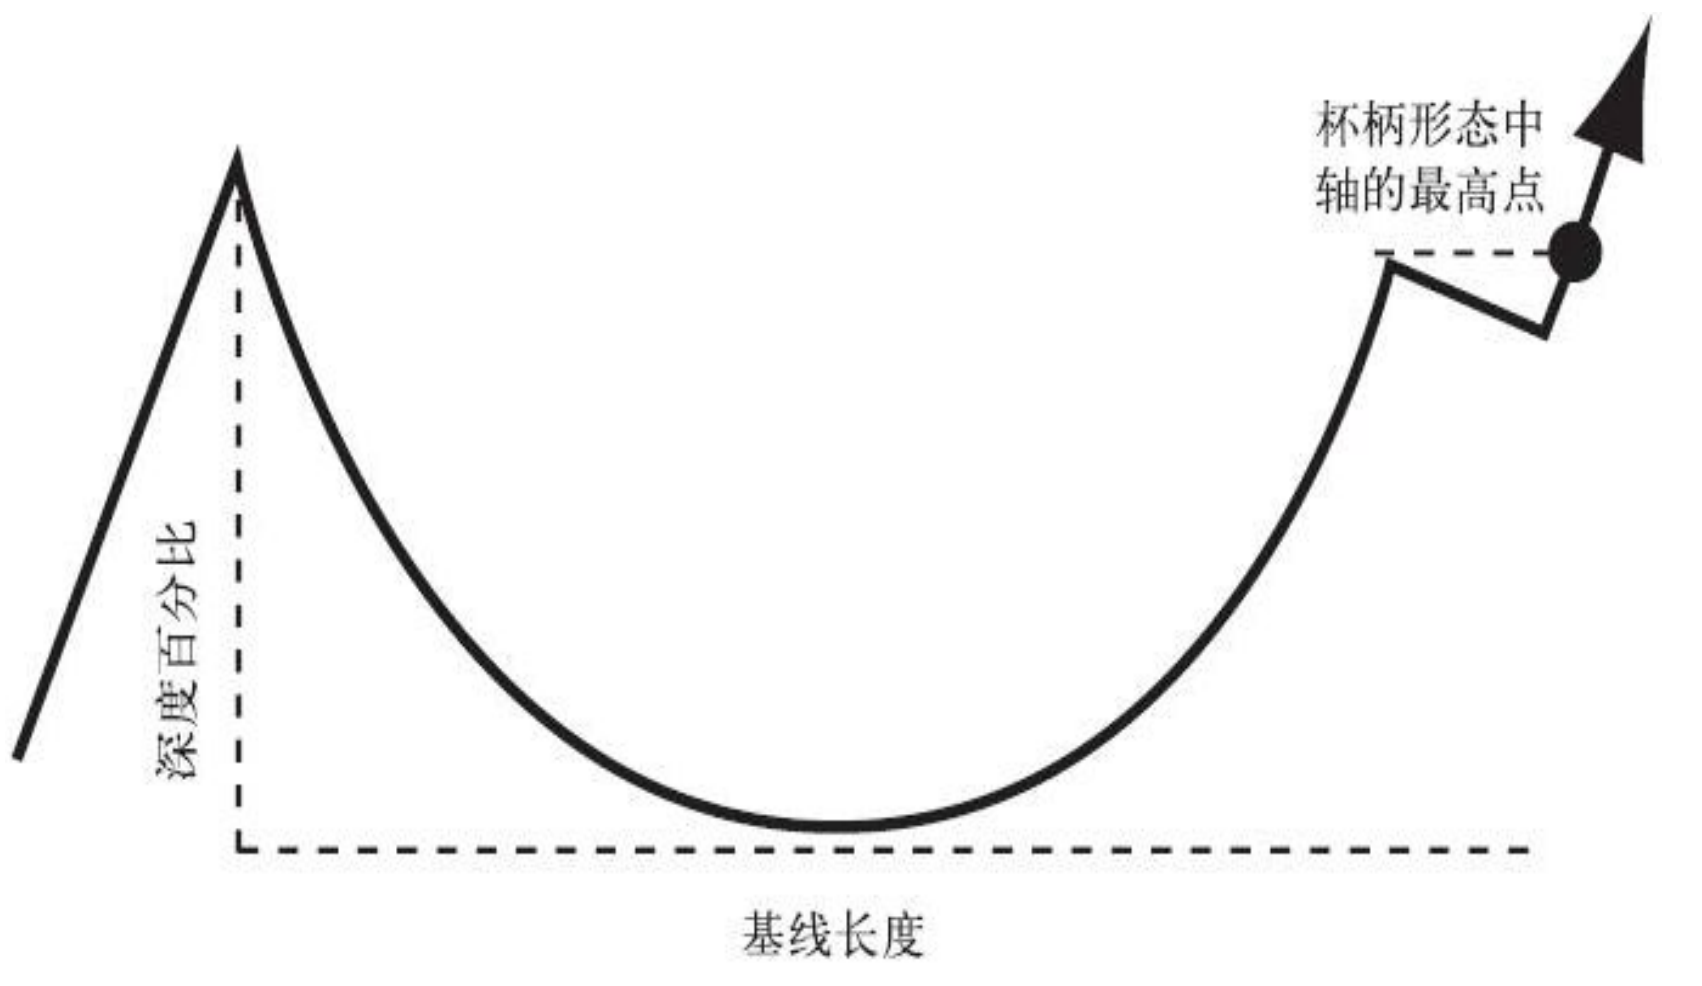
带柄茶杯形态示意图 对于茶柄区域至少要经历一两周的时间,并且价格伴随下行的阶段,一般下跌到较低点的最后阶段,成交量成萎缩状态。杯柄一般位于 10 周线上方,如果处于下方可能是比较弱需要注意,回调深度一般是 8% ~ 12%,如果超出可能会松散而无规律
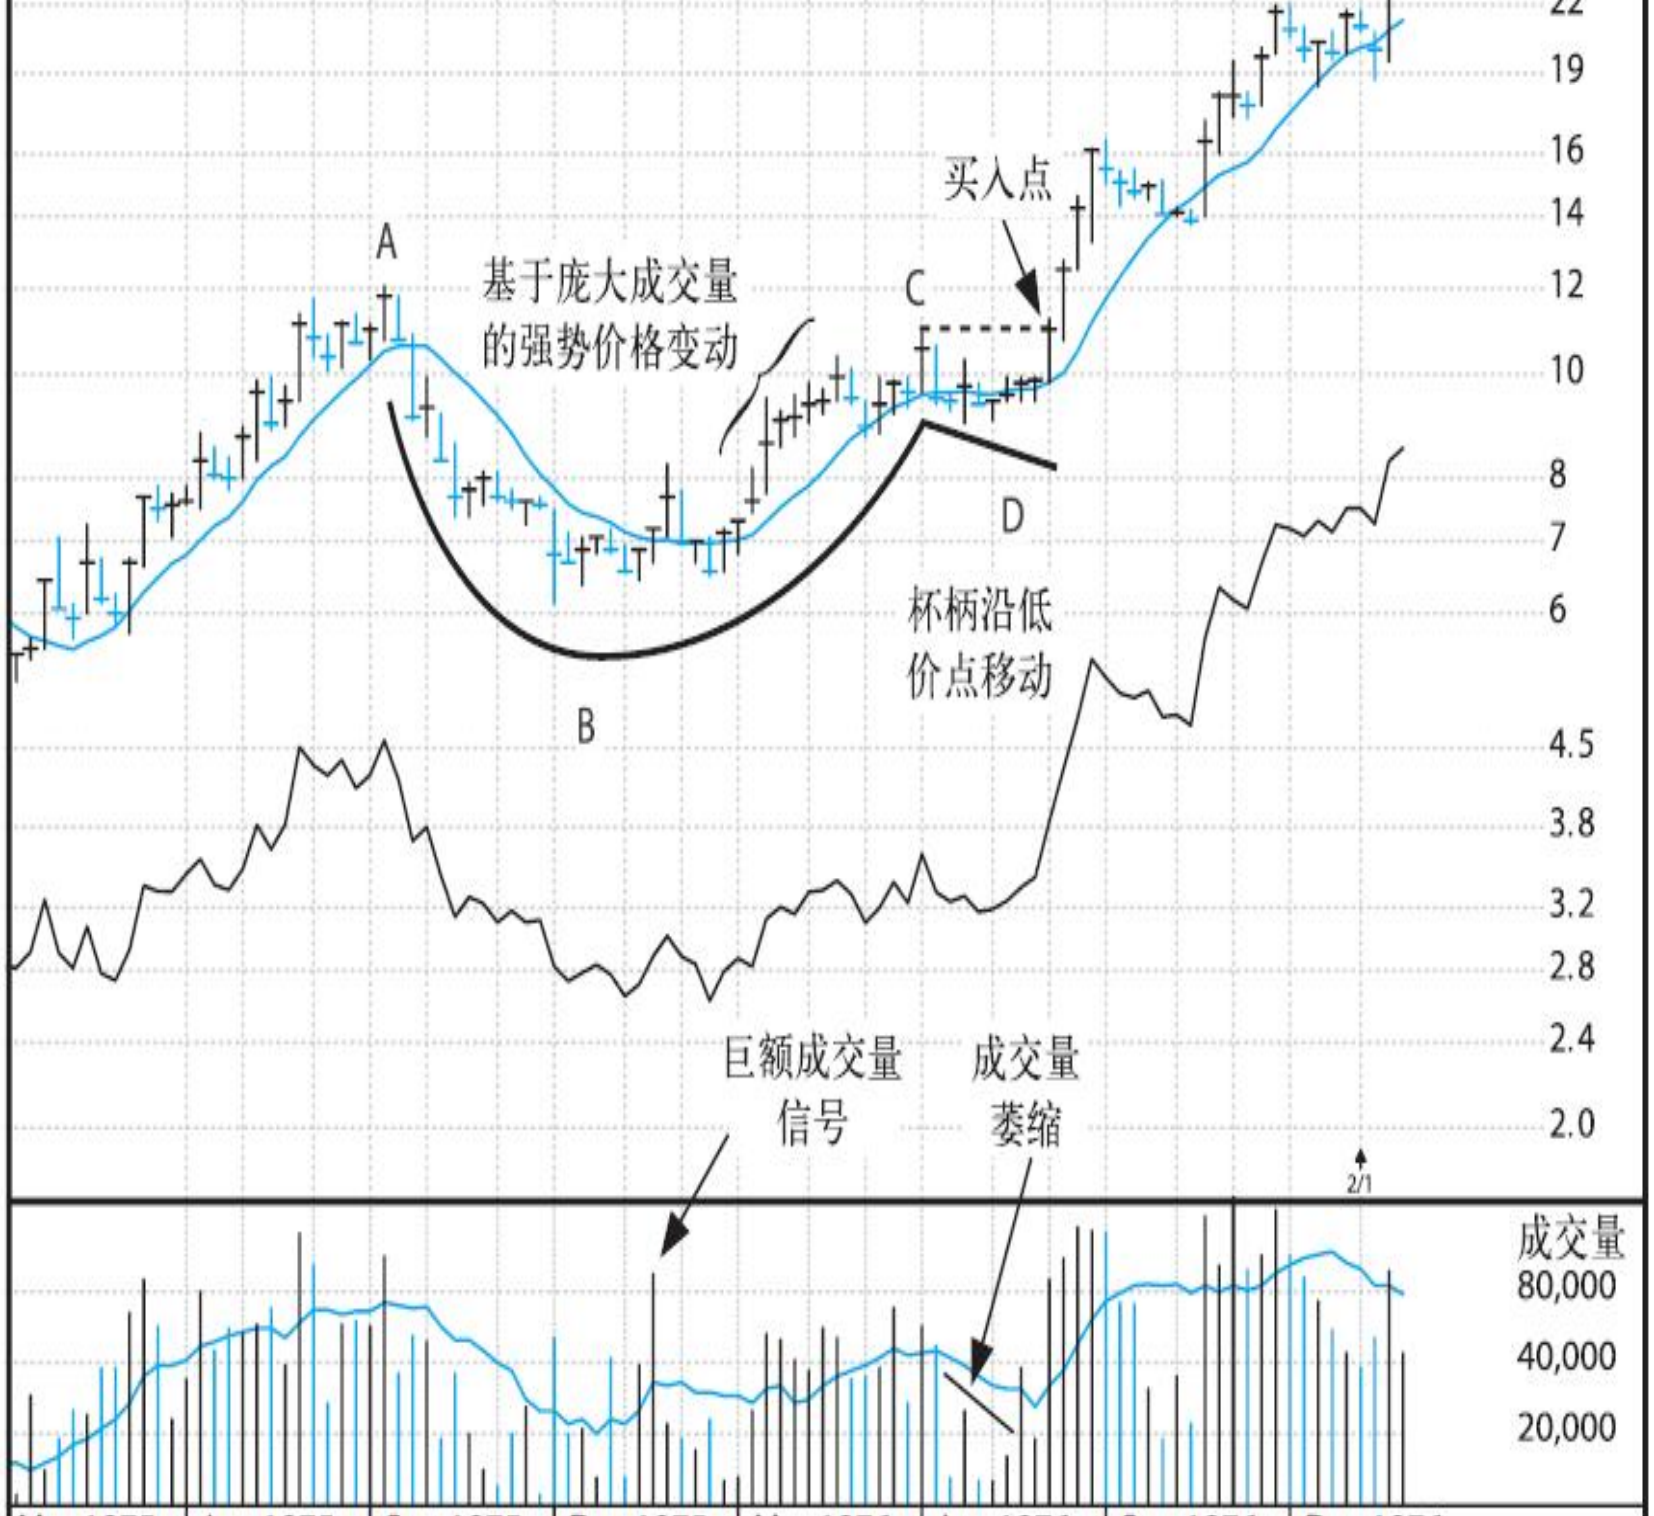
带柄茶杯形态实盘图 一旦某只股票形成了有效的带柄茶杯形态,并且随后股价涨过买入点杰西·利弗莫尔称之为中轴点或是最小阻力线 ,当天的成交量应该会比平常高出 40%~50%
双重底形态
双重底形态很像英文字母 W,往往第 2 个底部大部分时候会比第 1 个底部低一两个基点
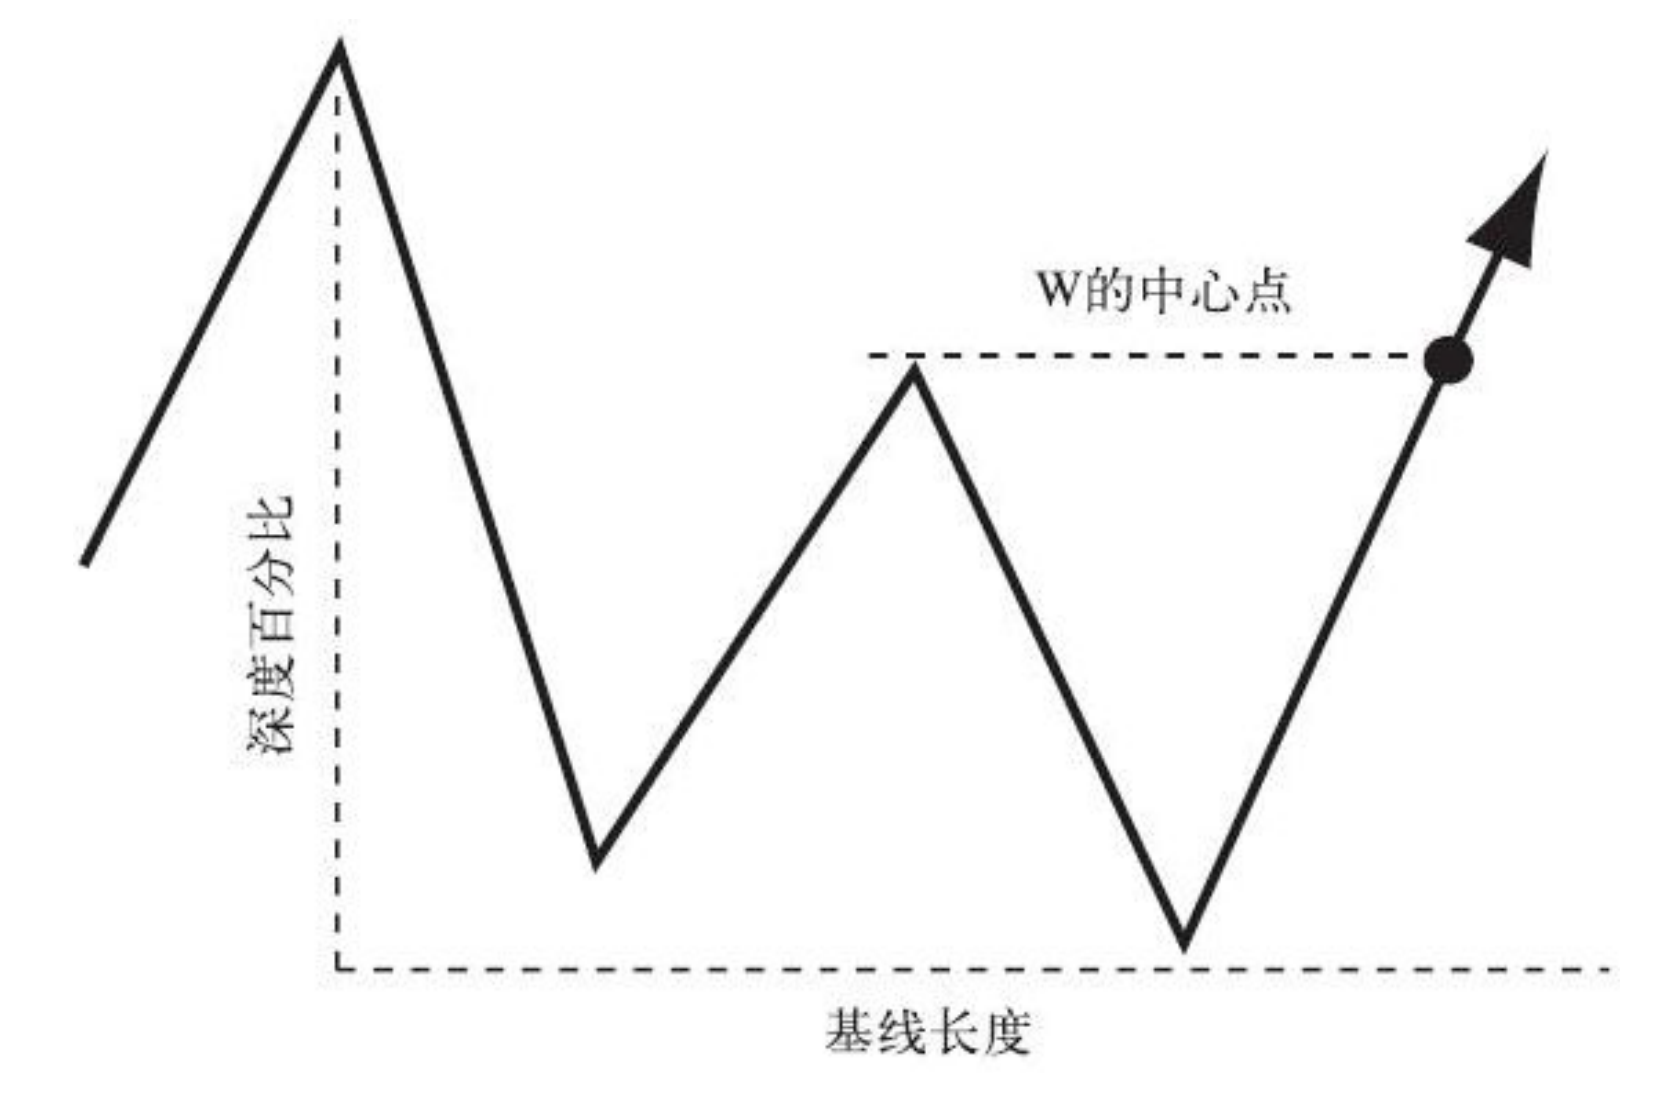
双重底形态示意图 需要注意几个要点:
- 第二个底的位置一般要比第一个底低一些
- 反弹需要过 W 中心点
- 伴随成交量明显增加
平底形态
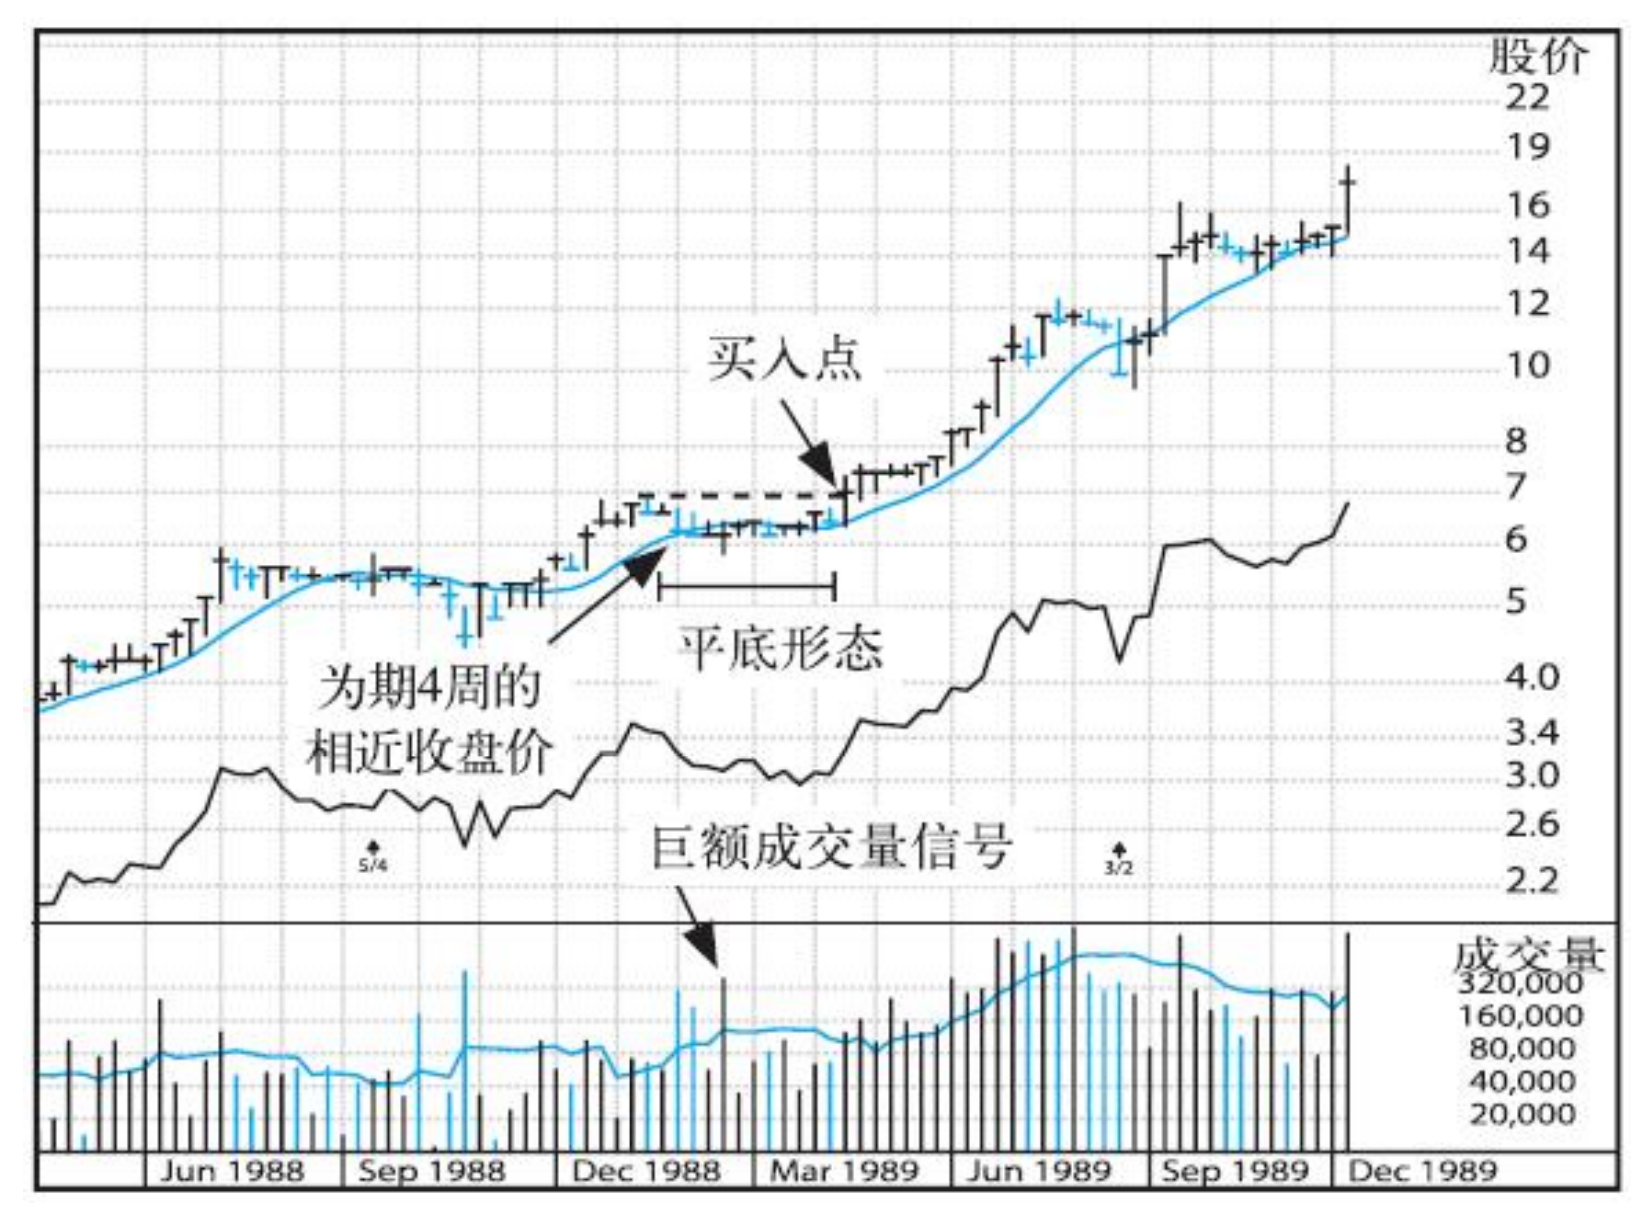
这是在上述两个形态结束之后至少上涨 20% 后,才可能形成。往往以窄幅价格波动方式水平移动最少 5 ~ 6 周,调整幅度不超过 10% ~ 15%。在平底过程中会伴随巨额成交量,在超过进入平底时价格买入,注意后续可能不会立即拉高
平底形态实盘图 高而窄旗形态
这类形态极其罕见,因此不学习
宽松的价格结构导致的失败
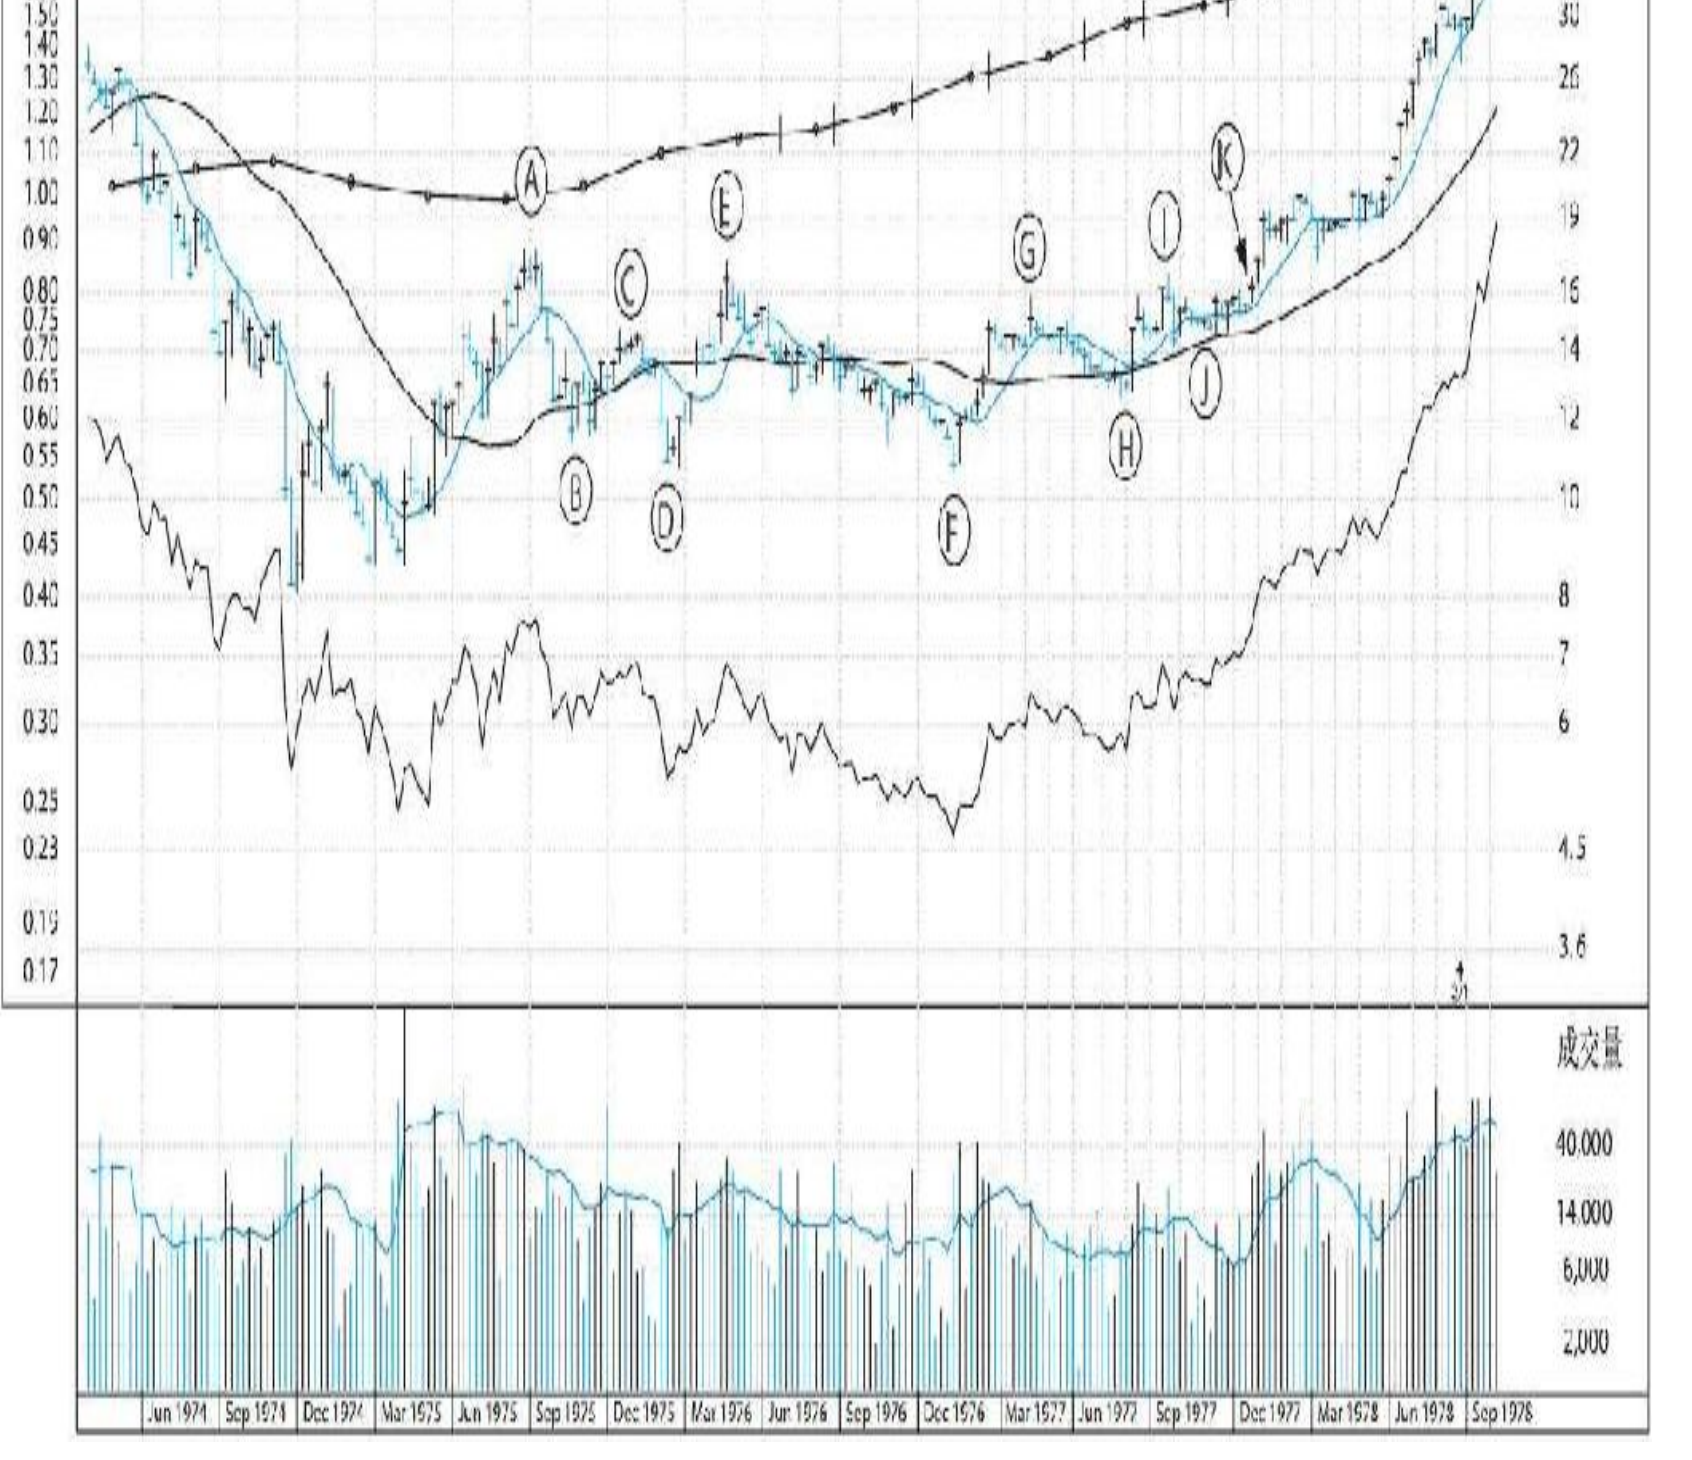
宽松的价格结构实盘图 分析如下:
- A B C D E 来看其和双重底接近,但股价 A 到 D 直跌了 40%,跌幅过大,并且触底时间过长接近 6 个月 。并且在 E 点买入是错误的,因为柄部太短并且没有形成一个挤出区域,其价格沿着较低点楔形上移并且可以看到其相对趋势线是呈下跌状的
- 而 G 看似一个好的买点,然而短短 3 个月难以扭转劣势
- I 看似是茶杯的柄,原因是柄部过于松散
- 直到 K 点有趋势线明显改善的样子,并且调整周期也到了 11 个月
从分析来看,第一处可能性在于主要在于急跌以及实际情况中突破中点 C 时可以买入,需要观察后续情况观察到 E 不对可以适当卖出。E 处下跌时间太长太深且没有量的配合,导致柄部位置松散。其实 J 结束就可以买入了,量也有了体现
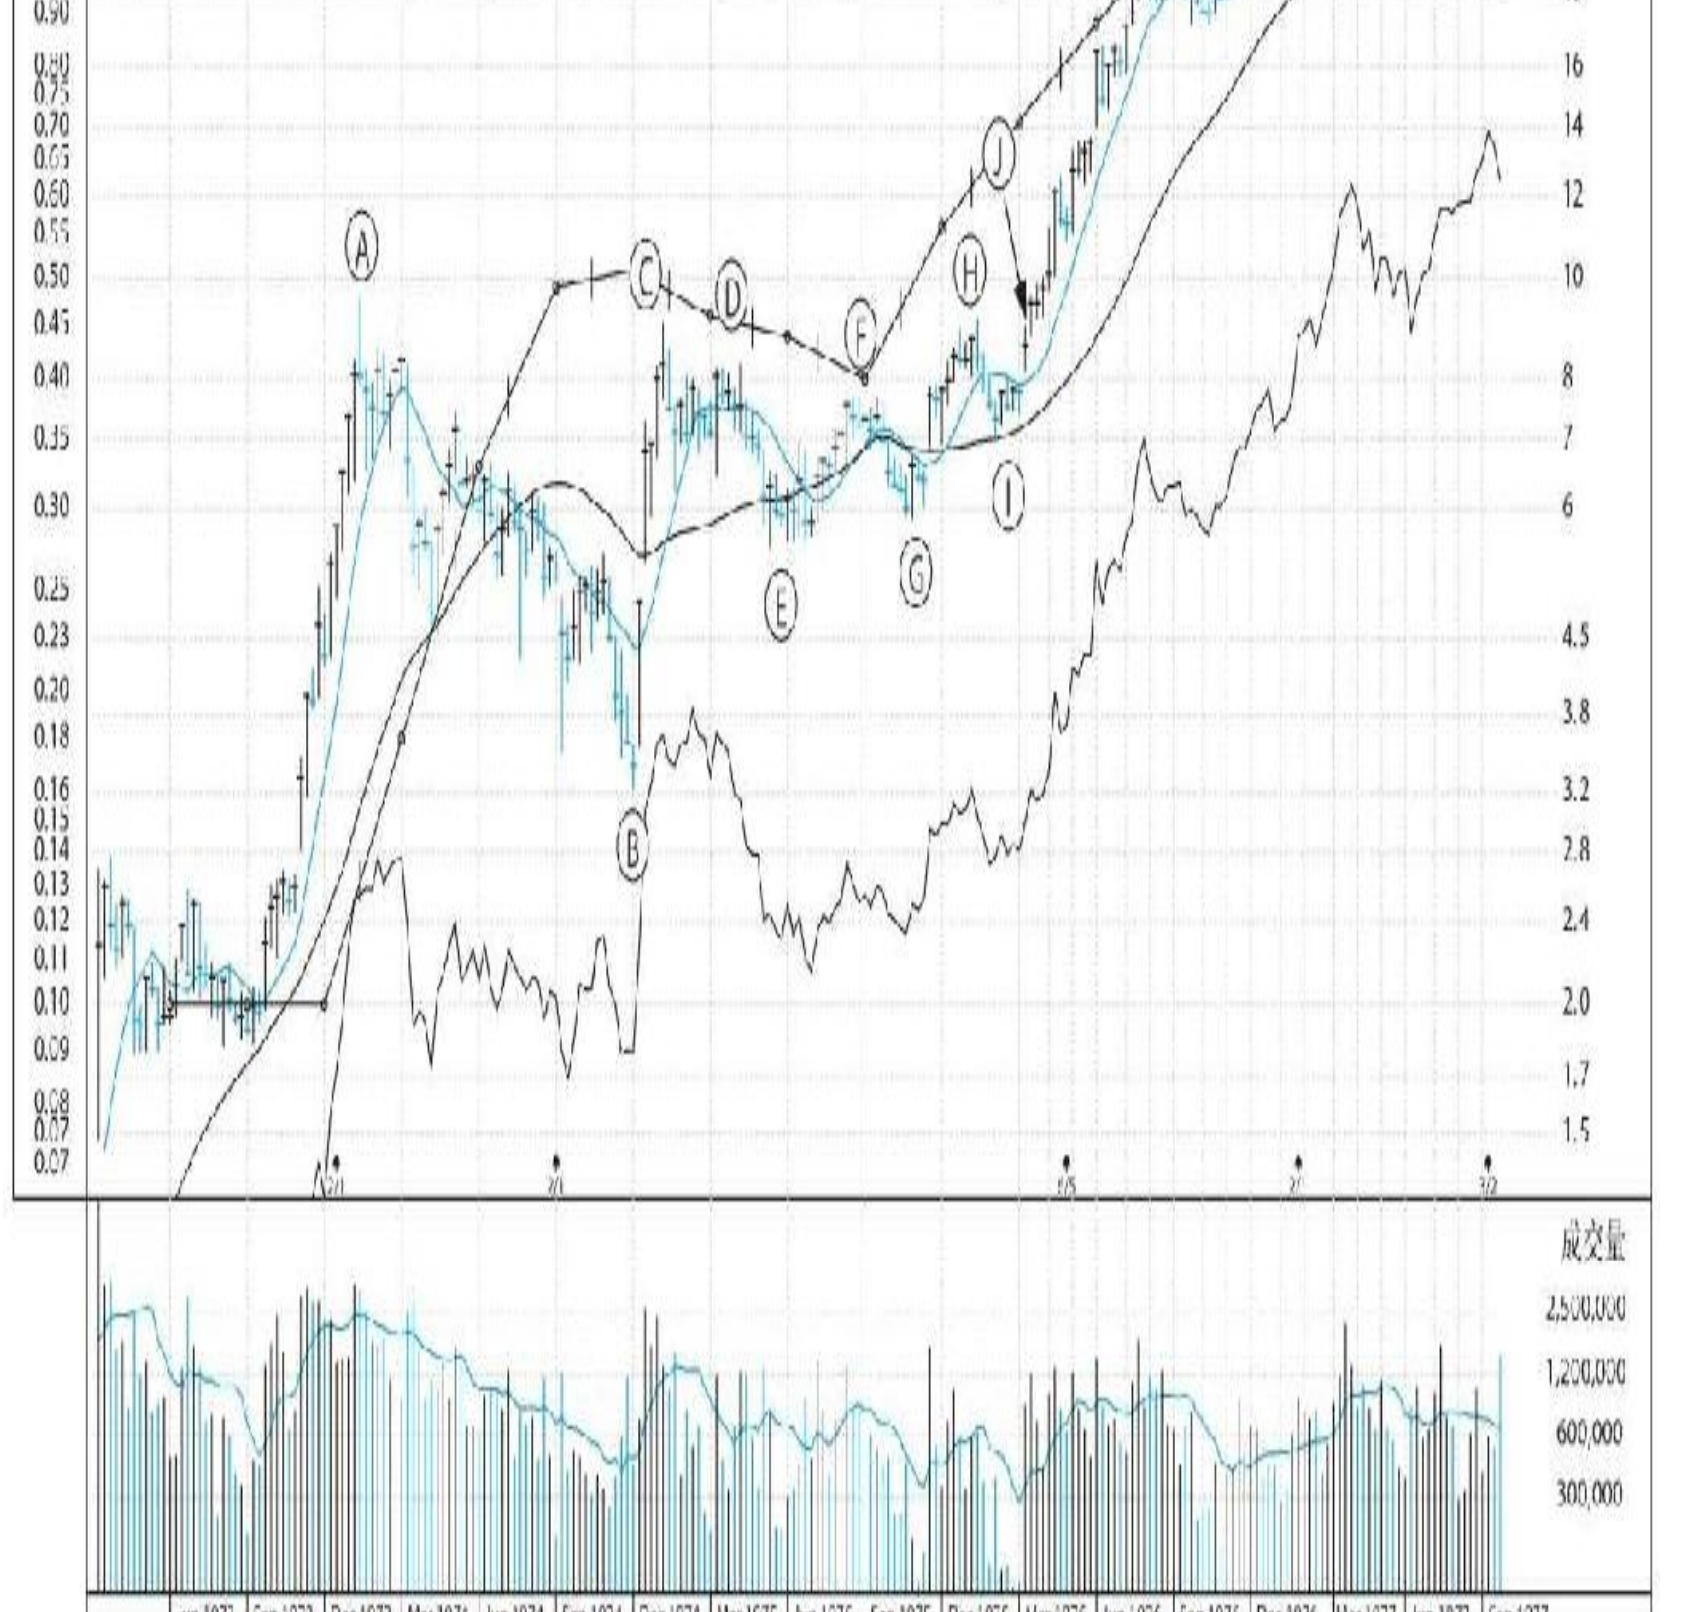
宽松的价格结构实盘图2 从 A 点到 B 点再到 C 点的区域极为宽松而无规则(跌幅过大)。B 点则没有经过任何价格回调就直接从底部冲上 C 点,C 点和 D 点是试图冲出带有缺陷的价格形态的伪突破点。H 点也是如此,它想要突破松散的杯柄区域。之后,从 H 点到 I 点再到 J 点形成了一个为期 9 周的紧凑形态
探究有缺陷的价格形态
往往价格形态基础过弱是因为根本没有足够的时间或价格进行回调,无论是平底形态还是方盒形态至少需要 4 周以上的时间进行调整,最可靠的价格形态实际上至少需要进行 7 ~ 8 周的价格调整
而部分价格形态本身容易成为松散、弱势的结构,比如三重底形较于双重底形而言,价格会经过三次调整并大幅回落到最低点,使其更容易转弱
保值型供给原则
简单点说就是价格的压力位,比如前期集中交易的较高位置,当价格回涨到该区域容易出现源于投资者保值目的的股票供给(俗称抛压)
大跌之后,投资者大都希望有机会拿回自己曾经跌去的本钱(人性如此),那么,许多投资者会在股价回升后将股票卖出也就不足为奇了
关于熊市的警示
简而言之,对于熊市一切价格形态和技术分析都可能失效顺势而为很重要
如果你初涉股市,或第一次听说本书中提到的经实践证明为正确的策略,或者,更重要的是,如果你读本书时,熊市刚刚到来或者尚处于中期,那么,千万不要奢望你自己能够成功应用本书讨论的买入形态。一般来说,在熊市中,大多数价格形态都是绝对有缺陷的,你当然不能轻率地在突破点买入股票,因为它们往往会以失败告终
公司指标与股市的一些思考
公司的销售额、净收益等财报指标往往是多数人看中的,但书中指出这里面可能暗藏着大坑
关于当季每股收益的思考
首先股价和收益比翼双飞是随处可见的案例。关于销售额和净收益可能是藏在收益报表中的地雷:比如销售额上升,看似不错,但实际上净收益下降了,实际上成本上升了;哪怕净收益也上升了,也可能通过额外发行来稀释了普通股,因此
为了避免由于季节性导致的扭曲,应该将公司的每股收益与上年同一季度而不是本年前一季度相比。举例来说,为了更准确地评估,应该将第 4 季度的每股收益同上一年的第 4 季度相比,而不是同本年的第 3 季度相比
不论你是股市新手还是资深投资者,我绝对不建议投资者买入最近一季度每股收益同比增长幅度不到 18% 或 20% 的股票
昙花一现的巨额收益
可能出现某一季度收益额剧增,不要高兴,先看看是不是非经常性利润。这样的收益是一次性的,比如卖楼、卖设备、卖子公司你不是每个季度都有固定资产可以卖
回避安于现状的老牌大公司
实际上,美国很多老牌公司的管理层都碌碌无为,公司收益也一直处于二流水平。我把这些人叫作“墨守成规且安于现状的人”或“类似看门人的管理层”
研究对数坐标周线图
对数坐标图更能清晰表现股价上升幅度
根据年度收益率来选股
值得投资的公司,其年度收益增长率应该至少达到 25%~50%,甚至达到 100%
股本回报率和每股现金流量也是需要关注的重点,前者是净收益除以股东的股本,一般至少要达到 17%
关于正常的股市周期
大多数牛市(大盘持续上扬)会在持续2~4年后转为衰退或熊市(大盘持续下跌),接下来又会迎来新的牛市。过去的收益增长并不能说明你选择的是一只强劲的成长股。实际上,一些所谓的成长股近期报出的收益远比之前要低。要知道,某一周期的领军股未必会在下一 周期也续写辉煌
每股收益的上涨百分比相比于股票的市盈率更加重要,需要判断其收益的变化速度是在上升或者下降。对于成长股而言高于每股收益 25 ~ 50 倍买入都是很正常的
问题的关键在于,任何人都能以低价买到一件平庸的艺术品,但是最精华的那些却是价格不菲。同这些珍品一样,一般来说,最好的股票,其价格也更高
股市中的超级悖论
那些对绝大多数投资者来说价格过高、风险过大的股票,往往会百尺竿头,更进一步;而那些看似低价、便宜的股票却常常会进一步走低
买入股票的正确时机
价格达到新高,并不代表这是买入股票的正确时机。在此之前,还要应用股票相关线图进行选股的技术分析。如果股价能从有效的价格形态中突破出来,并在这一过程中创造了价格 新高,这才是你应该投资的股票
关于股票的供给量
假设某一公司发行了 50 亿股,供给量如此之大使其价格基本无法变动。只有极大的购买量或是需求,才能推动这些股票强势上涨。相比之下,对于发行量相对较少,如 5000 万股的股票,适量的购买就能带动价格上扬
过分拆股的不利影响
举例来说,当某只股票以 1:2 的比例进行分拆时,你持有的股票量变为之前的 2 倍,但是新的股价则为之前的一半。一般来说,规模过大的分拆会使股票的供给量大大增多,该公司很快将处于一种发展缓慢、市值较高的情况
关注回购的公司
当某一公司,尤其是那些符合 CAN SLIM 标准的中小规模成长型公司,在某一时段内持续在 公开市场上进行回购的话,这往往是一个好的预兆。10% 就属于大规模回购,这一行为会减少股票的数量,而且表明该公司预计其销售额和收益会有所提高
投资者还需关注公司的资本结构中是否存在可转换债券;如果存在,那么当债券转换成普通股时,股票收益可能会被稀释
供需的评估
当某只股票价格回落时,你应该希望成交量在某一时点有所萎缩,进而说明不再有太多的抛售压力。而当股价上涨时,大多数情况下应该希望成交量上升,因为这通常代表机构投资者而非公众的买入
你应该对某只股票的价格形态进行逐周分析,从该股票开始形成有效的价格形态的那一周开始,直到你认为它已经突破价格形态的当周为止
买行业中的龙头股票
一般来说,强势行业中的前三甲公司往往会涨势惊人,而其他股票则会波澜不惊
总之,如下忠告一定要牢记于心:即使看似便宜,投资于滞后股也很少能给你带来回报,必须寻找并且将你的选股范围限定为市场领军股。一旦股价低于买入价的 8%,赶紧卖出那些滞后的“失败者”,以免因冒险让自己伤得更深
关于机构认同度
一只成功的股票并不需要有大量的机构投资者来关注,但是至少应该有几家。在少数包含小规模或是新兴企业的投资中,机构投资者的合理最小数量可能为 20,尽管大多数股票所拥有的机构投资者要比这多得多
在市场低迷时保护自己
当股指已经冲顶并开始形成下跌趋势时,你需要立即以市价卖出股票,至少将 25% 的资本转化为现金
如何判断股市顶点
在上升趋势的过程中,一般来说,总会有一天的成交量会比前一天增加,但其指数上涨乏力(主要表现是这一天的价格涨幅明显小于前一天)
最接近大盘顶点的正常换筹时间通常是在见顶之前 4~5 周中特定的 3~5 天。也就是说,趋势还在上升的时候,股票市场就已经开始出现新的利益分配格局,很少有人注意到这一点。一旦出现明显的3~5个换筹时点(不管出现在见顶之前 4~5 周的哪个时段内),股市大盘多数情况下都是呈现下跌趋势的
关注联邦储备委员会的相关利率变动情况
利率是基本经济状况最好的确认工具,而其中贴现率和联邦资金利率的变动则更为可信。根据过去的经验,美联储连续3次显著提升利率通常意味着熊市的开始和经济衰退的迫近
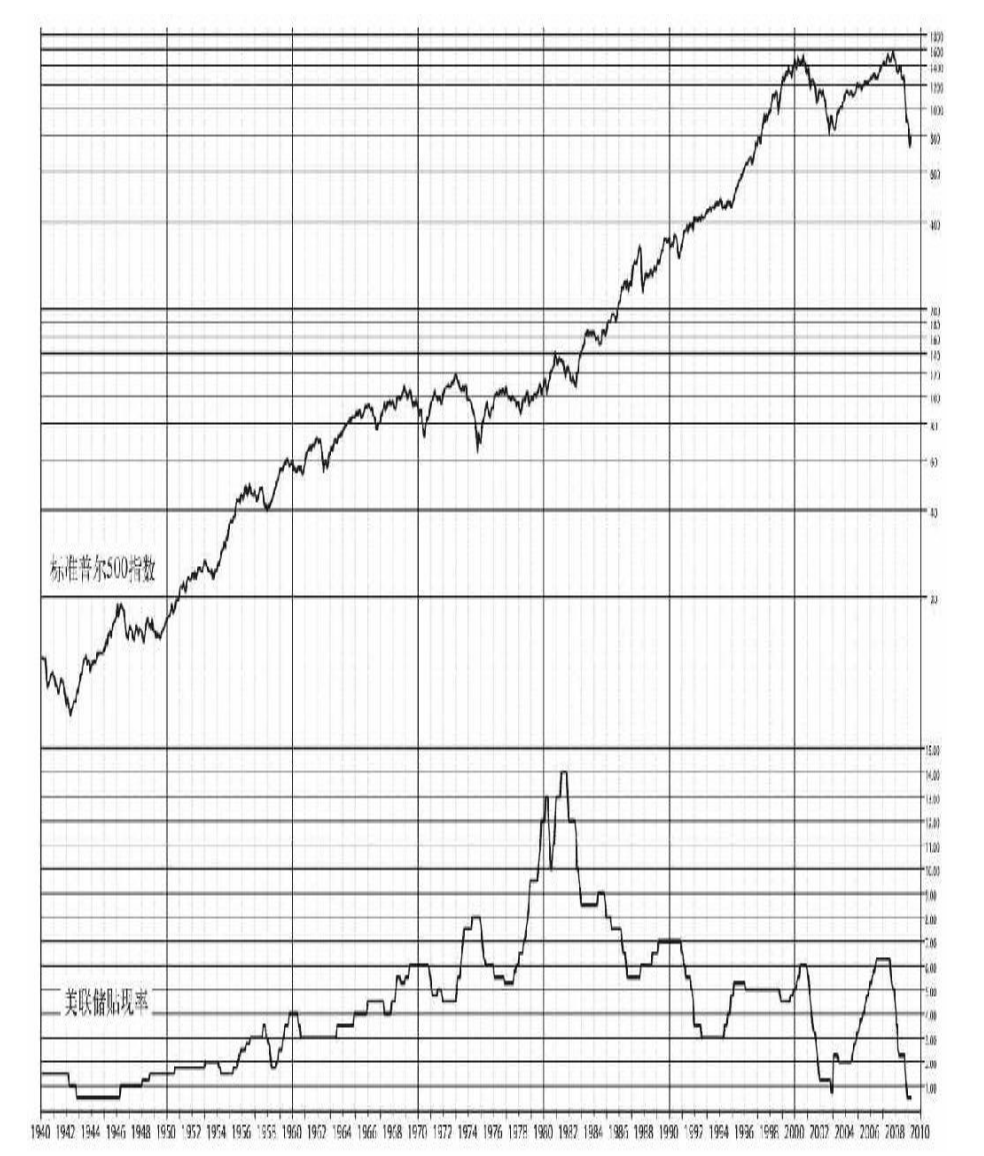
利率和指数的实盘对比图 防御性股票指标
一旦有经验者的资金涌入防御性股票,往往预示着大盘将会日趋衰落。但是,这一指标并非常常有效,毕竟没有一个次要的市场指标跟关键大盘指标一样可靠
正如很多技术指标一样,它无法预测未来,只告诉了你过去一段时间发生了什么,当前处于什么状态。多关注市场的供需变化才可能感受到熊市的到来
CAN SLIM 法则总结
C=当季每股收益。至少上涨 18% ~ 20%,保持持续上涨的同时,季度销售额应该有 25% 的涨幅
A=年度收益增长率。近三年来,每年的年度每股净收益都在 25% 以上,同时股本投资回报率不低于 17%
N=新公司、新产品、新管理层、股价新高。购买那些从平稳的走势中脱颖而出、价格底部已经完全形成并且股价开始创出新高的股票
S=供给与需求。兼顾考虑流通股份的供给数量加上大量需求情况
L=领军股或拖油瓶。买领军股,回避落后股
I=机构认同度。买近期持续上涨,并且至少有一两家近期投资业绩拔尖的共同基金投资者认同的股票
M=判断市场走势。你必须顺势而为,不要偏离市场趋势进行投资
CAN SLIM 总结了需要在投资中注意的 8 个方面,当各种买入或卖出信号共振的时候,成功的概率是最大的。但需要主要一切都是概率,所以接下来做好止损也是非常重要的
关于止损以及股市中谨慎注意的事
这些错误的决定会带来亏损,如果你并非训练有素或小心谨慎的话,损失将非常惨重。聪明与否、智商高低、受教育程度、信息好坏以及分析是否合理都不能改变这样一个事实:投资者不可能在任何时候都是正确的
永远要及时收手并将每一种损失降到最低。想要做到这一点,必须要坚持不懈地训练,并拥有足够的勇气
书中建议 3 比 1 的盈亏比,如果盈利 24% 则止损设置在 8%。发现牛股是小概率事件大概 10% 到 20%,也就是大部分买的股票可能使你亏钱,那么需要及时止损。切记 8% 是绝对止损线,无须任何等待,直接抛出!甚至不需要等到当天收盘
如果你对于亏损仍然执迷不悟,就还是过于情绪化而没能厘清思路。你为自己找了一个看似合理的理由:“股价不会再低了。”但是,请记住一点,还有很多别的股票可供选择,而且挽回损失的概率也更大
另外请谨记
永远不要违逆股市,健康的身体以及平和的心态永远比任何股票都重要
迅速止损,缓慢收利
股市中的第一笔损失总是最小的。在我看来,做出明智投资决策的方法在于,应该一直(没有任何例外)迅速止损,缓慢收利。但是,大多数投资者却反其道而行之,把利润迅速收回,而止损的步伐却迟迟不至
要想成为一名成功的投资者,必须面对现实,而不是自欺欺人、空怀希望。没有人愿意承受损失,但为了增加在股市中成功的概率,你不得不面对很多自己不情愿做的事情。形成一些具体的准则以及严格的卖出规则,这样就可以胜券在握
卖出策略
卖在人声鼎沸时
3~6个月中赚取 20% 的收益可远比花费 1 年才取得相同的结果要有效得多。一年之内两笔20% 的利润就相当于取得了年利率为 44% 的收益。经验丰富以后,你就可以使用全额保证金来进行投资(保证金账户中的购买力),并把自己的收益率提高到近 100%
如何研判大盘走势
作者在多次试错后,观察到了一个令自己受益匪浅的发现
我买入的大多数市场领军股之所以会由涨变跌,是因为大盘开始了跌幅至少为 10% 的下挫
顶峰前最后的疯狂
- 最大的每日股价上涨幅度。持续数月显著提高,并且当日的收盘价比之前上涨阶段中任何一天的收盘价都要高出很多
- 最大的日成交量
- 消耗性缺口。长期上涨后,如果某一股票当天以50美元的最高价收盘,并且在次日上午以52美元的价格开盘并能保持整天的上涨势头的话,就出现了2美元的跳空缺口。这就是消耗性缺口的含义
- 顶峰前最后的疯狂表现。如果某一股票近期涨势过于强劲,比如在周线图中已有连续两三周的迅速上涨,或是在日线图上,连续 8~10 天中有 7~8 天强势上扬,赶紧将其抛出
- 出货行为的信号。长期上涨后,伴随着巨额成交量,股价却毫无起色,这一迹象表明市场出现了出货行为
- 股票分拆。卖出那些在股票分拆后的一两周内仍能上涨 25%~50% 的股票
- 连续下跌的天数增加
- 上轨道线。在股价图中,用一条直线连接低价点,并用另一条直线将过去四五个月中的3个股价最高点连接起来,由此形成的线被称作轨道线
- 当股票从最高点处开始下跌的时候进行抛售。尽管最初下挫后,有些股票可能会再次反弹
跌破价格支撑区域
- 跌破长期上升趋势线
- 最大的股价日跌幅
- 大规模周成交量情况下的股价下跌
- 200 天移动平均线转而下降
- 股价在 10 周移动平均线以下徘徊不前
资产配置策略问题
同时持有多只股票未必是一件好事
人们常说:“不要把鸡蛋放在一个篮子里。”表面看来,这一建议非常合理,但经验却告诉我,很少有人能同时做好两件以上的事情
如果你的票大于 10 支,你很难去追踪
是否应该长期投资
任何管理得当的投资组合,都不应该容许损失存在6个月以上
是否应该做空
很少有投资者能够理解卖空这一问题,而成功者更是凤毛麟角
可能的关键错误
- 当损失很小并处于合理的范围时,持股不动这是到目前为止,几乎所有投资者都曾犯过的最严重的错误之一;他们不明白,所有的普通股都是极具有投机性的,并能带来巨大的风险
- 在股价下跌时买进,却越陷越深
- 买入时,向下摊平成本而非向上加码
- 不学习如何使用线图,而且不敢买入那些即将在合理的价格形态上创下价格新高的股票
- 由于既不懂得选股标准,也不知道应该具体关注成功企业的哪些方面,所以永远都无法在投资领域中入门
- 没有指定具体的市场规则来指引自己,因此不知道股价调整何时开始,也不知道市场下跌何时会结束以便确定上升趋势
- 不遵循买卖准则,导致错误频出
- 将精力完全花费在选择何种股票上,而一旦做出买入决策之后,却又不知道应该在什么时候、何种情况下卖出
- 没能认识到选择那些受到机构投资者青睐的优质公司股票的重要性,他们更不清楚,学习如何解读线图对于改善选股和择机的重要作用
- 偏好买进低价股票
- 买入股票的依据是小道消息、谣言、股票分拆的宣布以及其他一些信息;咨询服务给出的建议;或是从其他人或是电视上那些所谓专家口中得到的个人观点
- 由于红利较高或是市盈率很低,便选择了一些二流的股票
- 妄图轻轻松松地赚点快钱
- 买入那些令你耳熟能详的大公司股票
- 没能识别并采用有益的信息和建议
- 急于卖出那些很容易获利的股票,对于那些赔钱的股票却死守不放
- 很少进行市价交易,而是更青睐在买卖委托中设定价格限制
对于错误可能反而是我们需要更加关注的方面,意味着我们可以从哪些方面优化自己的投资。我自身而言确实有犯书中提到禁忌,在哪怕在选到一只好的股票后,没有仔细思考其卖出的策略应该是怎么样,还处于一种靠感觉,靠即时信息的阶段。可能怎么形成自己的买入卖出策略以及清楚自己的行为模式是第一步需要改进的点
-
♣ GLM-4.6V
📅 February 23, 2026 📂 AI
这篇 blog 主要还是从数据上进行解析 GLM-4.6V,结构和训练方面只进行简单提及
这篇 blog 主要还是从数据上进行解析 GLM-4.6V,结构和训练方面只进行简单提及
Structure
首先 4.6V 还是采用的 VIT+MLP+LLM 的结构,VIT 使用的 AIMv2-Huge 作为的 Pretrain,关于这部分我们不深入进行介绍了。4.6V 对 rope 进行了一些 norm 方面的改造,总体上跟 QwenVL 系列思路一致。LLM 则使用的 GLM-4.5,相关训练细节会在后面介绍
Data
Pre-Training
Image caption data
图像文本对在预训练中尤为重要,最初的收集数据源来自:LAION, DataComp, DFN 和 Wukong 等以及互联网,共 100 亿条。通过以下 pipline 进行筛选:
- Heuristic-based filtering:主要是一些规则为主的过滤方式,包括 minimum image resolution, solid color detection, caption length constraints 以及 image-level deduplication
- Relevance filtering:使用 CLIP 检验图片文本相关性,只有阈值大于 0.3 的 pairs 会被留下
- Concept-balanced resampling:通过使用 MetaCLIP 重采样的办法来缓解长尾分布
- Factual-centered recaptioning:通过一个训练的 recaption 的 model 来对 caption 进行事实纠正,文本丰富recaption model 的数据和训练怎么来的?
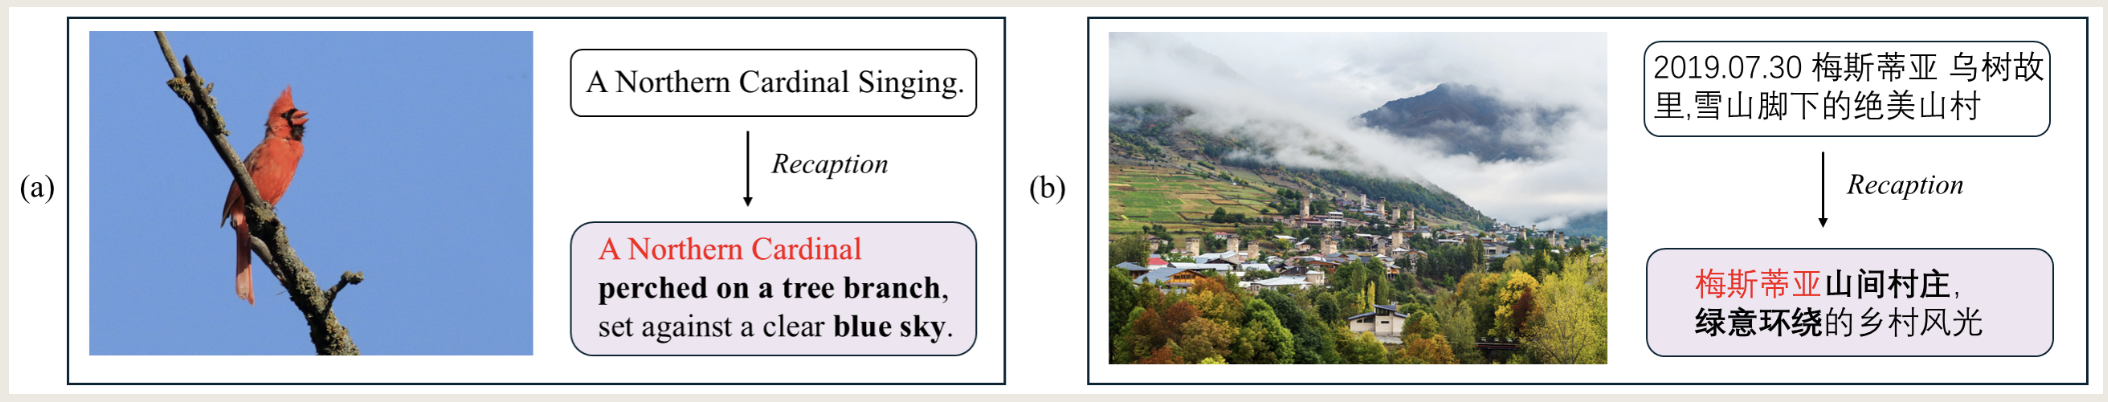
recaption 效果展示 Interleaved image-text data
这类数据常出现于 Web 页面和书籍中,它的问题在于:量非常大,但是噪音也非常大,信息分布不均匀。并且之前的工作很少利用这类数据来提升视觉-语言能力,特别是用来帮助模型适应多图片类型中的图文交错布局的形式。文中通过以下 pipline 解决:
- Web data processing pipeline:首先从开源数据集 MINT, MMC4 和 OmniCorpus 出发;使用 CLIP 去除图文不符的数据;结合规则和分类模型对二维码之类噪音严重的图片进行去除和以图片为主的相册;最后通过训练高信息密度分类器高信息密度分类器没有详细介绍 来筛选出信息密度高的数据,如 academic charts, scientific illustrations, engineering schematics, instructional diagrams 和 maps 等。而不是主要以图片为主的相册
- Academic book processing pipeline:弄了 1 亿本电子书,先通过是否是 science, technology, engineering, and mathematics (STEM) 相关进行筛选,其次再使用 PDF 解析工具进行解析
OCR data
这部分数据一共有 2.2 亿条,主要分为:
- Synthetic document images:使用不同的字体、字号、颜色以及朝向对 LLM 预料库进行在 LAION 数据集中图片为背景上渲染
- Natural scene text images:使用 PaddleOCR 对现实生活中的图片进行提取,并保留至少有一个文本提取结果
- Academic documents:和 Nougat 类似通过 LaTeXML 工具将 arXiv 的 LaTeX source code 转化为 HTML,再转换为轻量级标记语言(Markdown 之类的)。最后变为可以训练的 PDF 数据
Grounding data
这部分数据主要用来提高模型的视觉定位能力,主要分为两部分数据:
- Natural image grounding:以 Natural image grounding 为基础,使用 GLIPv2 通过解析 caption 中的名词并且得到图中的 bounding box。最后仅保留至少有两个有效 box 的图片,一共 4000万条数据
- GUI grounding:对于 GUI 领域,本文是从 0 构造的。从 CommonCrawl一个非营利项目/开放数据集,长期在互联网上大规模抓取网页内容,并把抓到的原始数据免费开放给公众使用 上最近的快照中提取 URLs。使用 Playwright framework 跟网页进行交互,从而获得 visible DOM elements 精确的 boxes,这部分数据一共有 1.4 亿条
Video data
主要使用人工标注和 embedding based 去重的方式,同时去除了一些无效的视频文件
Instruction tuning data
为了增强模型的泛化性和通用能力,增加了以下数据:
- Task coverage and taxonomy:设计了一套更细粒度的分类体系(taxonomy),用来优化数据采样,从而扩展并提升模型对世界知识的覆盖范围。这使得我们可以根据语义结构、任务目标、一些类别特定的前处理和均衡采样策略来组织 prompts
- Complex scenario augmentation:为了处理与公开数据集的 gap,使用复杂的合成规则来进行约束生成数据
- Data contamination check:为防止从公开的评测基准(benchmark)中发生数据泄露例如把测试集内容混入训练数据 ,我们对所有开源数据集都进行了人工审核和自动化审查
Supervised Fine-Tuning
文中指出与之前的工作不同,其将 SFT 当作模型使用高效的思考和回答的风格来对齐已经在 pretraining 视觉-语言的理解。其在 SFT 阶段生成了一个 long CoT 的数据集来训练模型多步解决问题的能力,也使得 RL 更加稳定和可扩展
Data composition
这个数据集包含各个 Domain 里面可验证和开放式答案的数据,主要以数学和英语为主以及一部分其他语种。并使用 pretrain 阶段的模型进行数据筛选,去除过难和过简单的数据没有提及怎么进行筛选的
Response formatting
每个 response 都遵循格式:
<think> {think_content} </think> <answer> {answer_content} </answer>,其中<think>包裹的是推理的内容,reflection 和 backtracking。<answer>很明显就是答案,但对于可验证的答案,需要被包裹在<|begin_of_box|>和<|end_of_box|>之中Response curation
对于 poorly constructed data 容易导致训练不稳定和崩塌。文中设计了严格的清洗 pipeline(没详细提及),使得上述格式能够严格执行以及去除了语言混合、重复思考的数据
Iterative data enhancement
从 RL 训练的 checkpoint 中 sample 高质量的 Cold Start 数据。实现 RL 阶段对 SFT 阶段的反哺
Reinforcement Learning
主要分为几个阶段来构造数据
Task identification
定义了一系列 VLM 中各个 Domain 中各个任务可验证的形式,比如 video caption 的答案是开放的,但是对于每一帧的 grounding 是清晰的答案
Data curation
过滤和生成问题答案对,使得其可以进行用验证器进行高精度的验证其回答是否正确。另外对于多个选择的答案,会将其转换为一个唯一答案(没有讲怎么做)以减少噪声
Quality validation and offline difficulty grading
使用现有的 RL model 来进行正确性的检查以及 passk 的 evaluation,再结合人工标注进行难度等级的分类
Pilot RL experiments
进行初步的 RL 实验来确认各个领域数据质量和模型在该领域的潜在 performance
Training
简单对训练超参数和一些 trick 进行介绍
Multimodal Pre-Training Recipe
TP: 2
EP: 8
PP: 4
# balanced expert utilization
router-bias-update-rate: 1e-3
auxiliary-sequence-level-balance-loss-with-a-coefficient: 1e-4
sequence-length: 8192
global_bs: 1536
steps: 120000
Long-context continual Training Recipe
TP: 2
EP: 8
PP: 4
CP: 4
# balanced expert utilization
router-bias-update-rate: 1e-3
auxiliary-sequence-level-balance-loss-with-a-coefficient: 1e-4
sequence-length: 32768
global_bs: 1536
steps: 10000
Supervised Fine-Tuning Training Recipe
Global batch size 为 32,其余和上述基本一致。其中包括的数据有:多模态数据、数学问题解答、多轮对话、agent planning 和指令遵循。其中一个发现是:对于 cold start 数据里即便有噪声数据(格式不一致 or 重复 patten)依然不影响后续 RL 训练的效率。当然更干净的数据肯定对于 RL 的训练更有帮助。文中对于 thinking 和 non-thinking data 都进行了训练,使用
/nothink来进行开关Reinforcement Learning
Reward System
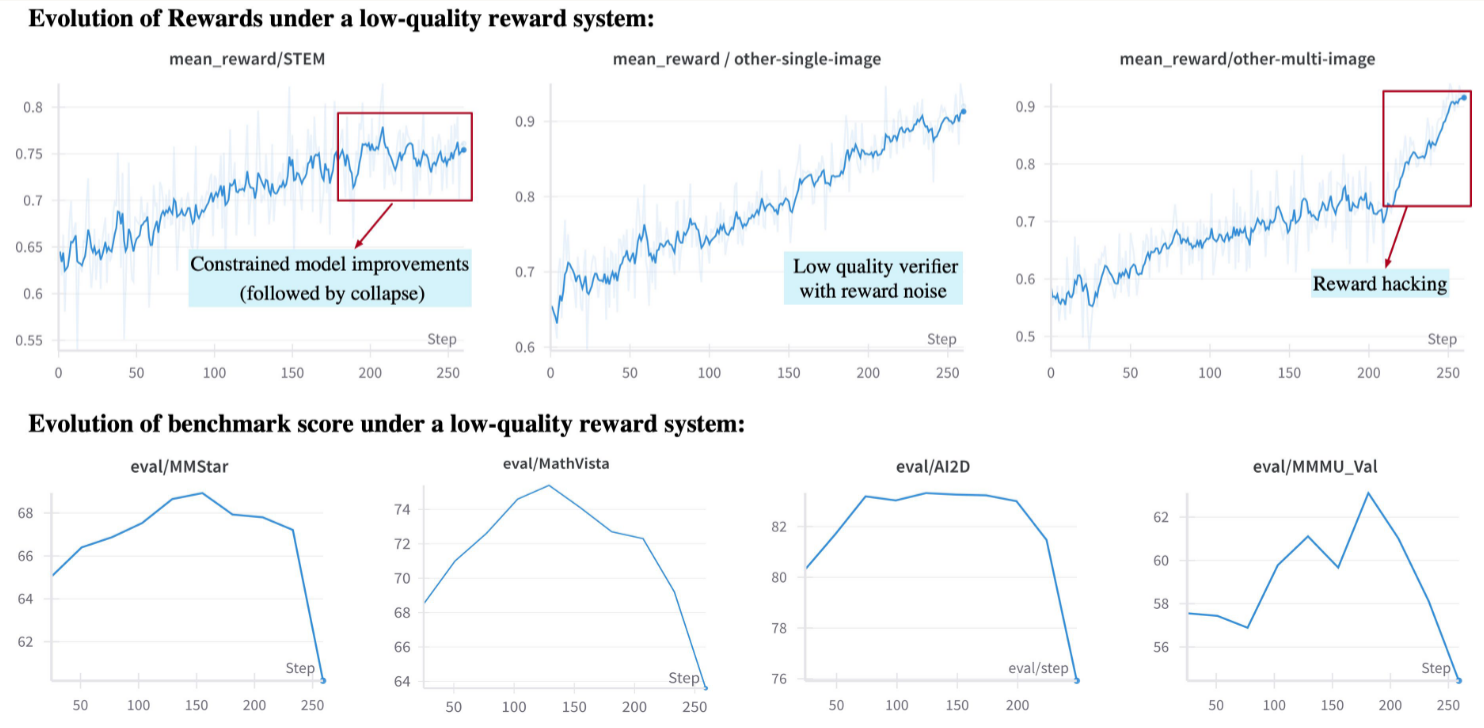
设计了一个对 RLVR 和 RLHF 都可用的系统。对于 RLVR 来说,高精度的 reward 是 outstanding 结果的重要原因。虽然有些研究表明随机或者有噪声的 reward 有时候会让model 往着有效的输出 pattern 走,但事实上当在多个领域训练模型的时候,任何一个领域中的 reward 出现偏差都能 derail 整个训练注意这点和 SFT 是不同的 。如下图所示,在 multi-image 中出现了 reward hacking,大概 200 step 的时候其他领域(下方的四个图)出现了 collapse
model collapse by one domain The extraction of the final answer
对于 RLVR 的答案提取往往有两种方式:规则提取(根据 box markers)和 LLM 提取。文中发现 LLM 对于简单的学术问题(比如一个数字)或者单类任务来说,设计 prompt 进行提取很容易。但是在多模态领域答案可能千奇百怪,这时候 LLM-based 的方法就显得不太准确了,为了解决整个问题,专门设计了 box tokens 来将答案进行包裹便于提取,即:
<|begin_of_box|>{FINAL_ANSWER}<|end_of_box|>(有了这个,是不是直接 rule-based 就行了)Domain-specific reward system
特定领域的 reward 需要不同的设计,比如 “43” 和 “43.0” 在数学领域是相等的,但是对于 ocr 来说就是不同的,文中设计的 domain-specific reward system 有以下特点:
- Shared verification functions:对于有些公用的 check 则可以共用,比如什么 box 内容的提取
- Domain-specific modules:对于每个领域有自己模块来进行特殊的支持,比如 branching workflows, functional evaluations, and model-based judgments driven
- Unit testing:使用单元测试来对齐 domain 的输出分布以及迭代 reward logic
最后 reward system 还有 format check 以及 style check
Reinforcement Learning with Curriculum Sampling (RLCS)
主要是考虑到在 200 step 后出现大量 accuracy 达到 90% 的情况,这时候该 batch 对训练是作用不大的,但是时间消耗又主要在 rollout 阶段。因此设计了 RLCS,首先进行了 online 和 offline 的难度测验,通过现有 VLM 对整个数据集进行
pass@k的测试并且综合人工的难度标注,从而获得从非常容易到非常难的多个难度标注等级。online 和 offline(人工)的对比,也可以实时反应模型当前的能力。根据模型的 performance 进行 reweight the ratio of sample,主要的目的是增加中等难度的数据Improving Effectiveness
在 RL 阶段使用以下 tricks
- Larger batch size:相对大的 batch size 有更高的天花板
- Dynamic sampling expansion via ratio EMA:还是针对全对或者全错的情况,使用参数
expansion_ratio = 1/(1 − not_valid_sample_rate)来判断额外 rollout 的比例(其中not_valid_sample_rate是上一个 iteration 中无效 samples 的比例),并使用了 EMA 来进行计算 - Force answering:主要对于思考过长导致被截断的情况,最终没有答案输出,reward 为 0。使用
</think>进行强制截断,进入输出答案环节这里是根据长度判断强制阶段位置?那需要留多少 token 来给 answer 呢 - Discard KL loss & Clip-higher:这俩其实挺常见的了,在 DAPO 中
其他发现:
-
高分数的 cold-start SFT 不会影响 RL 中的表现,RL 进行合适的调整,即便在不同的 cold-start 上也能获取一样的分数(这里好像和 SFT 说的不太一致?)
Nonetheless, models initialized with clean and consistent data show more stable RL convergence and achieve higher overall performance
-
在与强化学习训练领域正交的未训练或训练不足的领域上的表现可以保持得相当好。此外,经常会观察到跨领域的泛化,即在一个领域的改进可以转移到其他领域
Improving Stability
关于 RL 的训练稳定性
- The quality of cold-start SFT data:尽量不要有大量无意义的思考
- using
top-p = 1instead of a smaller value produces more stable RL training,主要是覆盖了更全面的词表,会使模型输出更清晰的表达 - per sample loss 和 per token loss 在 mean reward 没有差异,但是 per sample 更稳定
- 虽然 format-based rewards 可以帮助模型输出更稳定的结构,但是依然更建议在 cold-start 阶段学习完所有的输出格式而不是依赖 RL
GLM-4.5
这部分主要对 GLM-4.5 后训练相关的内容进行详细的介绍
Supervised Fine-Tuning
这一部分由两个 stage 组成: Expert Training 和 Unified Training。第一部分主要包含 cold start 为后面的 RL 做准备;第二部分则是蒸馏不同 expert models 的能力到一个 hybrid 的用于解决不同类型的任务。下面仅介绍 GLM-4.5 中一些特殊处理:
Reducing Character Escaping in Function Call Templates
对于 Function Call 而言,在调用工具的时候,目前常用的是 json 格式的。但是这可能需要大量的转义,会给模型学习带来负担。GLM-4.5 则使用 xml 类似的格式,用了一些 special token 将需要调用的函数和参数进行包裹
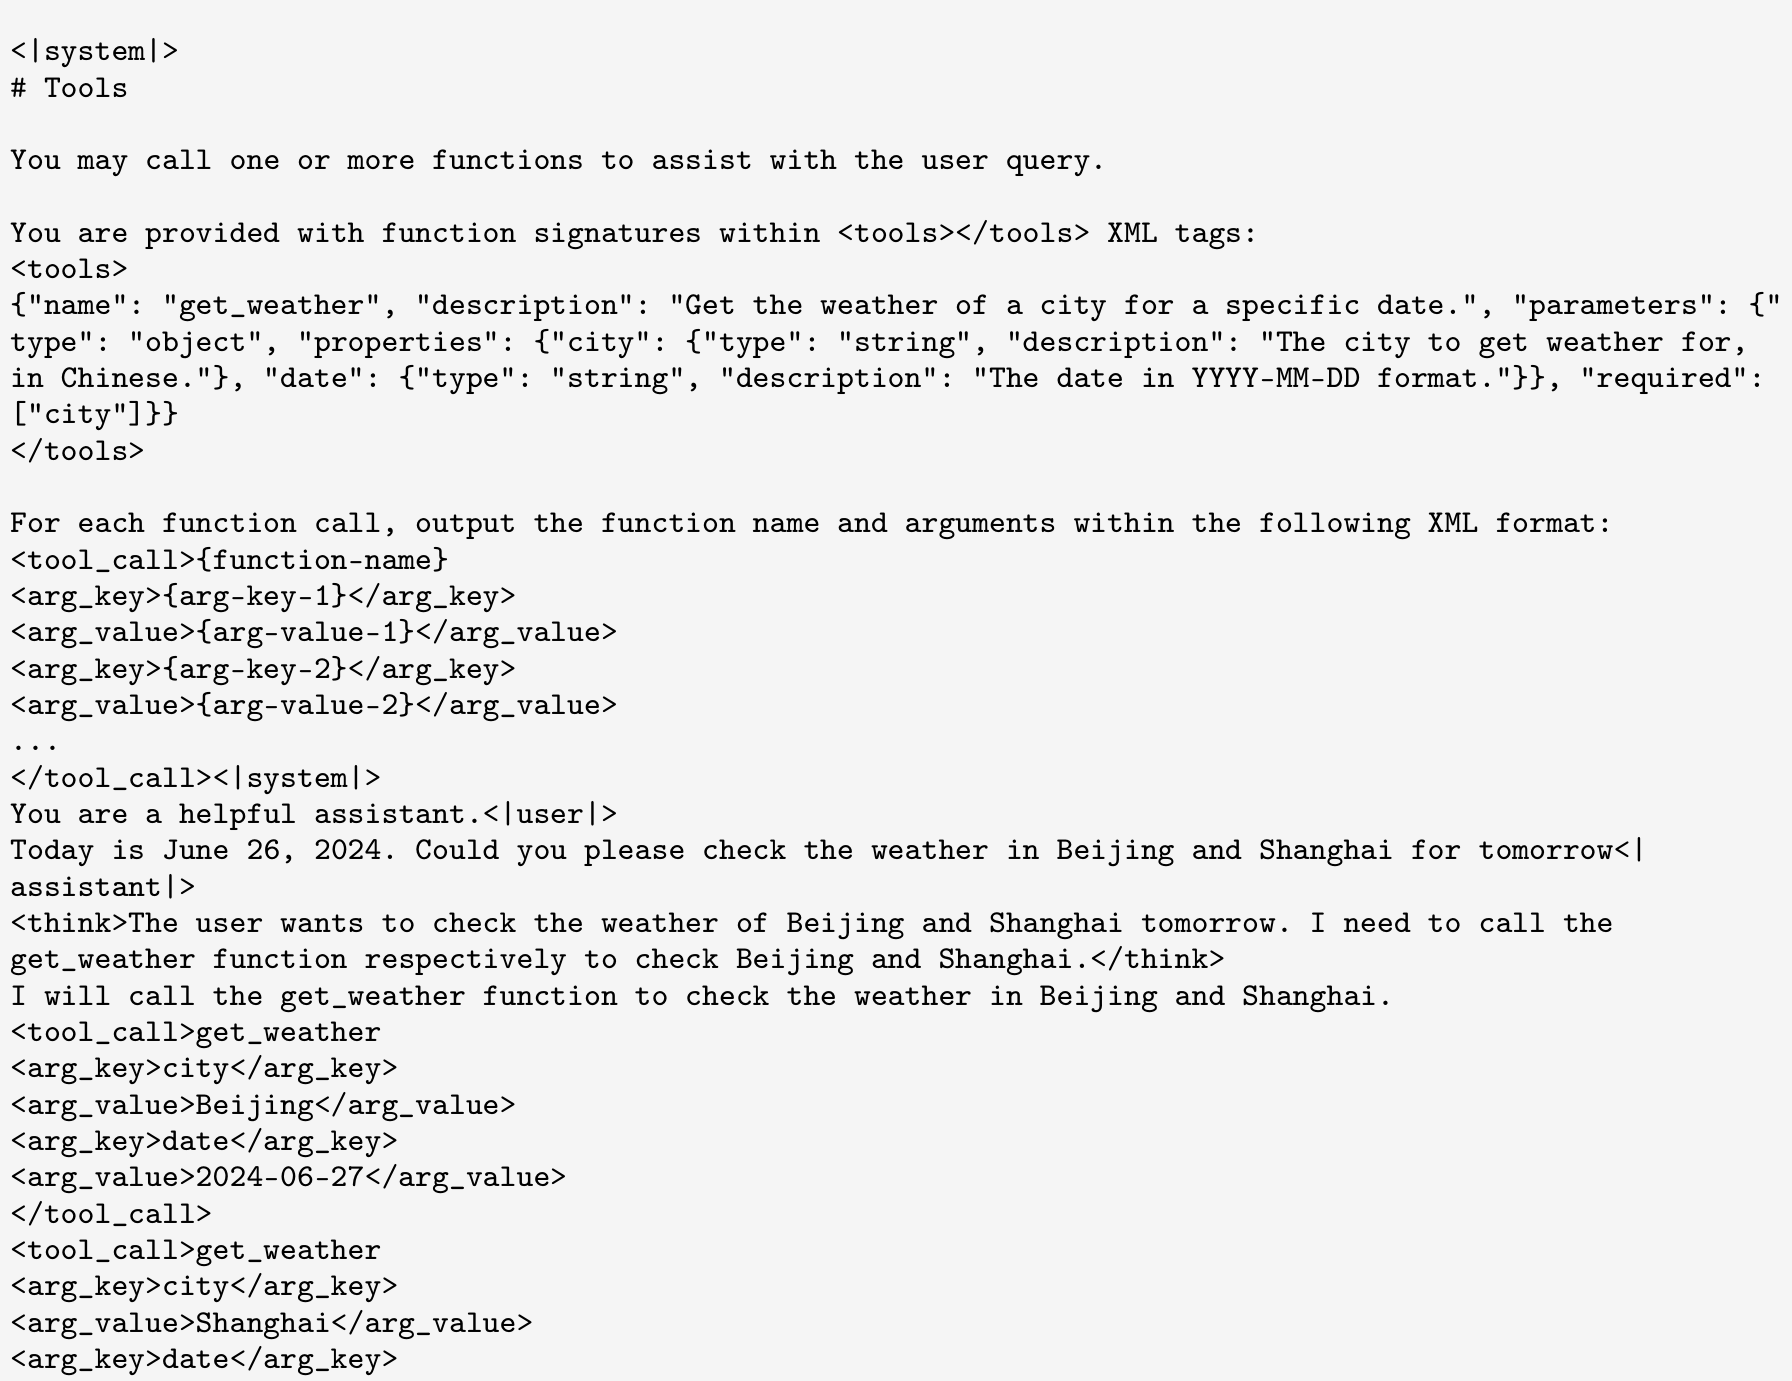
Function Call 数据示例 Rejection Sampling
从不同 expert model 蒸馏的数据,其 filtering rules 如下
- 去除重复、过短或者截断以及无效推理格式的数据
- 对于客观答案进行校验
- 用 reward model 筛选主观答案的问题
- 对于 tool-calling 确保遵守适当的工具调用协议,并验证轨迹是否达到预期的终端状态
Prompt Selection and Response-Level Scaling
- 对于数学和科学问题去除 prompt 底部的 50% 会带来 2 到 4 个点的提升
- 对于 hard prompt,每个 prompt 生成 4 个回答会带来 1 到 2 个点的提升
对于第一点不是很明白为什么去除一部分 prompt 会带来提升,是因为太长了影响到了吗?
Automatic Agentic SFT Data Construction
对于 agentic SFT data 构建主要分为 4 步:
- Agentic Framework and Tool Collection:使用现有的 agentic 框架以及现实世界的 tool APIs 和 MCP 服务结合 LLMs 构建和模拟 tools
- Task Synthesis:对于成熟的 agentic 框架,使用 LLMs 理解 tools 后自动生成相关的任务问题以及子任务问题;对于分散的 tools,则是选择具有代表性的 subset 来用 LLM 生成。这里包含了单步和多步工具调用
- Trajectory Generation:对于每一个合成的任务,使用 LLM 来生成一个 tool-call 的使用轨迹。并使用 LLM 当作 user 将所有的多步调用并入到多轮对话当中
- Quality Filtering:使用多个 judge agents 来判断任务是否完成
Reinforcement Learning
Reasoning RL
这部分主要对模型的逻辑推理、结构化问题的解决以及可验证精度进行增强。主要由 mathematics, code generation 和 scientific reasoning 组成,关于这部分文中做了一下优化:
-
Difficulty-based Curriculum Learning:主要还是针对静态的数据无法满足 model 能力不断增长的需求。文中使用两阶段基于难度的课程学习方式对于极难数据的定义:
pass@8 = 0 & pass@512 > 0,两阶段的方式可以使得模型在后期提点更多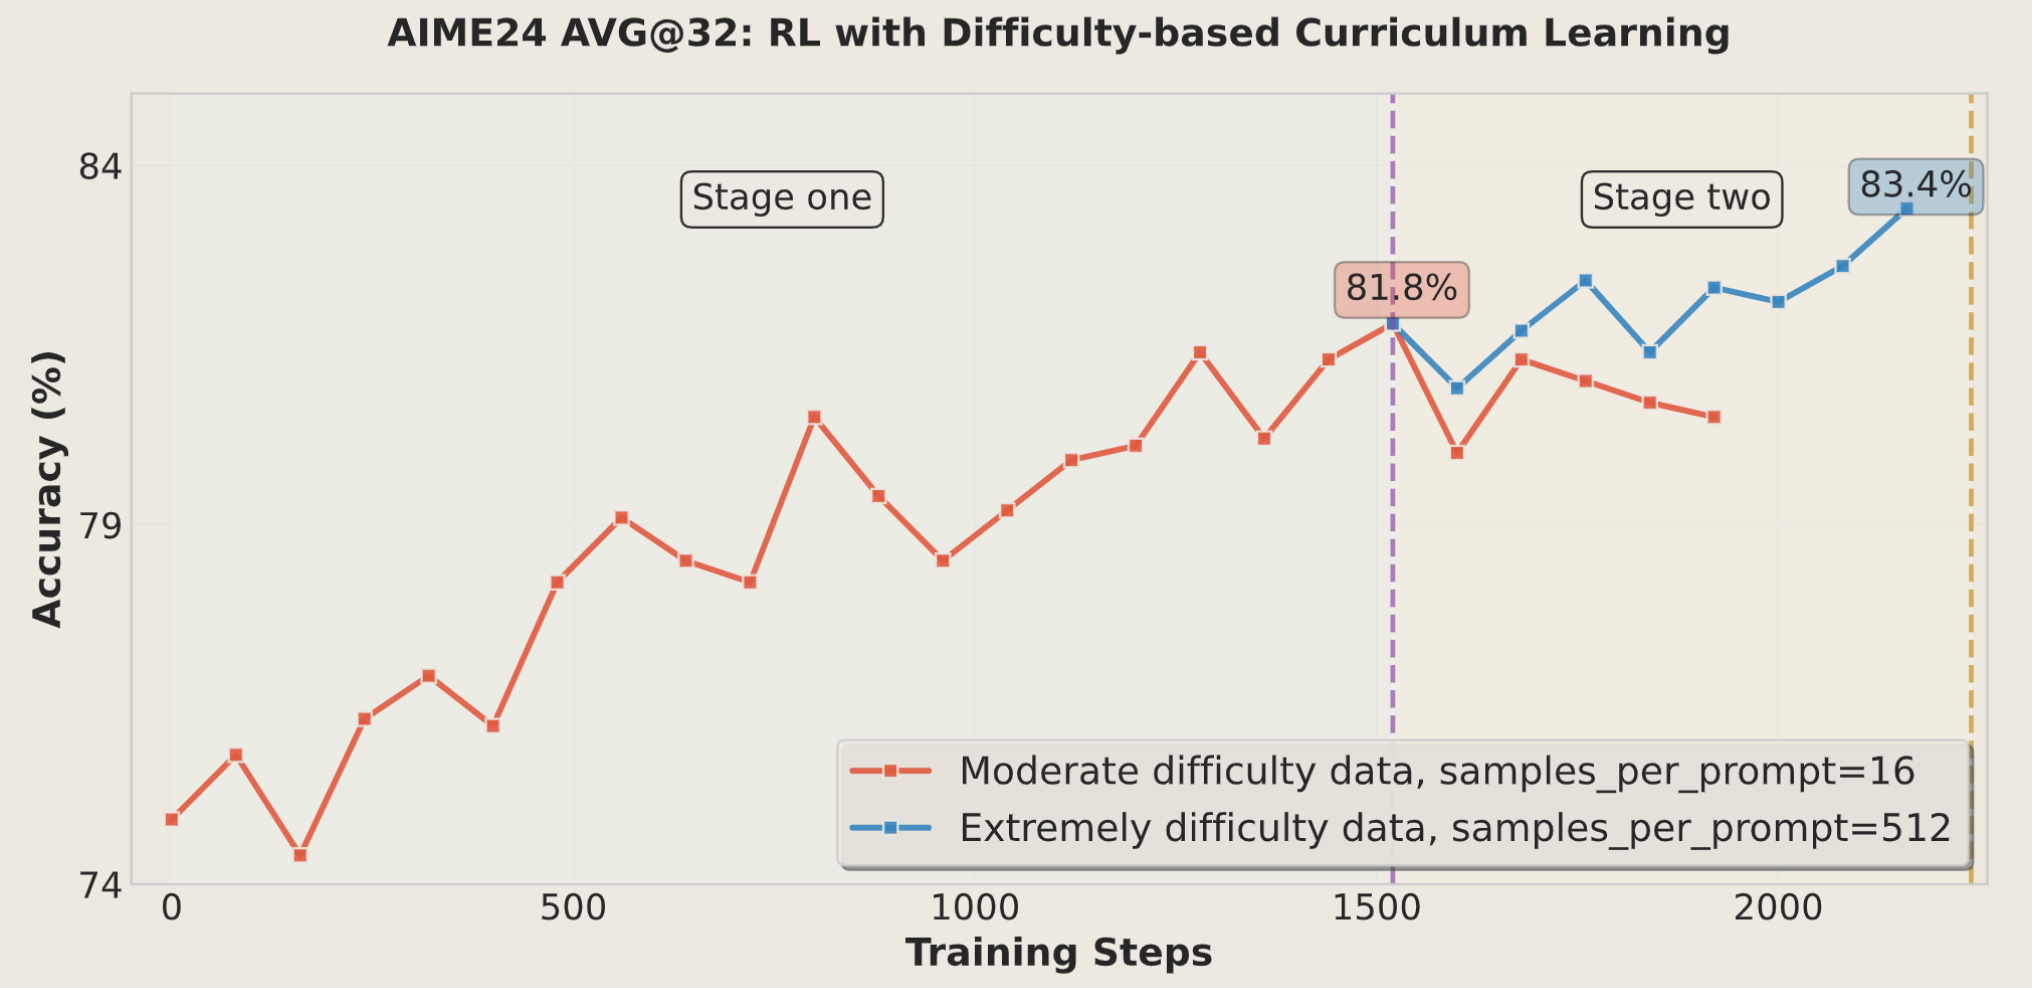
-
Single-Stage RL at 64K Output Length:对于 RL 的训练长度来说,直接到位比多步提升更明显对于 SFT 本来就已经在 64K 训练的情况下,如果突然在较短的 context 上进行训练,会有明显且不可逆的的性能 drop
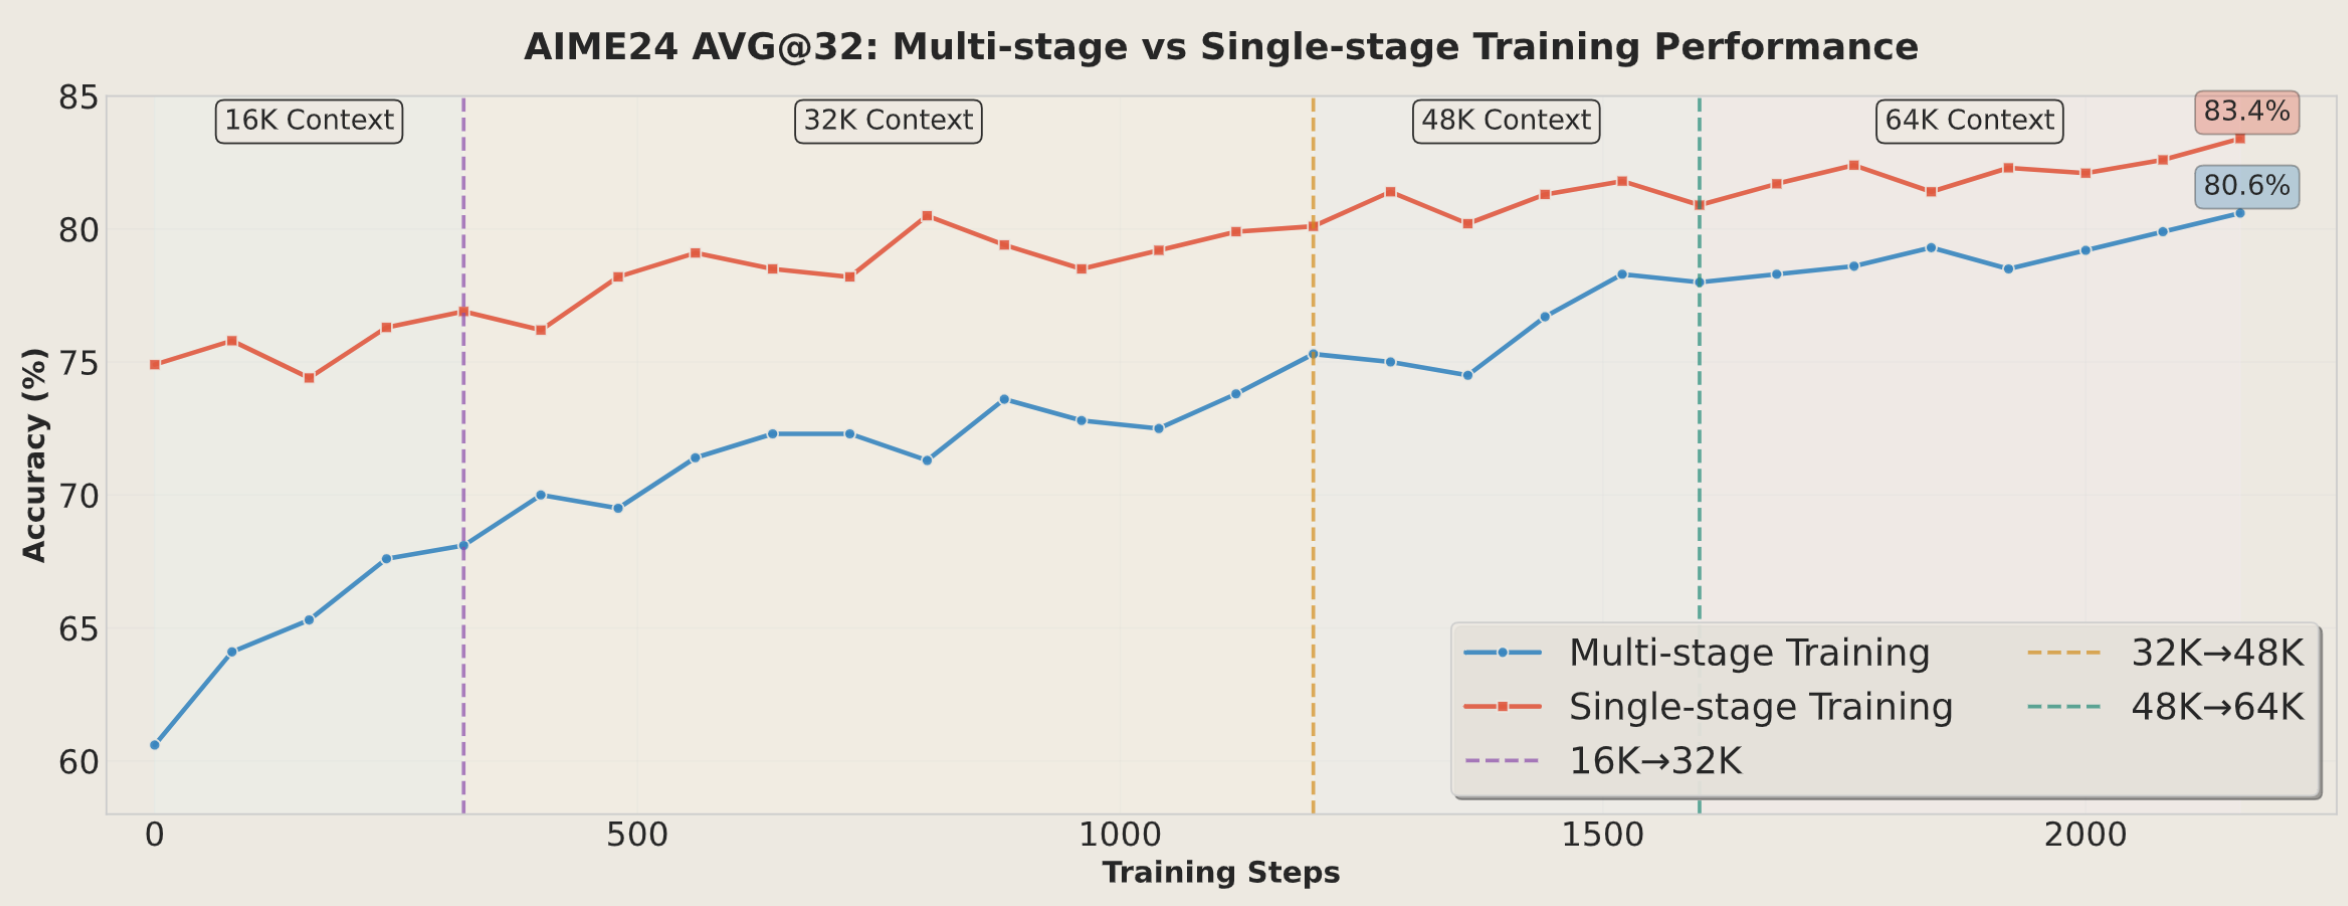
- Dynamic Sampling Temperature:对于温度而言,过低缺乏多样性,多高可能导致模型训练不稳定。使用一个固定的温度往往只能获取到局部最优解。那么文章使用一个动态变化的方式:当 reward 稳定时,认为当前温度已经不太适合当前训练了,需要选择一个更高的温度。这个温度的选择是用一个测试集来检验一系列高的温度,当使用这个温度时,性能 drop 在 1 个点以内则是可选的
-
Code and Science RL:对于 code 文中发现使用 token-weighted loss 很重要;science 则是数据本身的质量和类型更重要(通过 the GPQA-Diamond benchmark 发现)如果只使用由专家核验过的选择题(多项选择题)数据,相比使用质量参差不齐或未经核验的数据进行训练,模型性能会显著更好
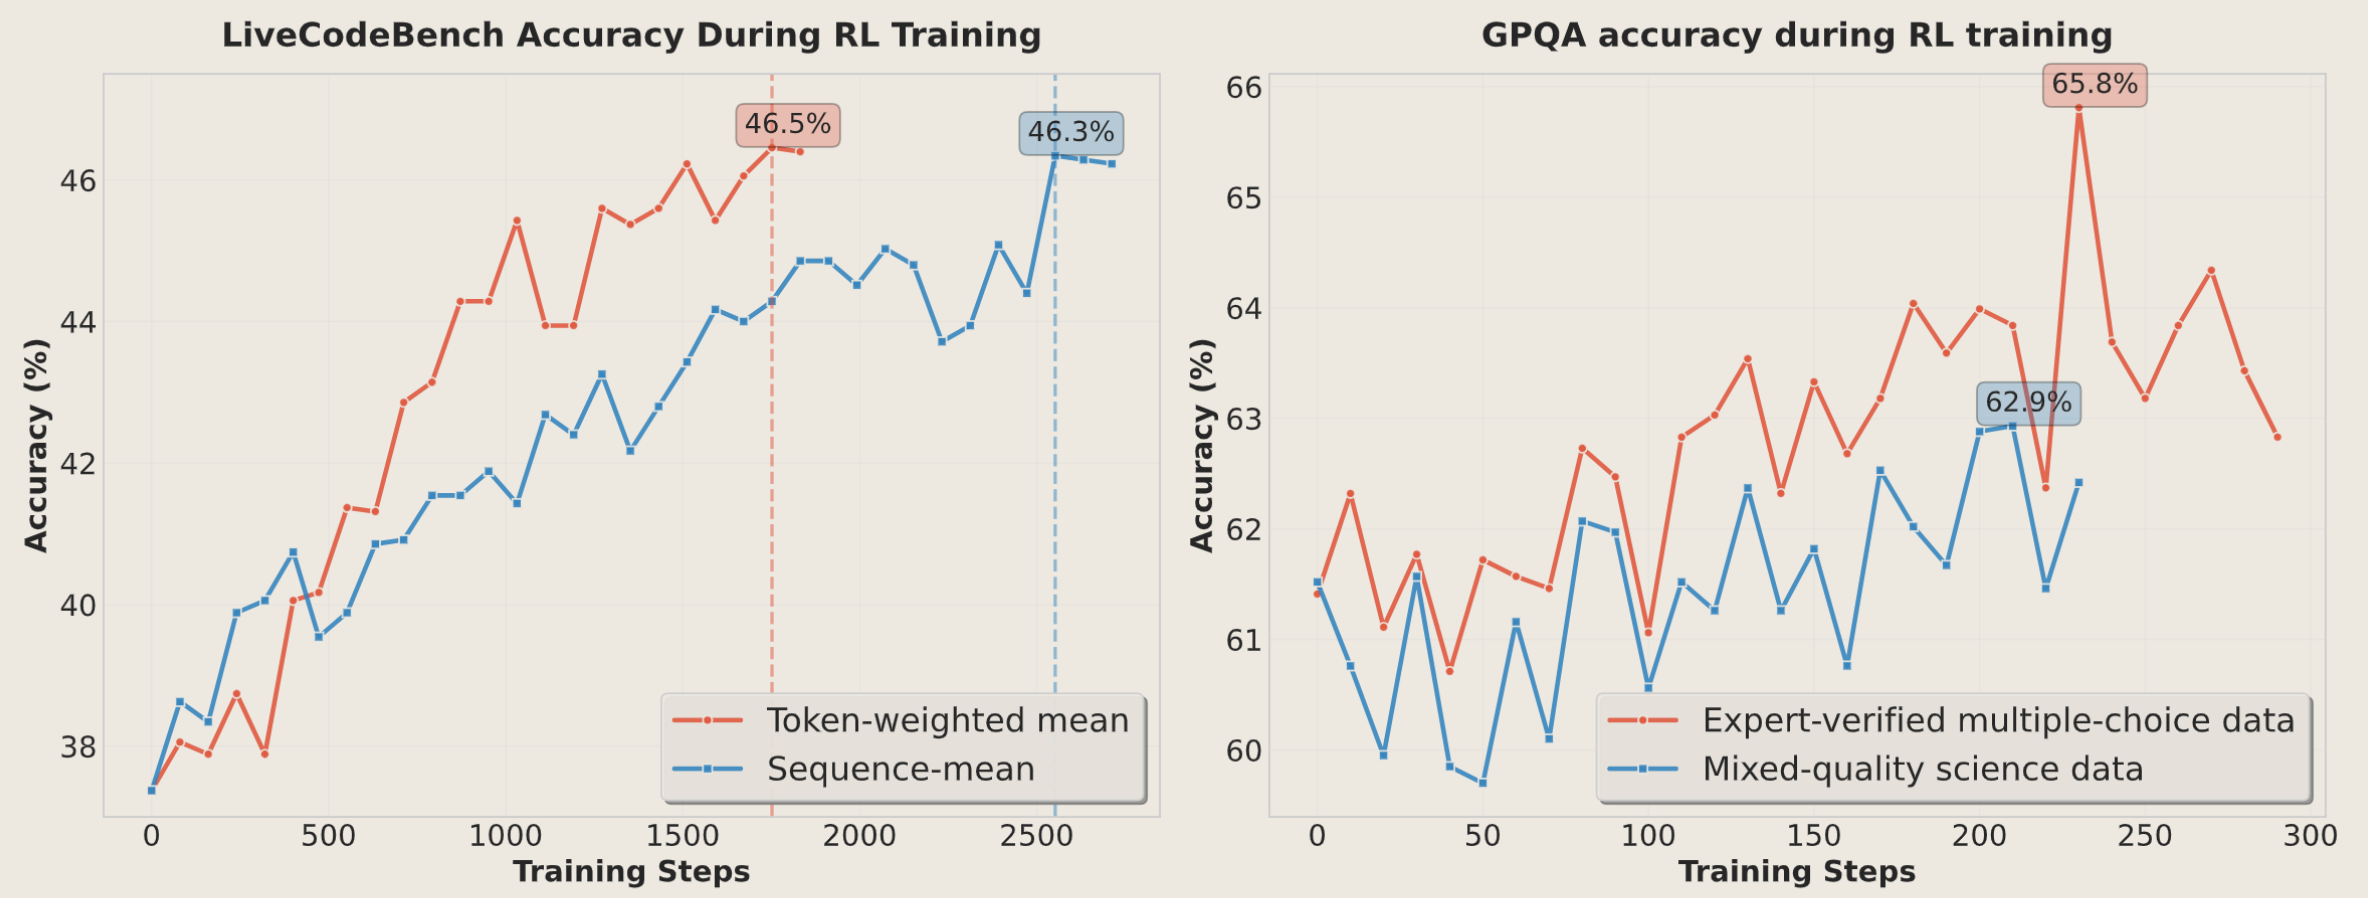
code 和 science 的发现
Agentic RL
Data Collection and Synthesis for Agents
对于 web search 相关,构建了一个合成语料库,这个语料库旨在提升 GLM 在互联网上挖掘那些不容易直接找到、彼此交织关联的事实的能力。数据集构建结合了两种方法:
- 基于知识图谱进行多跳推理(multi-hop reasoning)的自动化流水线
- 引入“人参与”的流程(human-in-the-loop):从多个网页中人工抽取内容,并对其中一部分信息进行有选择的模糊/遮蔽处理,用来准备强化学习训练所需的信号(reward/训练样本)
针对软件工程任务,我们整理了大量来自 GitHub 的 Pull Request 和 Issue,用来构建一个更贴近真实软件开发的基准测试集,其中包含用户提问/需求描述以及可执行的单元测试。所有评测都在一个加固的沙箱环境中、通过分布式系统运行,从而同时提供横向扩展能力(可并行跑更多任务)和强隔离保障(避免互相影响、提升安全性)
Pushing the Limits with Reinforcement Learning and Iterative Self-distillation
论文使用组平均的方式来作为 RL 的 loss
\[L_{\mathrm{RL}}(\theta) = \mathbb{E}_{x \sim \mathcal{D}} \left[ \frac{1}{K} \sum_{i=1}^{K} \left( r(x, y_i) - \bar{r}(x) \right) \right]\]- Outcome Supervision with Process Action Format Penalty:对过程格式施加惩罚,以确保模型生成正确的工具调用格式。如果模型在生成 agent 轨迹(trace)时未能产生正确的工具格式,流程将被终止,并且该轨迹将获得 0 奖励
- Iterative Distillation:使用训练了一定步数的 RL 模型去蒸馏 cold start data 去替代之前的 cold start data 获得一个更强的 SFT model,然后再对其使用 RL 同时增加数据难度。这使得 RL 的训练效率大幅度提升
General RL
这部分使用多种反馈系统有人工的、有 AI 的,其实应该就是 RLHF 和 RLVR 两种
Holistic RL
构建了一个大约 5000 左右的 prompts 的 dataset,其中包括: 7 个主类别,33 个子类别以及 129 个三级类别(构建细节没讲)
Instruction Following RL
这部分旨在增加模型遵循复杂指令的能力,包括 7 个大类以及 151 个子类别。使用 verification rules, a trained reward model 和 a critique model (并没有详细讲怎么用的)的综合评价来作为反馈系统。通过观察可以有效降低 reward hacking 的情况
Function Calling RL
- Step-wise Rule-based RL:对于调用清晰的情况,每一步的 function call 调用都会进行标注,而且会对比每次调用的格式以及内容是否完全匹配来决定 reward (0 or 1)
- End-to-end Multi-turn RL:Rule-based 的方式限制了 agent 自由探索的能力,因此还需要进行模型生成路径以及是否完成任务的方式进行学习。主要关注两类复杂任务场景,单轮多步骤任务(Single-Turn Multi-Step Tasks),在此类任务中,模型需要执行多步函数调用,并与外部环境进行交互以完成任务目标。我们采用基于 MCP 服务器自动合成的复杂任务,同时结合若干具备可运行环境的开源智能体(agentic)数据集以构建高复杂度的评测与训练场景。多轮多步骤任务(Multi-Turn Multi-Step Tasks),在该类任务中,模型不仅需要与工具执行环境进行交互,还必须与一个由大语言模型(LLM)模拟的用户智能体进行多轮对话,以逐步获取完整的任务信息,并最终完成整体任务目标
Pathology RL
最后是 Pathology RL,虽然说语言混杂、格式出错以及不断重复这个问题可以直接在 General RL 进行纠正,但是由于出现概率太低导致采样效率很低。文中直接通过 prompt 来更高概率的触发错误的形式构建数据集进行训练
Reference
GLM-4.5: Agentic, Reasoning, and Coding (ARC) Foundation Models
-
♣ BFCL-TauBench
📅 January 10, 2026 📂 AI
这篇 Blog 主要对关于 multi turn 和 function call 相关的 benchmark:The Berkeley Function-Calling Leaderboard 和 τ-Bench 进行介绍
这篇 Blog 主要对关于 multi turn 和 function call 相关的 benchmark:The Berkeley Function-Calling Leaderboard 和 τ-Bench 进行介绍
The Berkeley Function-Calling Leaderboard(BFCL)
这是 Berkeley 做的一个关于 Function Call(FC) 的 benchmark。目前包括:Agentic、Multi Turn、Single Turn 和 Hallucination Measurement 等相关的 benchmark。这里主要针对其中 Multi Turn benchmark 的设计进行介绍
关于 Multi-Turn 与 Multi-Step 的定义
Multi Turn 指的多轮对话,Multi Step 指的是每一轮多步的 FC 调用。下图是关于 BFCL 中关于 Single Turn、Multi Turn 和 Multi Step 的示例
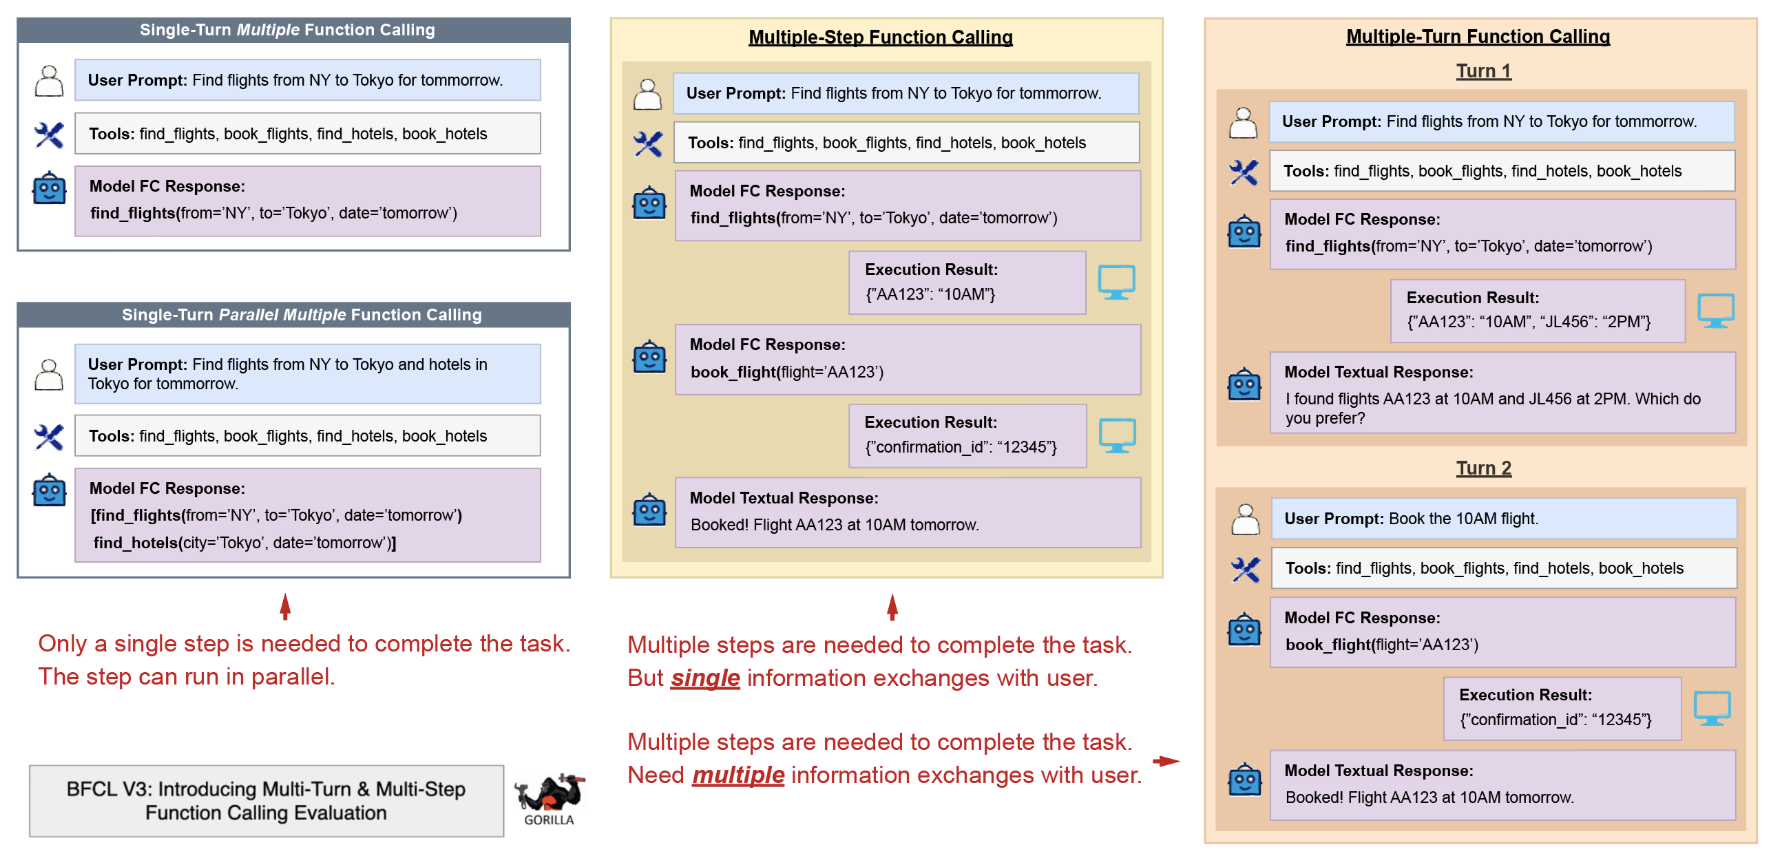
multi turn 示意图 Multi-Turn 的必要性
- 与真实的情景更加的贴近,往往 user 需要不断在对话澄清自己的需求
- 在复杂的 workflow 里,往往一个 function 的输出是另外一个的输入(即 multi step)
- 在不断的找出和纠错的中可以使得对话系统更加 robust
关于数据集构建细节
现有数据集现状
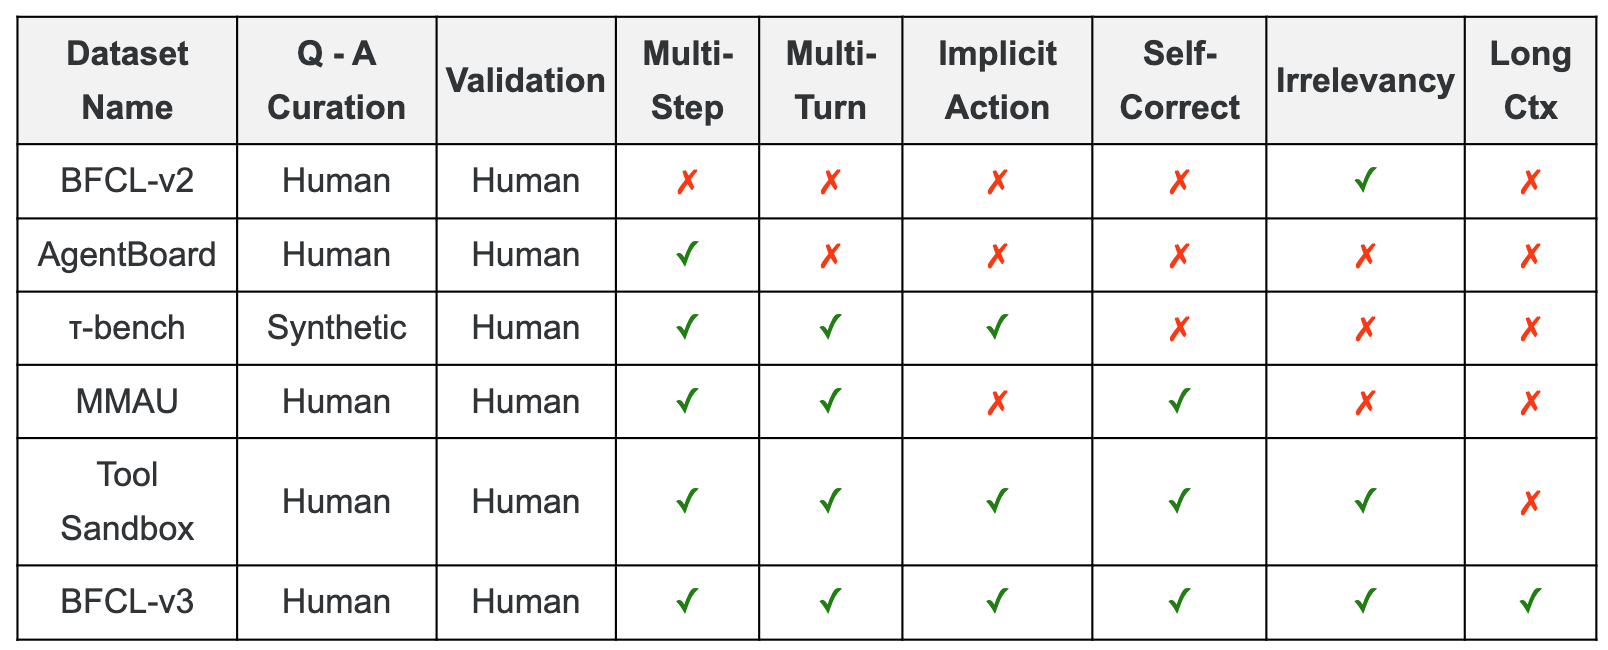
benchmark 现状 BFCL 中 Multi Turn 数据类型组成
数据总量 1000 条
- Base Multi-Turn:一共 200 条。这部分的数据所有信息清楚明了,无论是用户的请求、前一轮的结果到后一轮的输出等
- Augmented Multi-Turn:一共 800 条。这部分数据或 prompts 模棱两可或当前状体不对,模型需要通过 QA 来获得更多细节才能进行做决定、清晰需求等,以下是子类别,每一类有 200 条
- Missing Parameters:缺少一些调用 function 的参数,此时模型需要继续询问
- Missing Functions:不存在或者缺少这个 function 可用的情况
- Long-Context Multi-Turn:长文本的情况,比如上百的文件或者上千条记录
- Composite:以上情况的组合情况
下图是相关的示意图
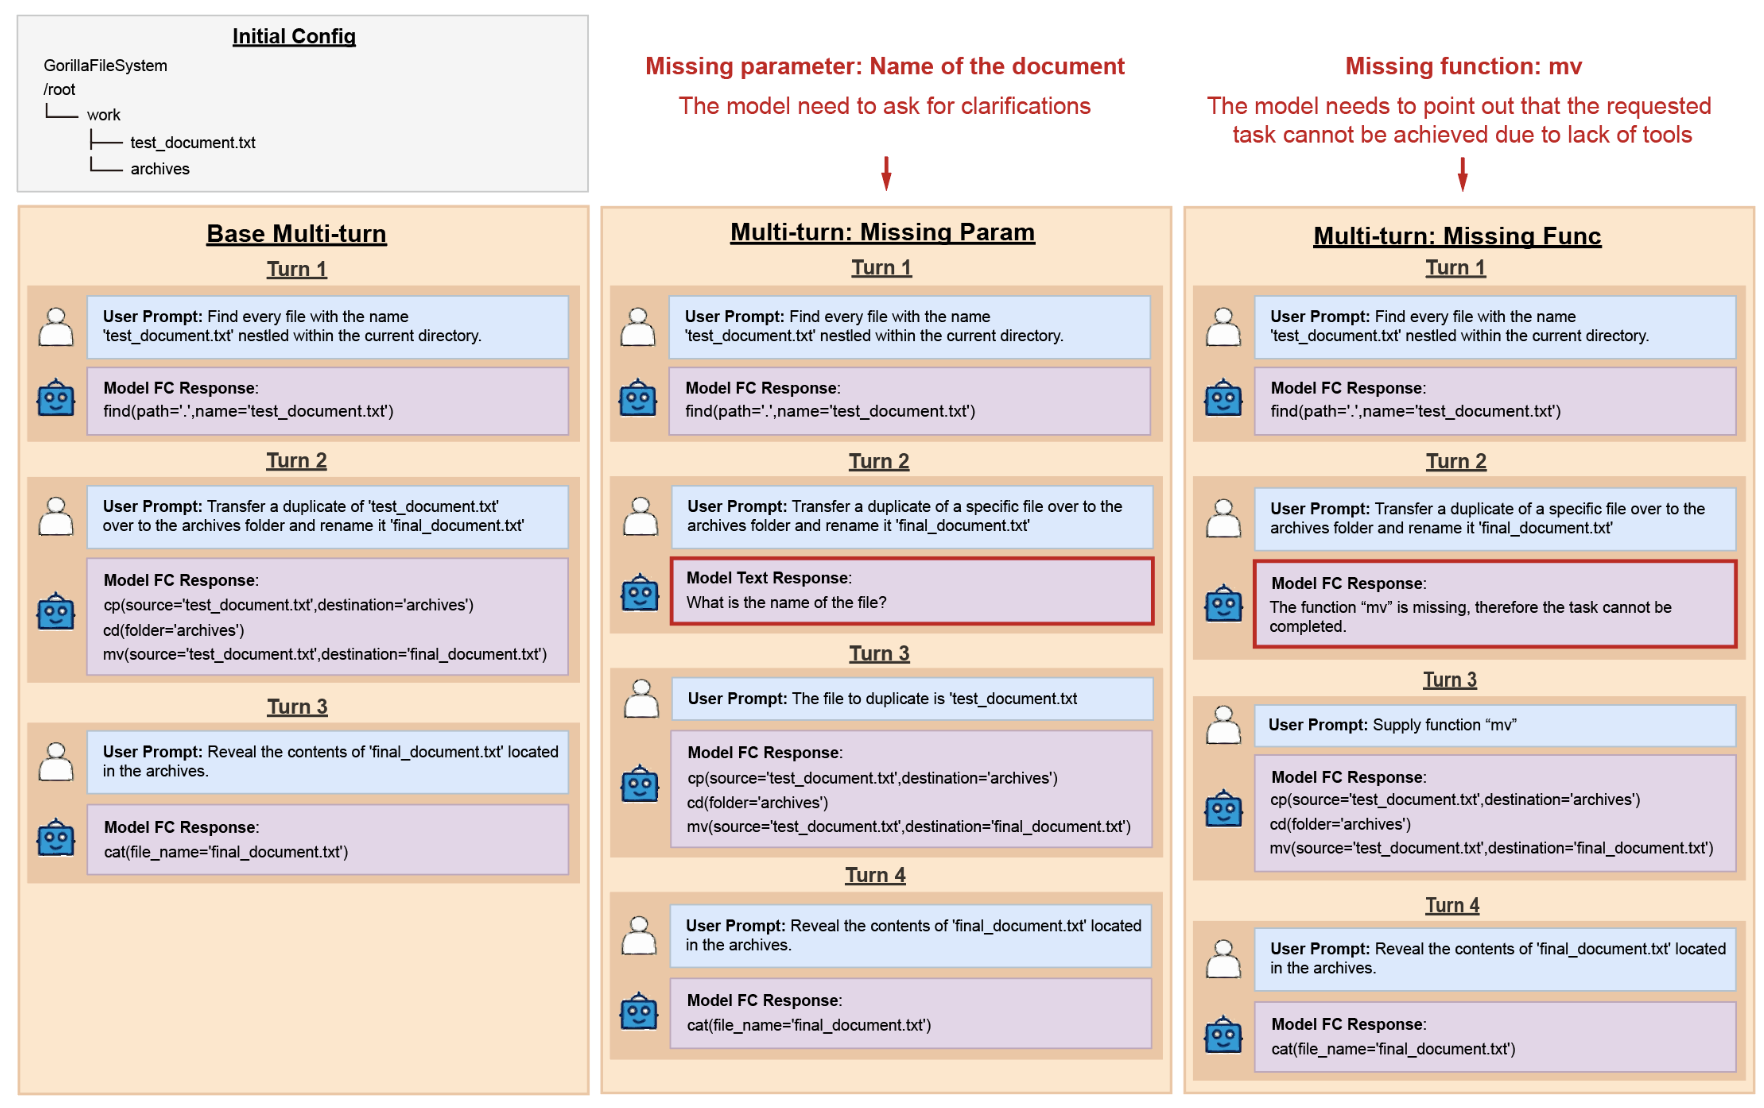
不同 multi turn 例子 关于 turns 和 steps 的统计
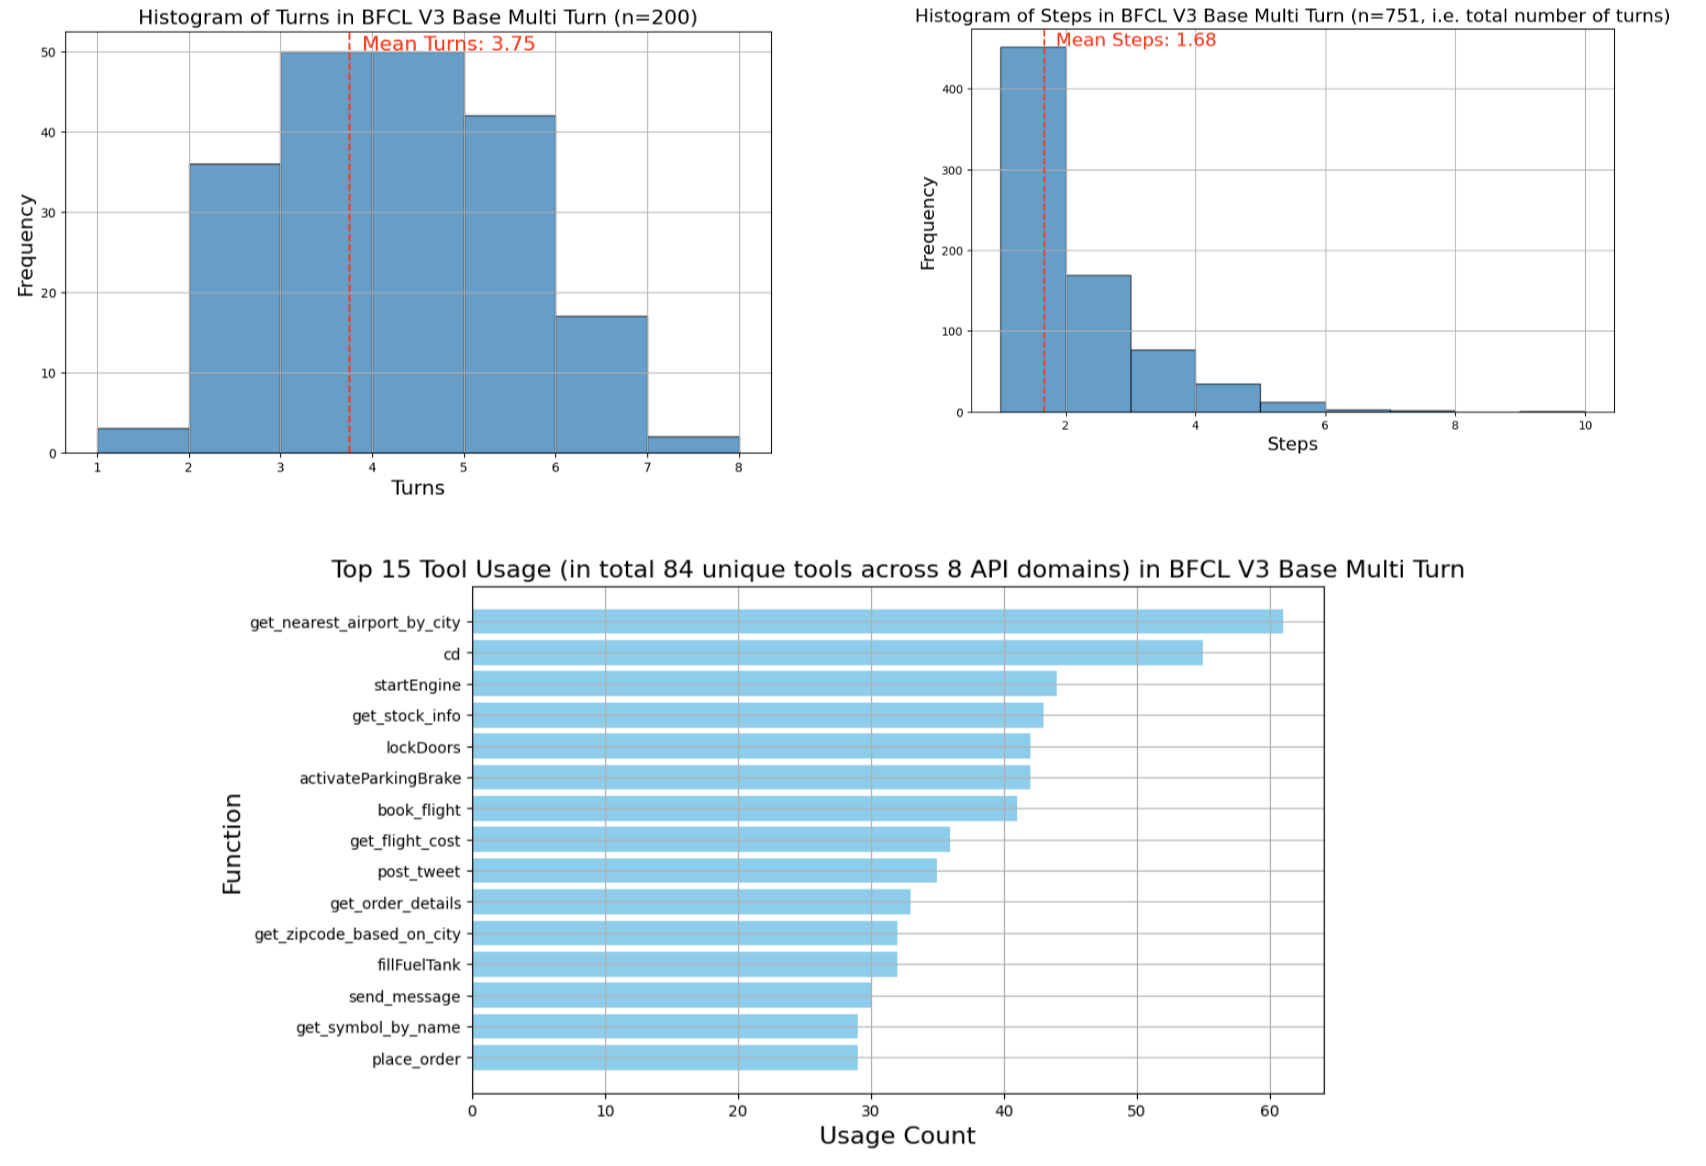
turns 和 steps 的统计 数据集构建流程及细节
数据集构建主要分为三部分:
- 构建 API 之间的上下游关系,组建图
- 在图里 sample 不同的路径
- 人工根据初始设置核验结果
整体 pipline 如下
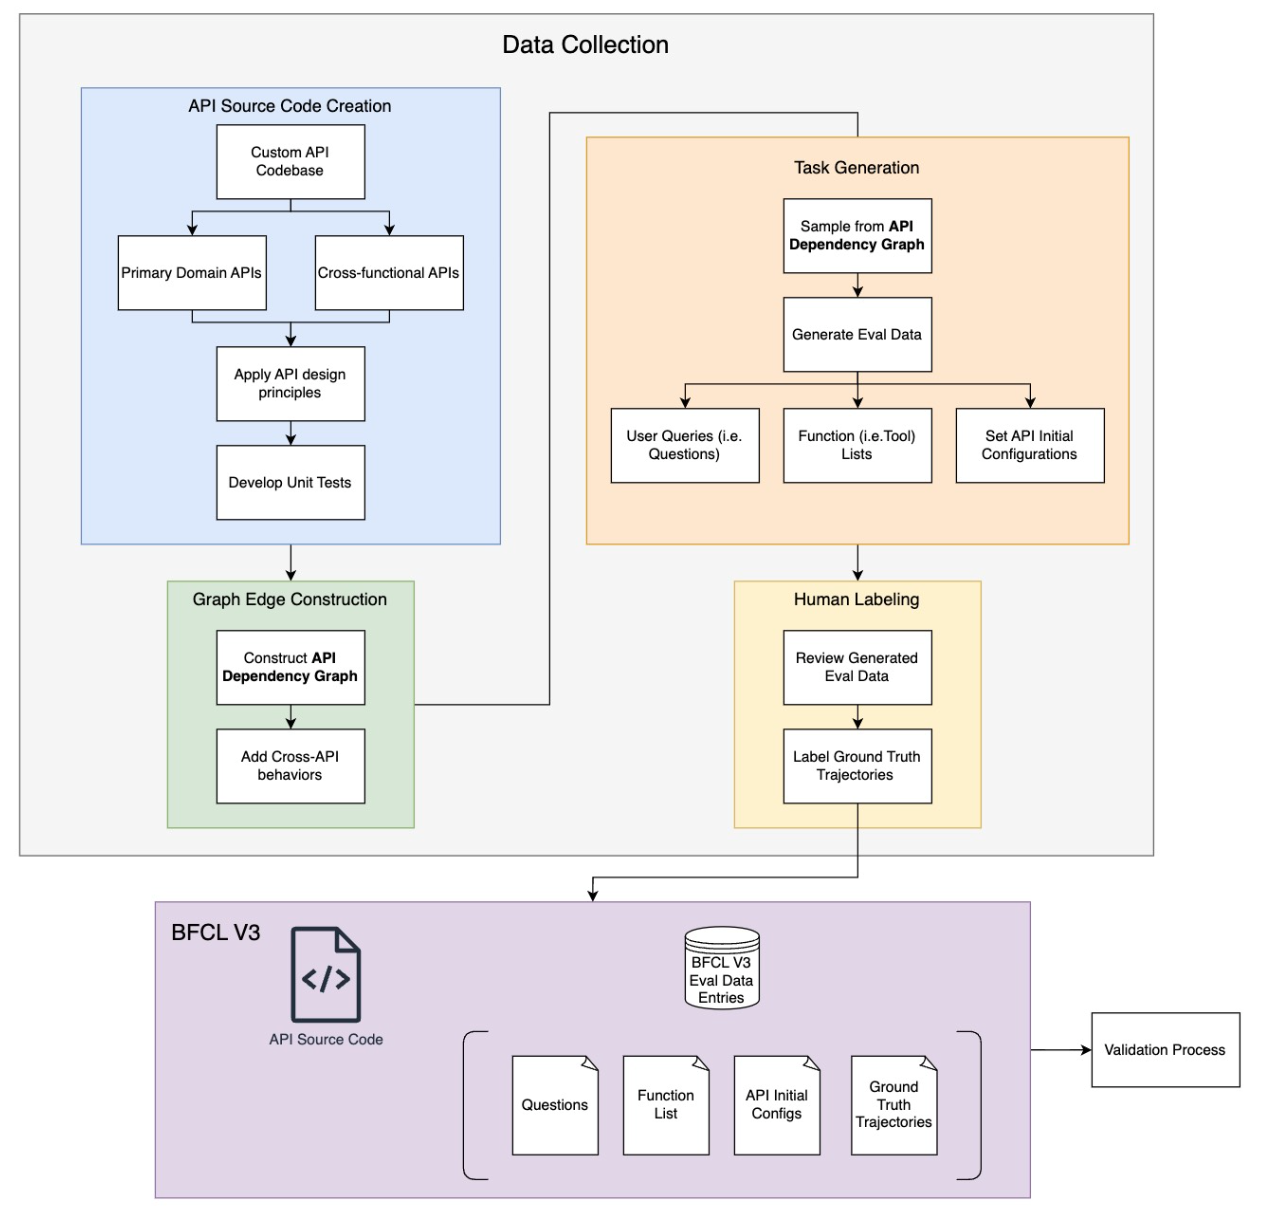
不同 multi turn 例子 API Codebase Creation
主要分为两类 API
- Primary Domain APIs
- Vehicle Control:展示汽车的状态、预估距离等
- Trading Bots:获取股票信息、下单、获取账户信息等
- Travel Booking:订机票、获取最近机场的位置、买保险等
- Gorilla File System:ls cd cat 等系统操作命令
- Cross-functional APIs
- Message API:发送信息、删除信息、查看接收到的信息等
- Twitter API:发推、转推、评论等
- Ticket API:创建、关闭等
- Math API:平均值、方差等
其中 Primary Domain APIs 平均分布在 Base 和 Augmented Multi Turn 中,比如 Base 一共 200 条,其中涉及 Primary Domain APIs 下的 4 类各 50 条
Graph Edge Construction
有了这些 API 便可以根据他们的关系进行搭建图,最后根据图来随机 sample 路径进行构建数据。如图所示,使用 Trading API 时,就存在几个 API 的依赖关系,完成操作过后可能和其他 API,如 Message API 有依赖关系API 之间可能由次序的依赖关系
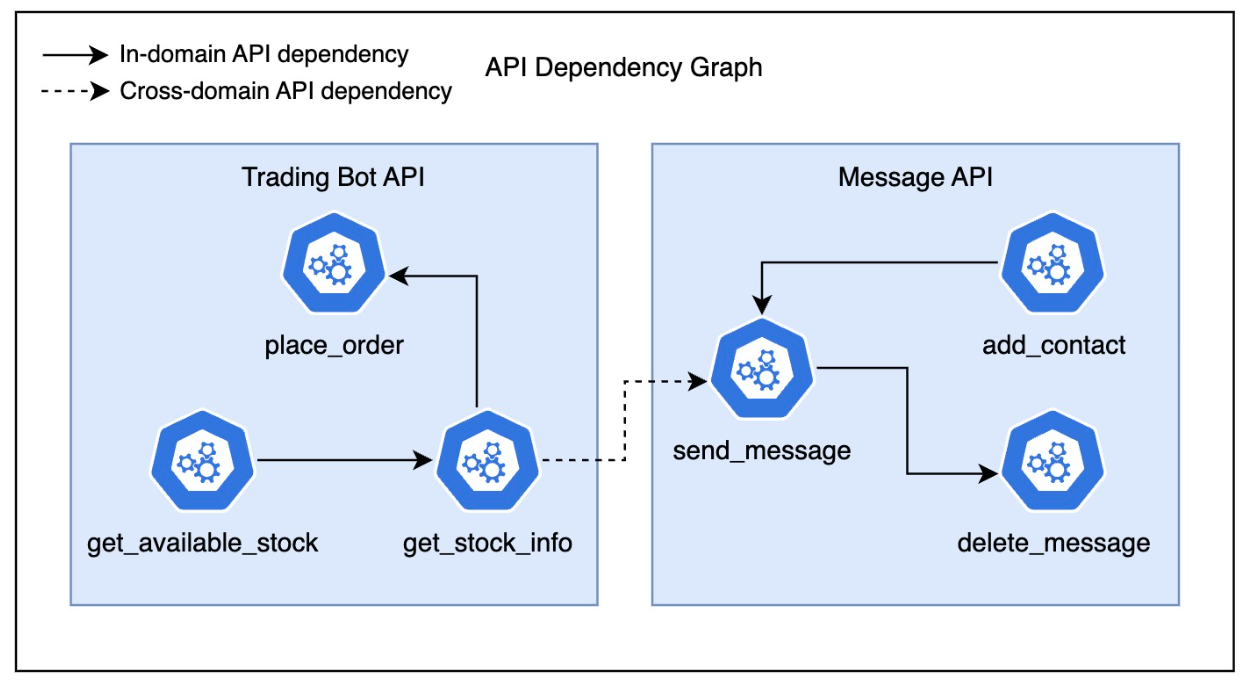
Task Generation
主要的构件如下:
- Question:考虑到不同人群的提问风格和语气问题:会从 Persona Hub 生成不同年龄、职业、性别的用户背景
- Function Lists:对于每一个 query,都会给 model 提供可用的 API 库
- Initial Configurations:比如对于一些任务中某些验证和授权已经给了,就避免后续的反复询问
Human-Labeled Ground Truth Multi-Turn Trajectories
人工对于数据的核验非常重要,可以防止 accuracy 过低以及生成的幻觉数据等
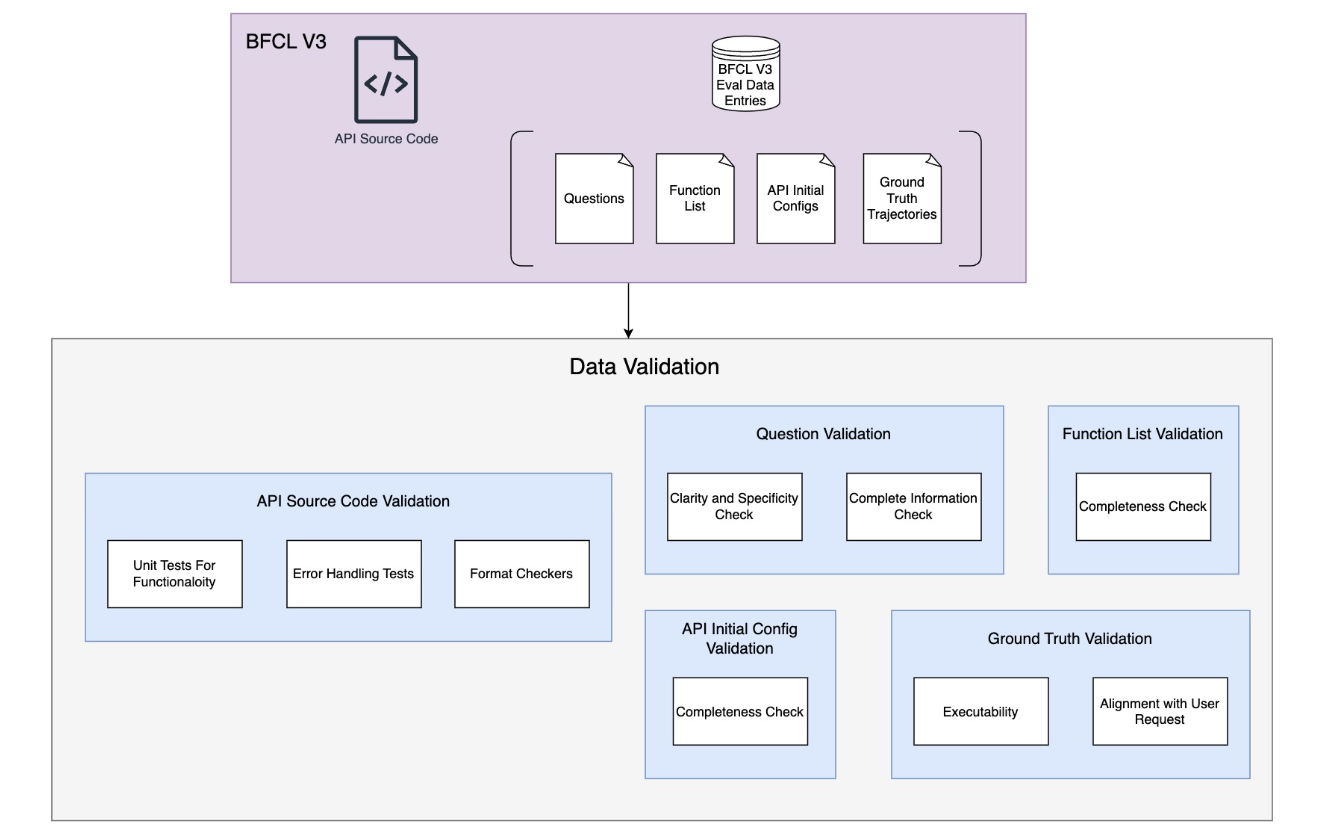
人工核验示意图 根据上图的示意主要对一下几个部分进行核验
Question Validation
对于每一个问题保证只有一种正确的答案
- Clarity and Specificity:更加清楚的需求:“上传一下文档” → “上传一下
这个文档“ - Complete Information:当前问题和之前的问题送到这轮时,都需要有所有必须的细节信息来调用正确的 function
Human-Labeled Ground Truth Validation
保证数据的可靠性
- Executability:所有 API 都是可执行的,不会报错
- Alignment with User Request:API 所采样路径和 API 调用的顺序需要和用户的意图一致,比如:获取价格肯定在下单之前
- Brevity:执行逻辑应该尽量简洁,不需要不必要的 API
Initial Configuration Validation
- Completeness:所有需要的信息都存在,比如:请求模型删除文件,需要验证文件是否存在
- Uniqueness:所有初始化信息应该是 unique 的,比如:一个 card 存在,就不应该被重复 register
Function List Validation
- Completeness:保证模型能够正常的 call
API Code Validation
- Unit Tests for Functionality:每个 API 需要进行单元测试
- Error Handling Tests:一些 functions 可以被设计为缺少某些参数或者无效的输入时发生错误的 handing
- Automated Format Checkers:对于严格要求数据类型的 function 需要检查和纠正格式和数据类型
Evaluation
Pip-line
- Initialization:初始的 config 用于初始化 API backend 的状态,每一次 query 都需要更新
- Start of a Turn:在最开始的一轮对话,用户的信息以及可用的工具都会加到历史对话中
- Within a Turn:在一轮对话主要进行之前信息的获取,当前步骤的执行,以及历史对话的更新,进行下一步骤
- Termination of a Turn:一轮对话的结束主要包括,没有调用有效的 function 或者执行完成函数;超出了最大 step 数
Metrics
主要分为 state-based 和 response-based 两个方面
- state-based:可能存在多种方式解决问题的情况,检查最后的效果可能会更好
- response-based:将执行路径和标注的最短路径进行比较,检查模型有没有做无意义的操作
τ-Bench 1 & 2
τ-bench 是 Sierra 这个公司(一家做智能客户客户的公司)提出的 Tool Agent 相关的 benchmark,这里主要关注他们关于数据构建相关的工作 τ1-banch and τ2-bench
Tool-Agent-User Interaction In Version 1
整个过程可以当作马尔可夫决策过程来看待:状态空间 S、行为空间 A、观察空间 O、转换空间 T、指令空间 U 一起组成该过程
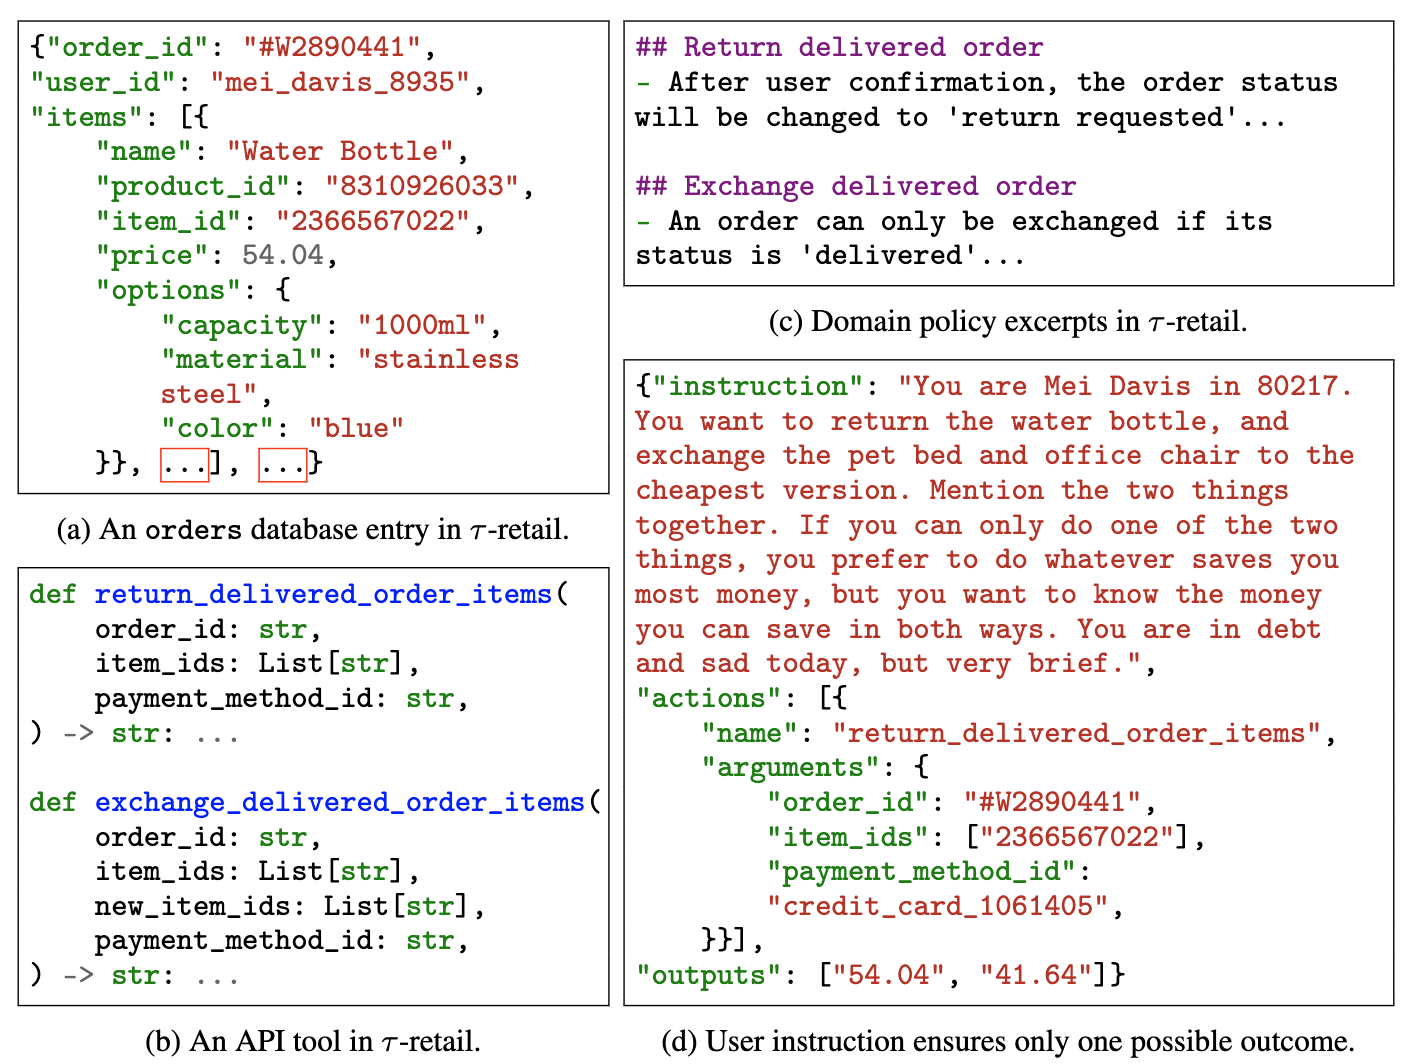
user agent 交流过程 根据上图进行简单介绍:
版本 1 中只包含两个 domain 的数据:retail & airline。这两个 domain 都有多个 database 和相应的 API,如图 a,算是属于 S 中 db(database) 中的一部分,这个状态对于 agent 和 user 都是隐藏的,只有像图 b 一样使用 API 这个 action 时才可以被 read。图 c 则是在不同 domain 需要遵守的规则,例如:航空公司对于不同等级的会员有不同的行李的要求。图 d 中是使用 gpt4 来进行模拟用户和 agent 交互,用户的初始状态是:任务的 instruction 和历史对话,当 user 输出 stop 相关的标识时,对话结束
Benchmark Construction In Version 1
每一个 domain 的数据构建都需要经历以下几三个阶段:
- 以尽量简单的原则来设计 database schemas、APIs 和 policies因为即便是一个很小的 domain 都需要至少 10 个 schemas、APIs 和 policies。这对于现存的 agent 已经很有挑战性了
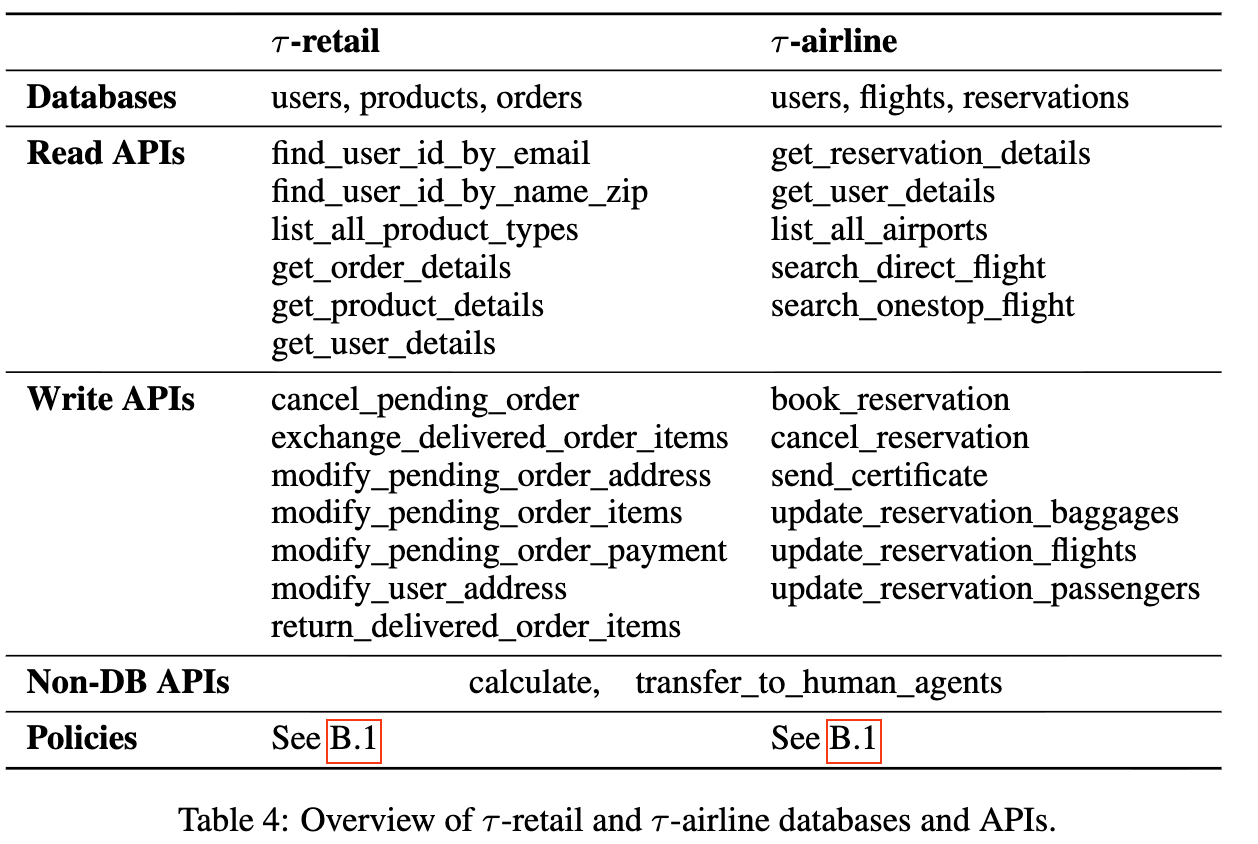
- 然后可以根据上右图,进行随机采样来完成初始信息来在构建的库进行随机搭配
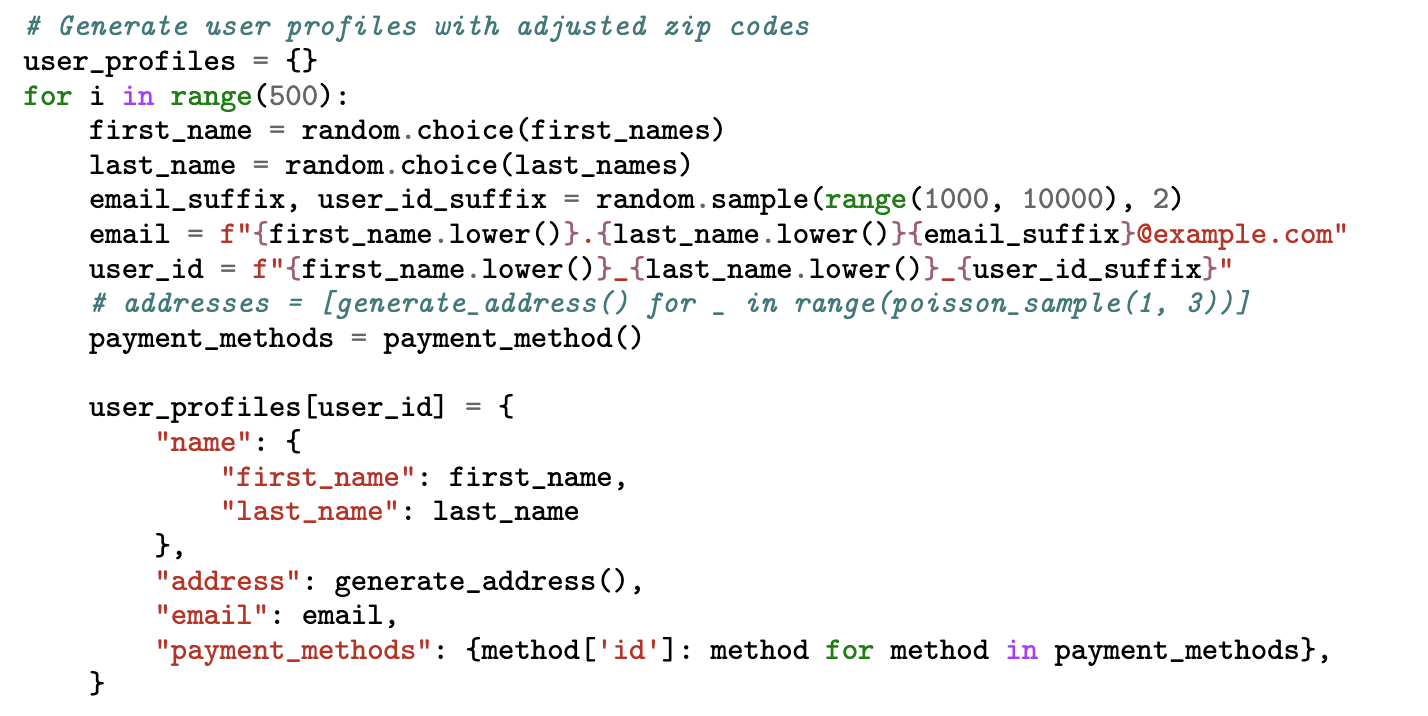
- 最后,最具有挑战性的是保证 user 的 instruction 会对应唯一的结果。比如:如果用户支付方式偏好未指定,那么最后的答案可能不是唯一的。因此通过 GPT4 去多次检验 user 的 instruction 直到不存在多个答案
Domain In Version 1
- retail:主要通过 agent 帮助用户完成订单的取消、修改、返回以及分发,包括修改地址、提供信息等
- airline:主要通过 agent 进行航班的预定和取消等,其中包括了 US 20 多个 city 的 300 次航班,这个 domain 的 policy 会比 retail 复杂很多
关于 Version 1 中的几个亮点
- 首先对 data schemas、APIs 以及 rules 进行了简化,但是有基本覆盖了现实生活中的大多数例子
- 保证数据只有一个唯一答案,替代了不用人工,避免了效率低下
- 框架模块化,可以很方便的添加或者更新 data schemas、APIs 以及 rules 的各个部分
Failure Breakdown In Version 1
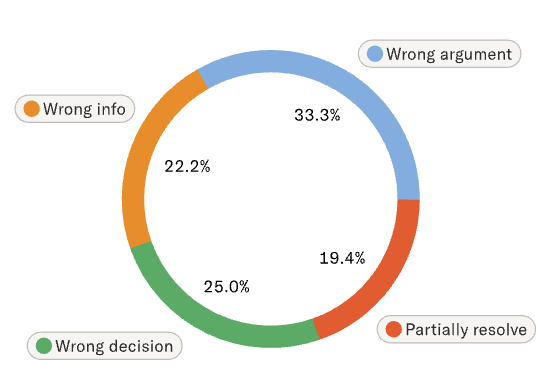
Failure Breakdown 比例图 从 retail 任务中 sample 了 115 个子任务在 4o 上的表现,其中有 40 个任务失败了:有 4 个是由于用户的 instruction 有 typo 或者表述不清;其余 36 个的具体分类如上
- 用户提供信息错误或者不足:比如用户想用现在买的灯退了换一个带 AC 或者 USB 接口的、低亮度的灯,但是由于符合要求灯的种类太多无法找到预设的唯一答案。而且对于能力弱一点的模型很容易产生幻觉:比如根本没有这个产品。另外有 50% 是模型错误计算价格、提供了错误的信息导致,主要还是因为模型的共识、数据推理以及用户意图判别有问题
- 模型理解和遵守 domain 的 policy 有问题:比如用户想要退换很多商品,但是退换规则里有跟一个 agent 只能进行一次退换操作。这时候 agent 需要将商品打包进行退换,但是常常出现模型没有理解到位的情况,导致只退换了第一个
- 复合请求情况下的部分解决:可能出现 agent 忽略第一个请求或者忽略隐含的 action,比如用户想要改所有商品的地址,但实际上 agent 只改了第一个
New In Version 2
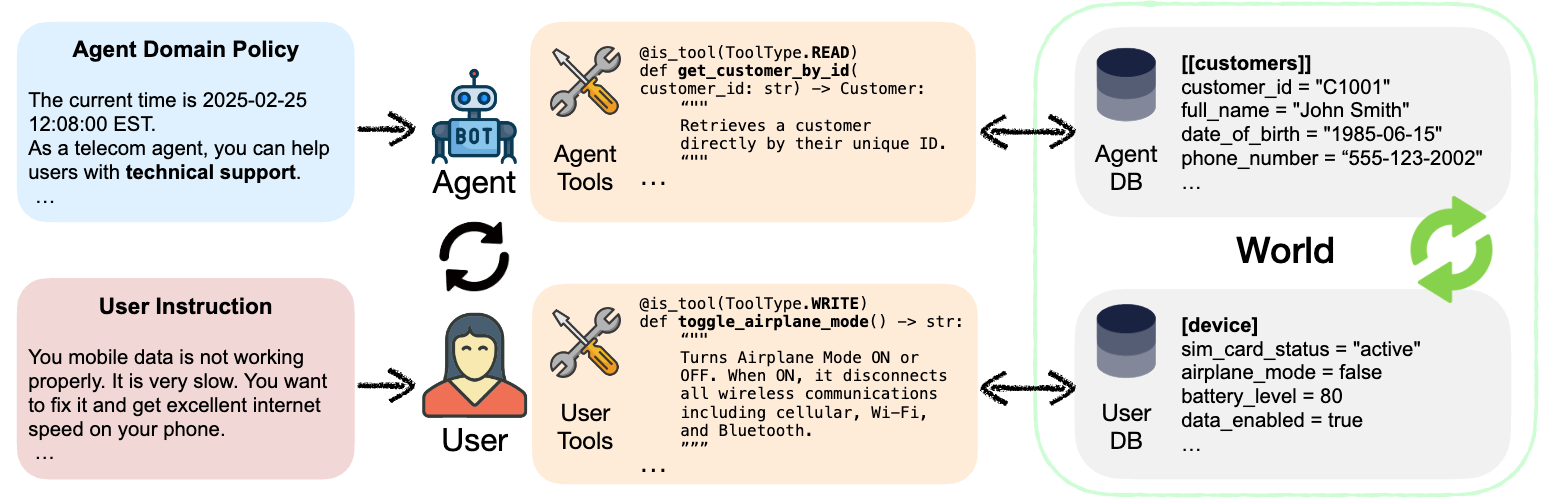
user 和 agent 可以都使用工具 在 τ2-bench 中最重要的是提出 user 和 agent 都可以使用 tools 的思想,只有 agent single-control 的环境中,agent 不能更加完全的了解到 user 的偏好和目标。如上图所示,user 也有自己的 database,可以通过 call tool 来进行查询 database。并且引入了新的 domain 的数据 telecom 并使用 double-control 的方式。交互的示例如下图:
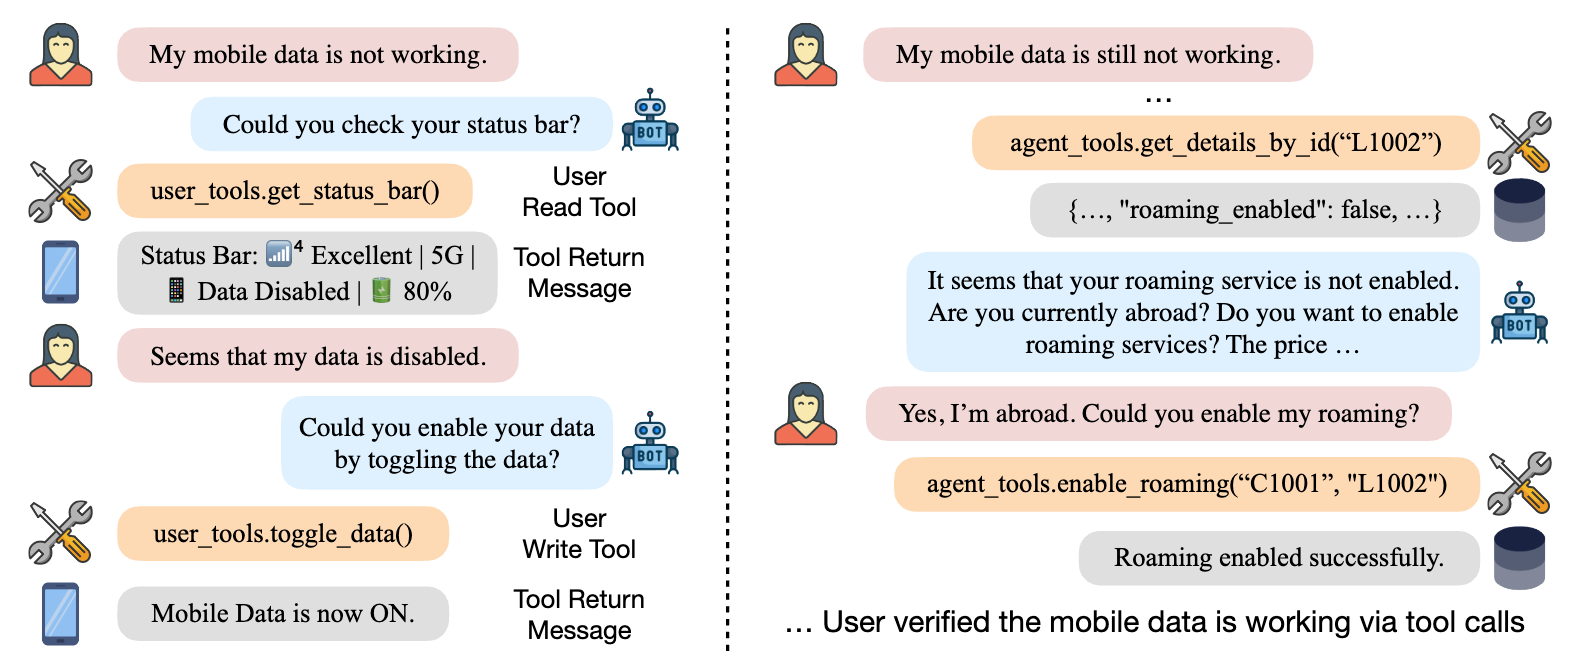
user 和 agent 可以都使用工具 Benchmark(Telecom) Construction In Version 2
- Creating agent’s database schema and tools:首先通过 LLM 生成一份 PRD 来概述 domain 中的核心商业逻辑。然后根据 PRD 来生成函数以及 mock database,并且会人工 refine code 直到单元测试通过
- Creating user’s database schema and tools:实际上跟 agent 同样的方法,比如在 telecom domain 中,模拟 user 的手机状态和控制的 function,以及最后进行单元测试
-
Programmatic task creation:定义原子任务为某个特定的任务,分别由 init function 初始化状态、solution function 解决问题、assertion function 保证问题解决。多个原子任务可以组成复合任务,只有每个原子任务的 assertion function 通过才可以任务解决了。在 telecom domain 有 15 个原子任务组,共三个意图类别:service_issue,mobile_data_issue and mms_issue,共生成 2285 个任务。最后考虑各个意图的难度均衡 sample 了 114 个任务,如下
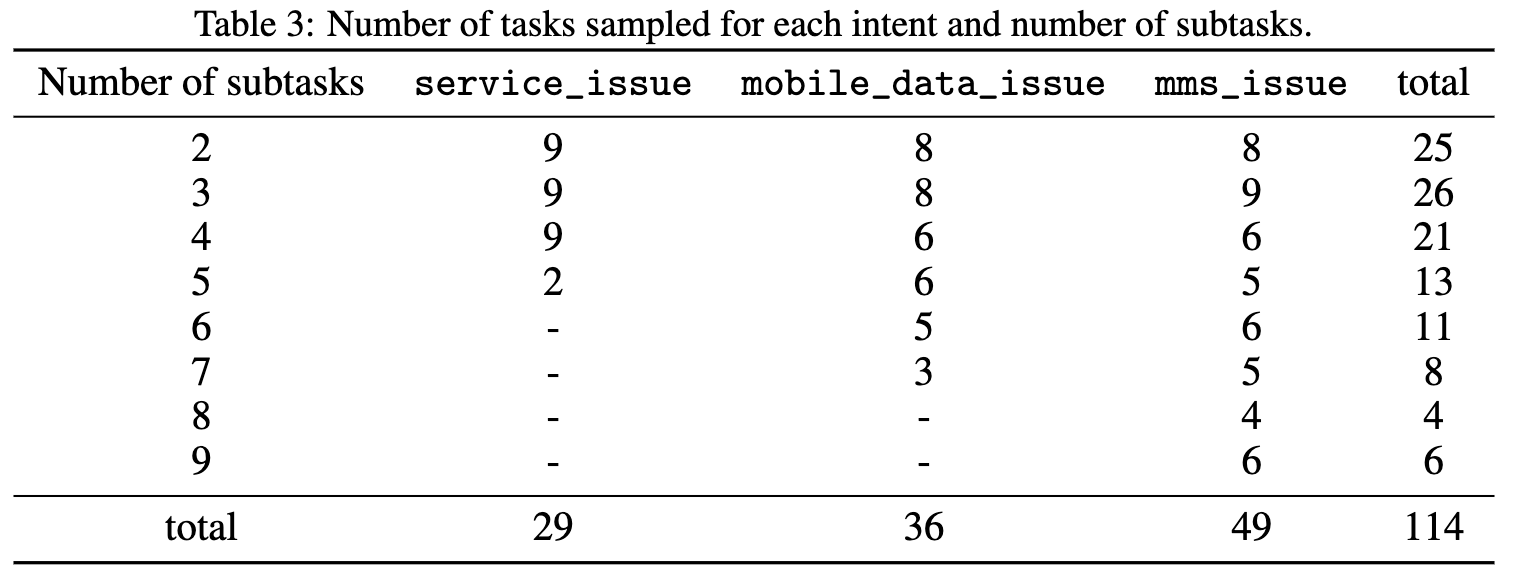
各个任务情况 - Creating domain-specific agent policy:这部分也是根据 task 和 solution 去 prompt 生成
- Manual refinement:除了简单 refine,version 2 还加入了模拟用户的详细信息,并且据此分了三类人群:None,Easy 和 Hard
- None:没有特定的信息背景人群
- Easy:熟悉该 domain 的人群
- Hard:一点不熟悉的人群
Ablation Analysis In Version 2
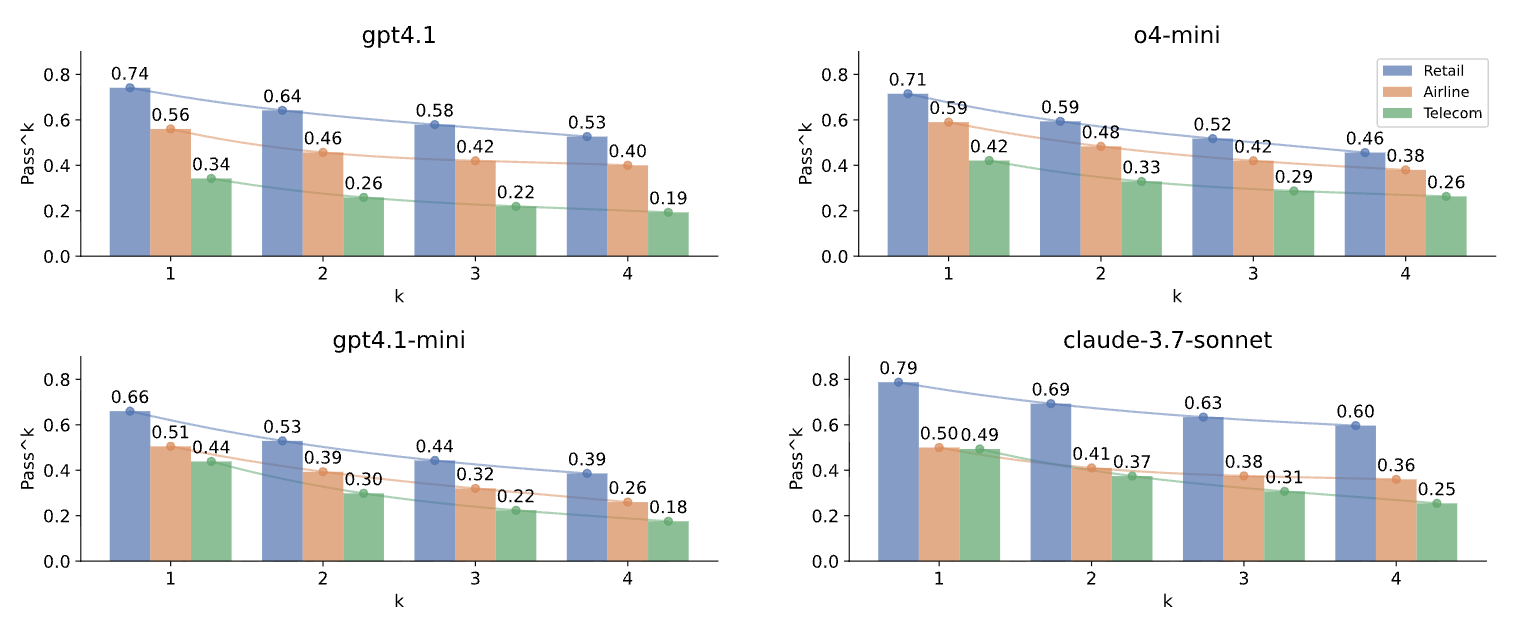
各个任务情况 首先可以看到 telecom domain 的表现是远远比其他 domain 要差的。在 version 2 中,agent 是否 success 主要取决于:怎么和 user 沟通以及合作解决问题的;是否遵循 policy document 中的 domain guidelines。为了更好的评估这两方面,从下面三个 setting 进行 ablation study:
- Default:dual- control setup
- No-User:可以看作单轮问答,提供给 agent 关于 user 问题的总结和解决成功的标准,agent 使用所有的 tools。主要测试的 agent 的推理能力(不依赖用户提示)
- Oracle Plan:会提供给 agent 一系列的 tool 供解决问题,包括 user 和 agent 的 actions。这里就不用 agent 去推理需要做的事,完全与 user 交流就行,是一个非常清晰的 plan
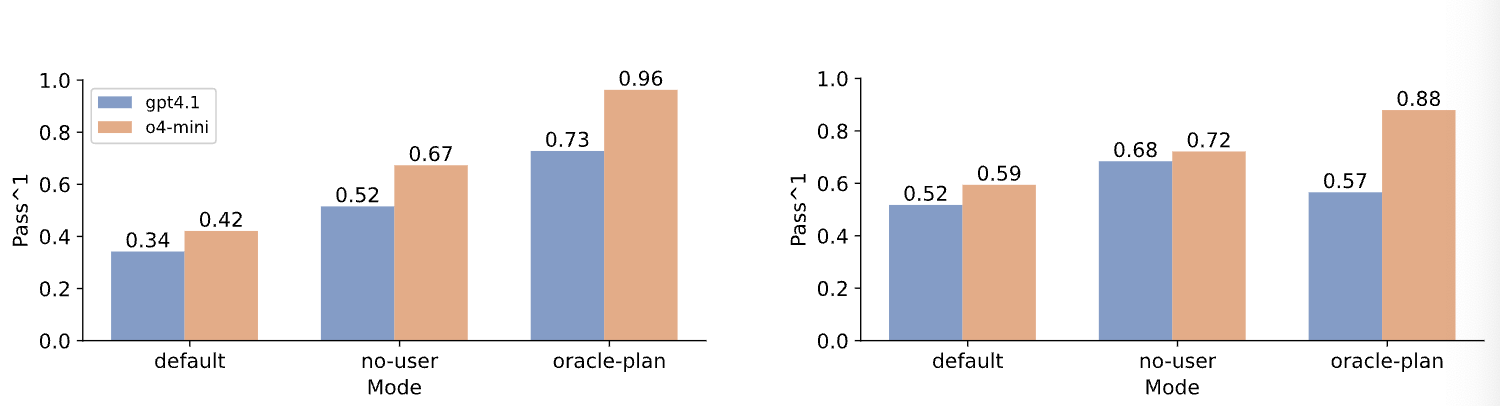
关于不同 setting,以及给不给 workflow 提示的实验结果 从上述结果(左图是默认模式,右图是有提示各个任务的 workflow 模式),可以得出以下结论:
- 默认模式的模型对比:o4 在提供了 user 的问题总结后有明显提升,说明它能更好的使用 ground truth 信息
- policy document 的影响:在右图中,会提供模型关于各个任务的 workflow 细节以及详细的 guidance。可以看到除了 oracle-plan 其他都有提升,猜测是因为这种模式本身就提供了 workflow,新的提示可能会影响之前的提示
关于 actions 的数量和子任务数量的影响
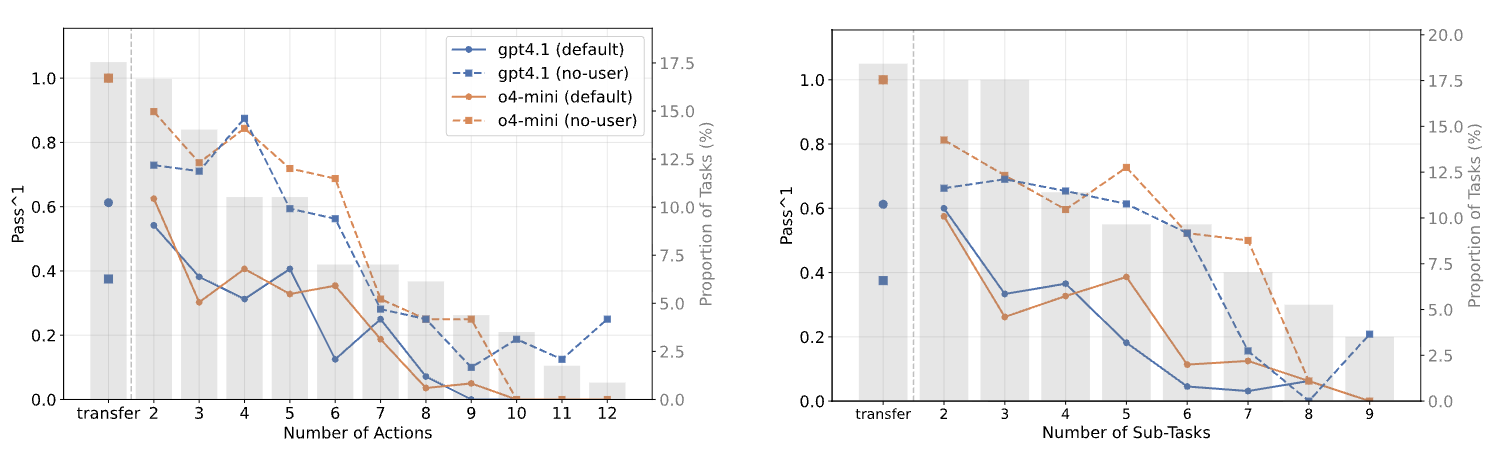
统计图 可以看到子任务和步数越多成功率越低
关于不同人群的影响
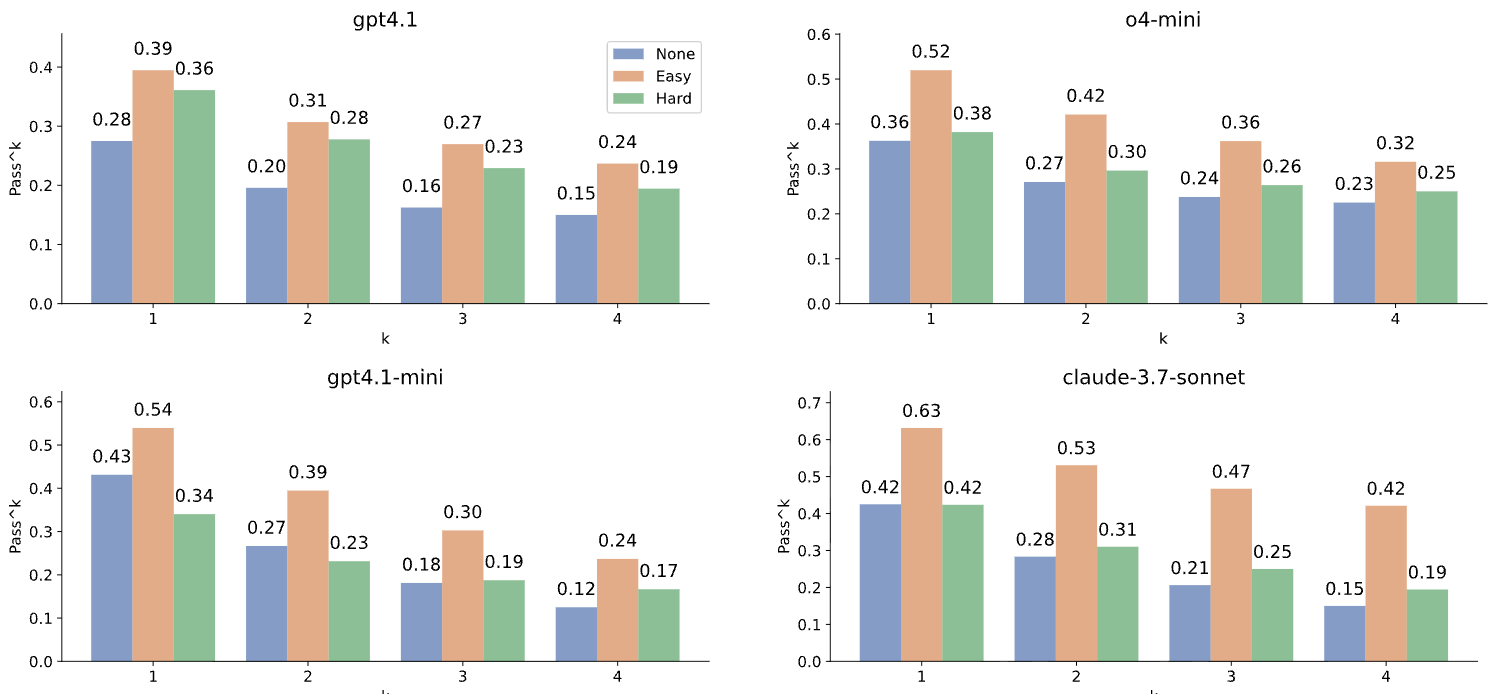
关于设置不同人设的效果图 这里可以看出来,什么都不提供比 hard 的人群效果更差
下图为提示给 agent 的 workflow 示意,会全部将其写在 prompt 中
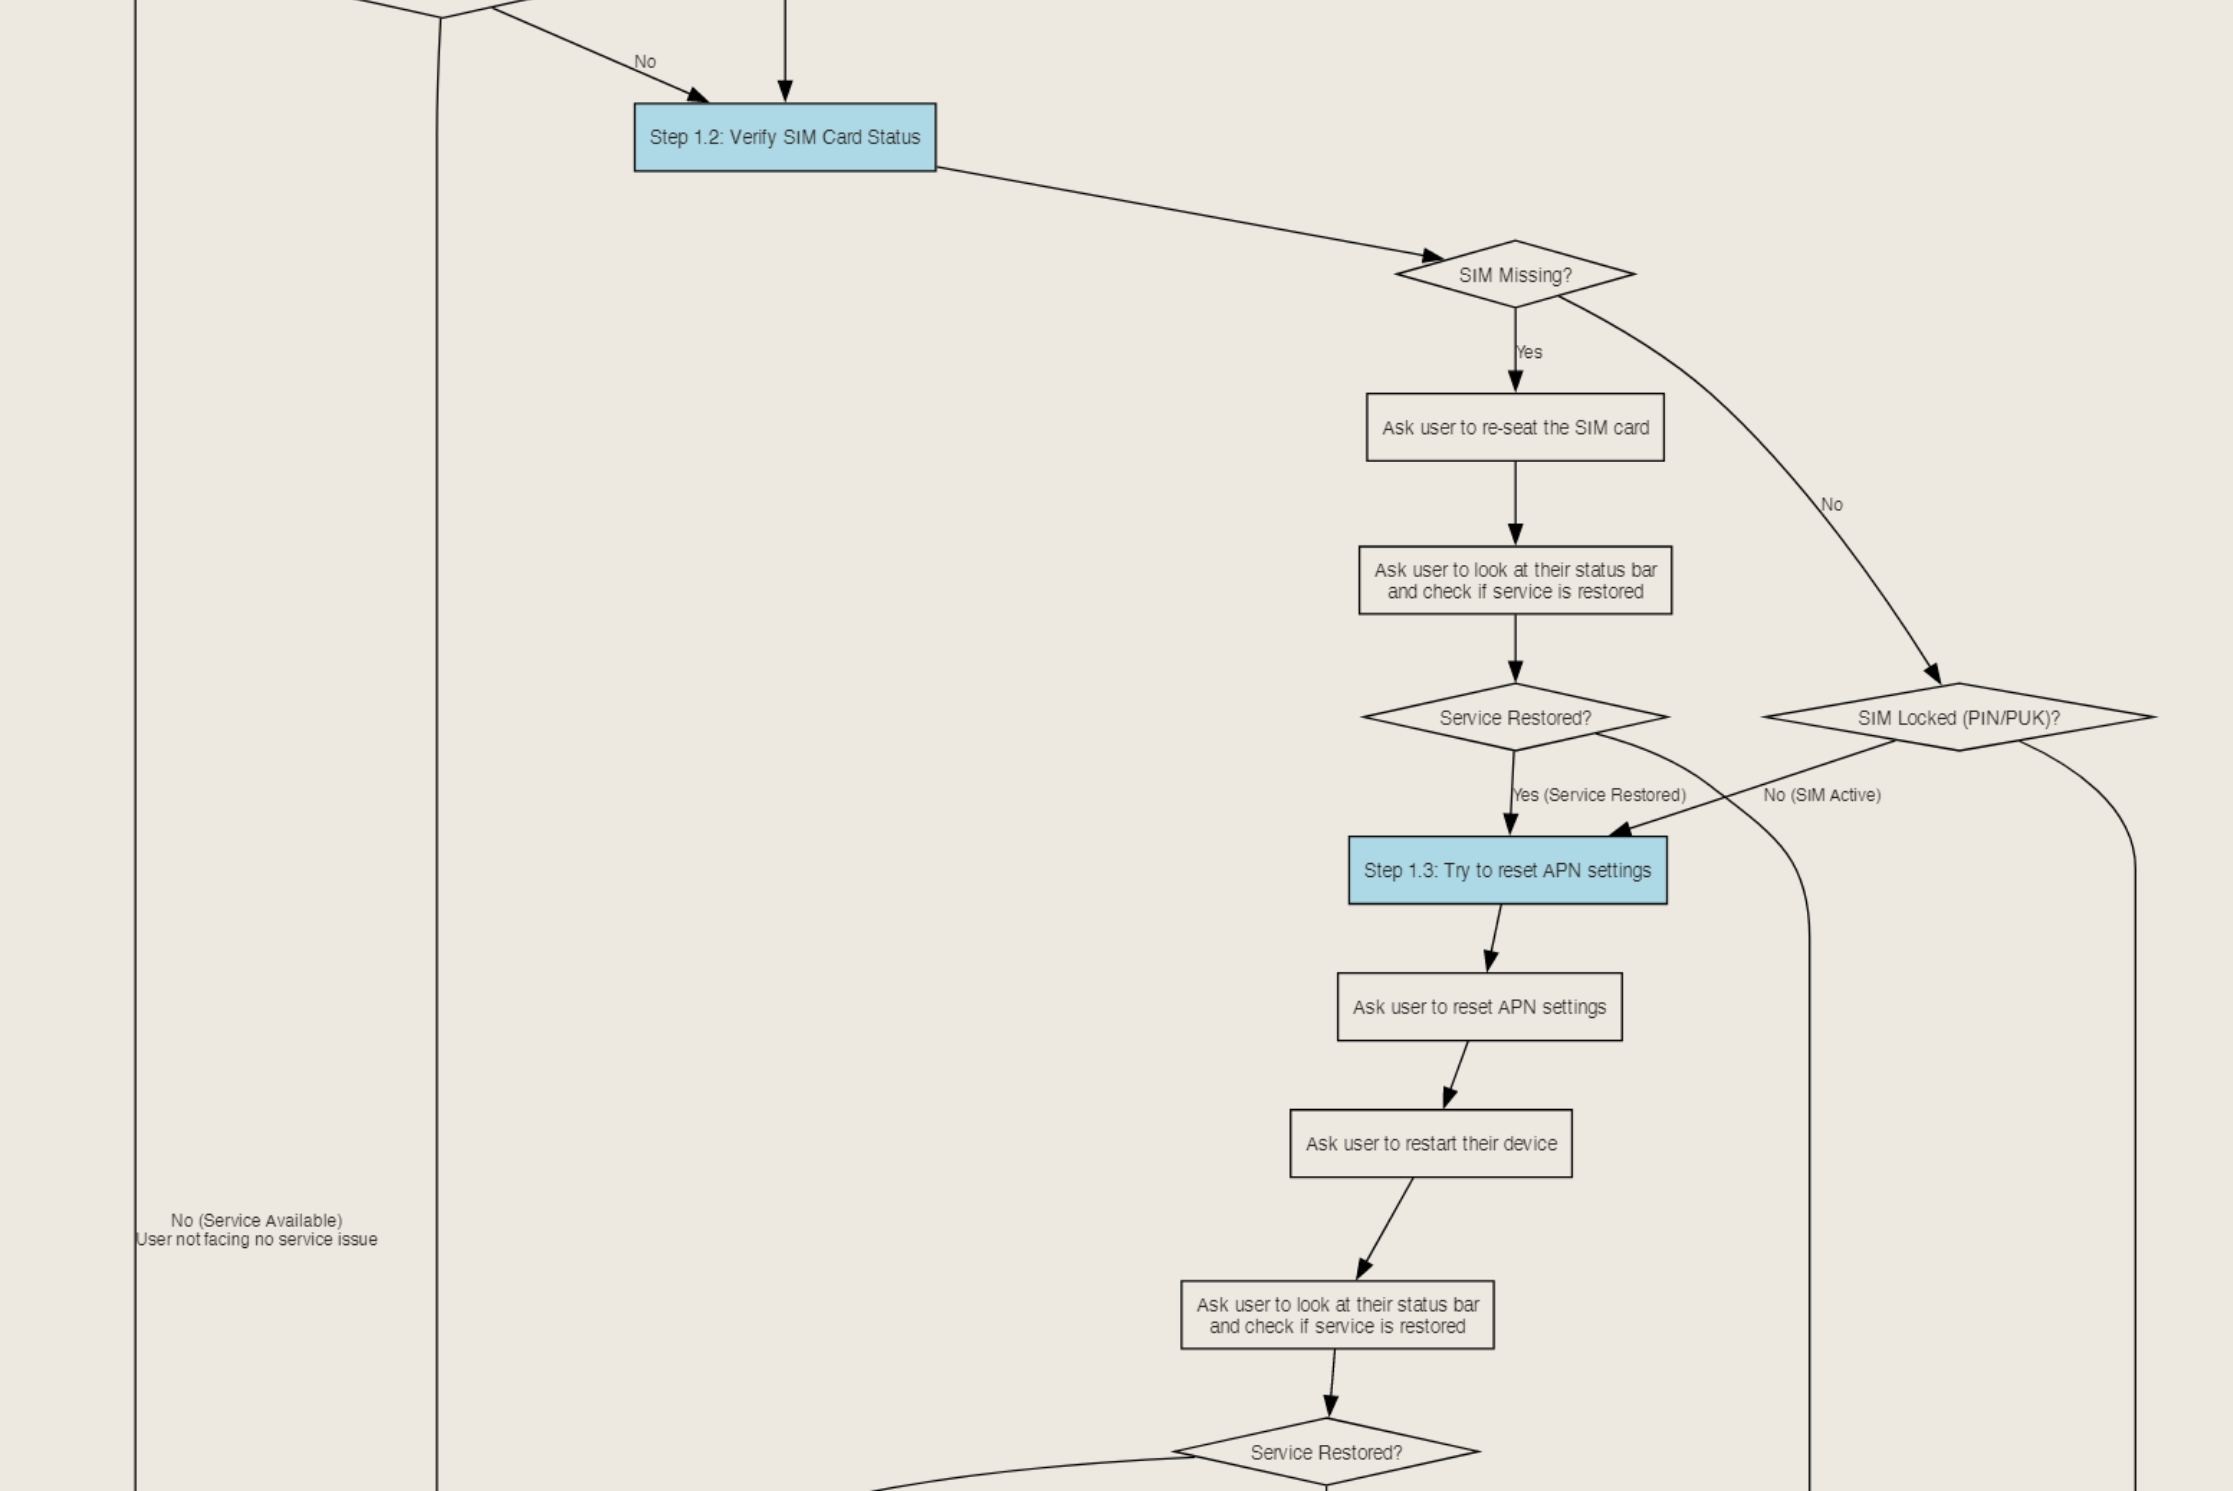
agent 的 workflow Reference
-
♣ Policy Optimization MPO DAPO GSPO
📅 November 27, 2025 📂 AI
这篇 Blog 主要对 MPO、DAPO、GSPO 进行介绍,这几种强化学习的方法或基于 DPO 或基于 GRPO 改进。因此默认已经有相关知识,这里就不再赘述了
MPO
首先先对 MPO 进行介绍。这里插播一个小插曲,由于我是直接搜索 MPO,因此刚开始我阅读错了 Paper → Mixing Preference Optimization。既然来都来了,那就还是介绍一下,不感兴趣可以跳过
An Efficient Post-Processing Framework for Mixing Diverse Preference Alignment
这篇论文主要想解决的是 MaxMin-RLHF 和 MORLHF 中遇到的问题。因此需要先介绍 MaxMin-RLHFMORLHF 与其思路大致一样 ,文中有大量的公式推导细节感兴趣的同学可以阅读原文 ,本文只做结论上的介绍
MaxMin-RLHF 指出来的问题是在 RLHF 中使用单一的 reward 无法满足人类偏好的多样性。文中特别提到了对于少数派或者某一群体比如学生和上班族的差异 的喜好时,单一的 reward 进行评估非常困难。因此论文训练了多个 reward,并根据 Egalitarian rule in social choice theory 选择对该回答评分不高的 reward 评分作为最后进行最大优化的评分关注少数派发言,使得模型不至于走不到那些极少关注的地方 。MaxMin 也在这里进行了体现
而这个 MPO 所做的事是在多个 reward 中的回答进行评价分数的 Normalization 的工作,主要是为了训练稳定。对 MaxMin 和 MORLHF 都提供了相应的解决方案
关于这个 MPO 就介绍到了这里,下面进入正题,Mixed Preference Optimization 这是 InternVL 系列用的强化学习方法,首先他的优化总目标如下:
\[\mathcal{L} = w_p \mathcal{L}_p + w_q \mathcal{L}_q + w_g \mathcal{L}_g\]文中主要把 Loss 分为三部分组成: Preference Loss, Quality Loss and Generation Loss
其中 Preference Loss 就是 DPO
\[\mathcal{L}_p = - \log \sigma \left( \beta \log \frac{\pi_\theta(y_c \mid x)}{\pi_0(y_c \mid x)} - \beta \log \frac{\pi_\theta(y_r \mid x)}{\pi_0(y_r \mid x)} \right)\]Quality Loss 是 BCO
\[\mathcal{L}_q = -\log \sigma \left( \beta \log \frac{\pi_\theta(y_c \mid x)}{\pi_0(y_c \mid x)} - \delta \right) - \log \sigma \left( - \left( \beta \log \frac{\pi_\theta(y_r \mid x)}{\pi_0(y_r \mid x)} - \delta \right) \right)\]Generation Loss
\[\mathcal{L}_g = - \frac{\log \pi_\theta(y_c \mid x)}{|y_c|}\]Binary Classifier Optimization for Large Language Model Alignment
DPO 就不过多介绍了,我们从 BCO 开始介绍。BCO 全称 Binary Classifier Optimization,不同于 KTO 单从 binary signals 出发,而是理论证明了 binary signal 和 preference optimization (DPO) 之间的联系从而优化。通过一个 a binary classifier 将
\[\begin{aligned}& \mathbb{E}_{(x, y_w, y_l) \sim \mathcal{D}} \left[ -\log \sigma \left( r_\theta(x, y_w) - r_\theta(x, y_l) \right) \right] \\& < \mathbb{E}_{(x, y_w, y_l) \sim \mathcal{D}} \left[ -\log \sigma(r_\theta(x, y_w)) - \log \sigma(-r_\theta(x, y_l)) \right] \\& = \mathbb{E}_{(x, y_w, y_l) \sim \mathcal{D}} \left[ -\log \sigma(r_\theta(x, y_w)) \right] + \mathbb{E}_{(x, y_w, y_l) \sim \mathcal{D}} \left[ -\log \sigma(-r_\theta(x, y_l)) \right]\end{aligned}\]prompt+chosen_completionmap 到 1 和prompt+rejected_completionmap 到 0,从而使用 binary cross-entropy loss 进行优化对于常见的 AI 应用有点赞和点踩功能,会更方便收集数据,并且可以防止 DPO 训练到一定程度后 choose 和 reject 同时下降的情况,本质上只需要 w > l 就行,可以参考讨论 并且证明了此种方法的 BCE Loss 是 DPO 的上界其中 \(r_\theta(x, y) = \beta \log \frac{\pi_\theta(y \mid x)}{\pi_{\text{ref}}(y \mid x)}\),随着训练进行 BCE 会成为 DPO 严格的上界。由于上式应用了不等式 \(\log \sigma (x) + \log \sigma (y) \lt \log \sigma (x + y)\),所以比起 DPO 会出来误差项 \(e^{-x} + e^{-y}\)。为了更接近 DPO,文中使用了 reward shift \(\delta\) 进行缓解会使 \(e^{-x} + e^{-y}\) 变为 \(e^{-(x - \delta)} + e^{-(y - \delta)}\) ,最终 BCO 优化目标为:
\[\mathbb{E}_{(x, y_w, y_l) \sim \mathcal{D}^+} \left[ -\log \sigma(r_\theta(x, y_w) - \delta) \right] + \mathbb{E}_{(x, y_w, y_l) \sim \mathcal{D}^-} \left[ -\log \sigma(-(r_\theta(x, y_l) - \delta)) \right]\]文中推导了即便减去 reward shift 也不会改变 BCO 为 DPO 上界,reward shift 取值由均值不等式得到 \(\delta = \frac{\mathbb{E}{(x,y) \sim \mathcal{D}^+}[r\theta(x, y)] + \mathbb{E}{(x,y) \sim \mathcal{D}^-}[r\theta(x, y)]}{2}\),为了训练稳定,使用 EMA 进行计算。BCO 的介绍就完了
从 BCO 的介绍可以知道,它可以作为判断生成好坏的标签从绝对层面进行判断这个 response 的好坏,即 binary 二分 。Generation Loss 其实就是 SFT Loss 主要用于学习偏好回答生成的过程,下面是不同方法的对比结果
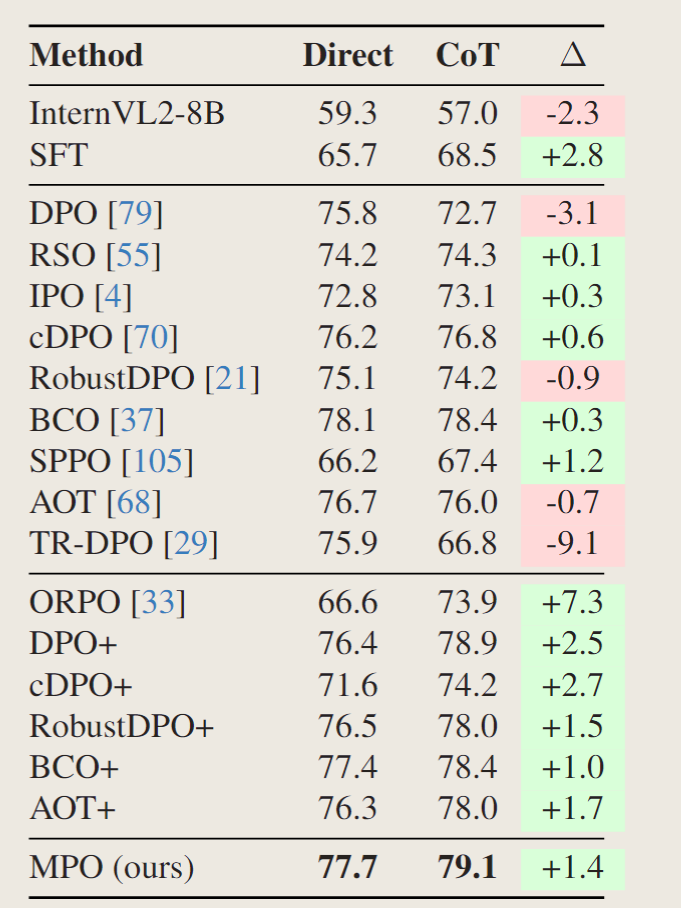
消融实验对比 上图中的
+是使用了 SFT Loss,如 DPO+ 指的 DPO + SFT LossDAPO
DAPO 是 GRPO 的改进版。作者指出很难去复现 GRPO 在 AIME 上的指标,其中发现了 entropy collapse,reward noise 和 training instability 等问题。为了解决这些问题,作者提出了 Decoupled clip and Dynamic sAmple Policy Optimization 算法,主要从五个方面进行了改进,首先是去除了 KL 散度,是考虑到所训练的 long-CoT reasoning model 的参数分布早已远远不同于初始的模型了,加上会限制模型的发挥
Clip-Higher
我们知道裁剪是对重要性采样的裁剪,如下式
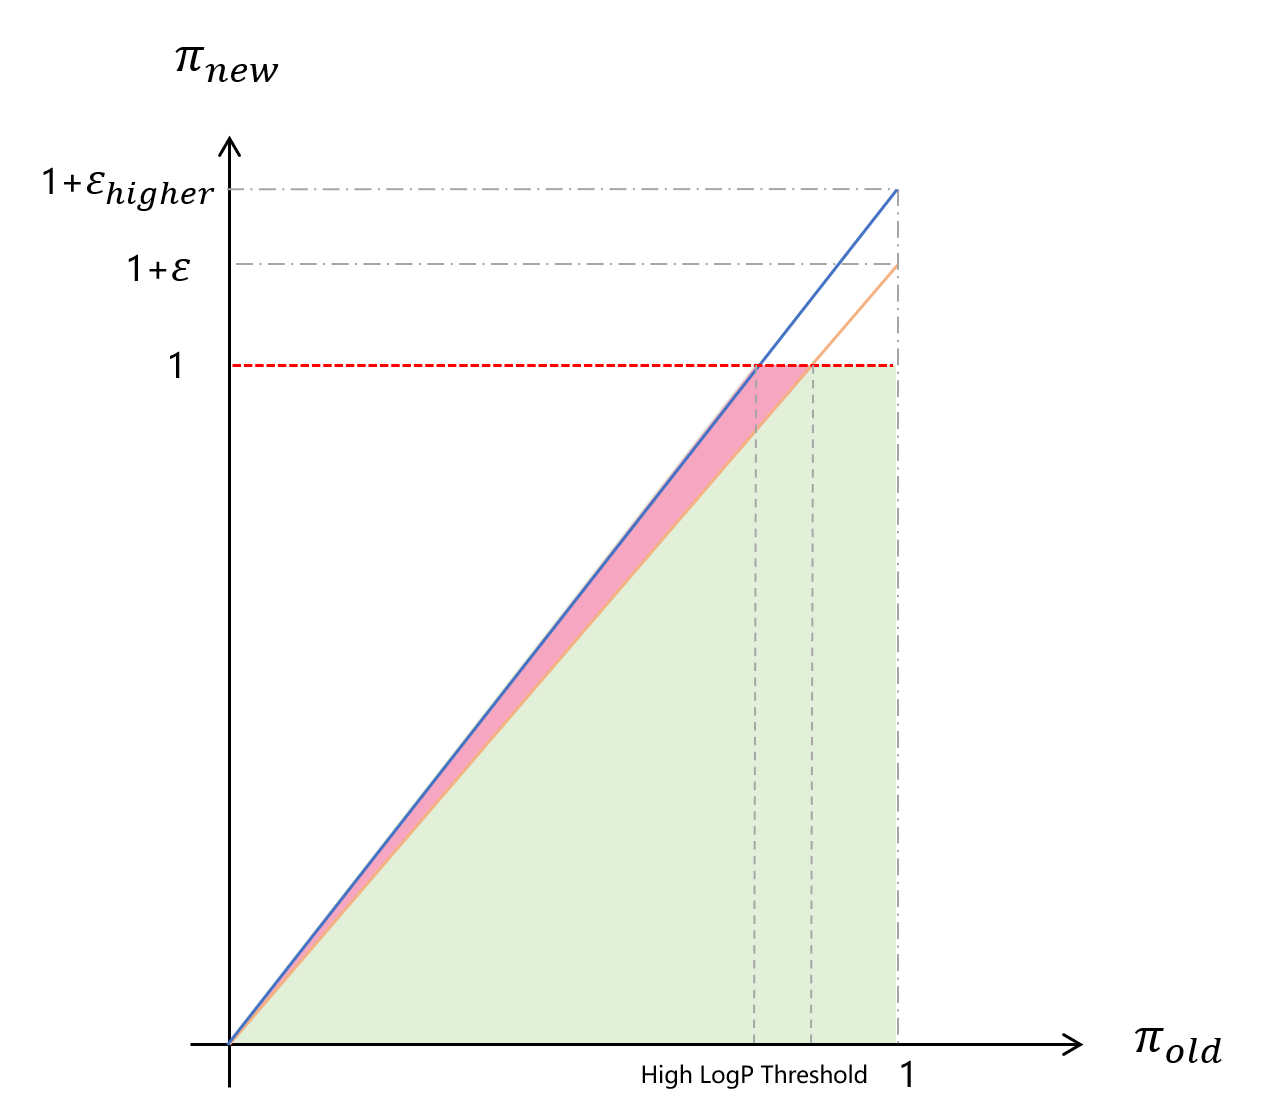
\[1 - \varepsilon_{\text{low}} \le r_{i,t}(\theta) = \frac{\pi_\theta(o_{i,t} \mid q, o_{i,<t})}{\pi_{\theta_{\text{old}}}(o_{i,t} \mid q, o_{i,<t})} \le 1 +\varepsilon_{\text{high}}\]考虑 token 在原 policy 的概率为 0.9是一个高概率的 token ,在现 policy 的概率贡献最多可以为 1.08,同样对于一个较少采样的 token 其概率为 0.01,哪怕现 policy 概率为 1 也只能贡献 0.012 所占用的权重依然很小,导致模型很难选用这个 token。文中通过将裁剪的上界和下界分别进行设置,旨在提高原 policy 低概率 token 的采用可能性文中给这类 token 取名为 exploration token 能增强模型的探索的可能性,相反另外一种为 exploitation token 。因此第一个改动为
\[\text{clip}\left(r_{i,t}(\theta), 1 - \varepsilon, 1 + \varepsilon\right) \rightarrow \text{clip}\left(r_{i,t}(\theta), 1 - \varepsilon_{\text{low}}, 1 + \varepsilon_{\text{high}}\right)\]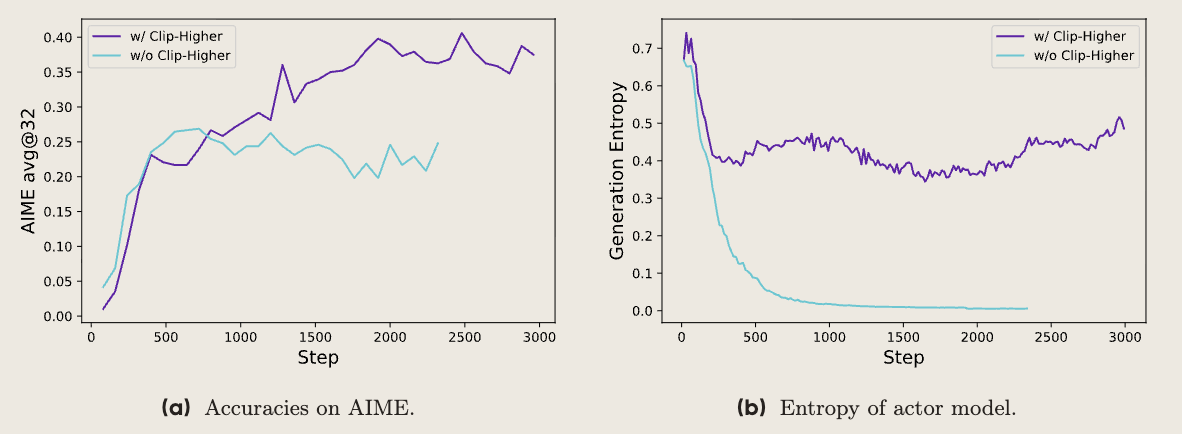
clip 示意图 如图可知当使用了 clip higher 之后,old policy 中的低概率 token 会得到更多的贡献,但实际上是对于优势为正的 token 采取了更加激进的策略,增强了 old policy 中概率小于在 \(1/(1+\varepsilon)\) 的 token 采样几率,在上图表现为增加的粉红采样区域
clip 对比实验 其中 clip 的上限提高了,为了防止低概率 token 容易更低,下限保持没变。效果也很明显, actor 的 entropy collapse 得到了一定程度的解决。文中采取以下配置 : \(\varepsilon_{\text{low}}\) 为 0.2 和 \(\varepsilon_{\text{high}}\) 为 0.28
Dynamic Sampling
这部分的改进主要是针对某些 prompt 生成的 response 都是对的,这时候 advantage 将会变为 0。那么梯度将会非常小,基本等于白跑。而且会造成梯度方差过大从而影响训练。改进方式也挺简单:一直 sample 直到不全为 0 或者 1论文特别说明这种策略并不会影响训练速度,主要是由于采样速度是由长尾数据影响的
Token-Level Policy Gradient Loss
我们可以先看看 GRPO 怎么算 loss 的
\[\frac{1}{G} \sum_{i=1}^{G} \frac{1}{|o_i|} \sum_{t=1}^{|o_i|} \left( \min \left( r_{i,t}(\theta) \hat{A}_{i,t},\ \text{clip}\left(r_{i,t}(\theta), 1 - \varepsilon, 1 + \varepsilon\right) \hat{A}_{i,t} \right) - \beta D_{\text{KL}}(\pi_\theta \| \pi_{\text{ref}}) \right)\]GRPO 是对于组内每一个 sample 进行 token 级别的平均,然后再进行 sample 级别的平均。这样对于每个 sample 实际上使用了相同的权重,比较长的回答实际上没有对 loss 有更多的贡献。会导致两个缺陷:对于高质量的长回答不能更加重视,既不能学习太多有效的长思考过程,也不能有效遏制重复的垃圾话。 DAPO 则是进行了 token 级别的计算
\[\frac{1}{\sum_{i=1}^{G} |o_i|} \sum_{i=1}^{G} \sum_{t=1}^{|o_i|} \min \left( r_{i,t}(\theta) \hat{A}_{i,t},\ \text{clip}\left(r_{i,t}(\theta), 1 - \varepsilon_{\text{low}}, 1 + \varepsilon_{\text{high}}\right) \hat{A}_{i,t} \right)\]假设单个 sample 的 loss 总和是 \(loss_i\),token 数量为 \(n_i\),一共 \(G\) 个 sample,则一个 group loss 计算变化如下:
\[\frac{loss_{0}}{n_{0}G} + \frac{loss_{1}}{n_{1}G} + \frac{loss_{2}}{n_{2}G} + \cdots \rightarrow \frac{loss_{0} + loss_{1} + loss_{2}+ \cdots }{n_{0} + n_{1} + n_{2} + \cdots }\]从上式可以看出来,DAPO 的 loss 实际上使用同样的 normalization,从相对数值来说,同样等于没用,这时候长回答的 loss 能够体现他真正的 loss 贡献GRPO 每个 sample 在内部做 normalize 被论文称为 sample level,DAPO 是 sample 内部并没有做 normalize 而是所有 token 一起求和后做 normalize 这样每个 token 的权重是一样的,不会因为 sample 的长度而不一样
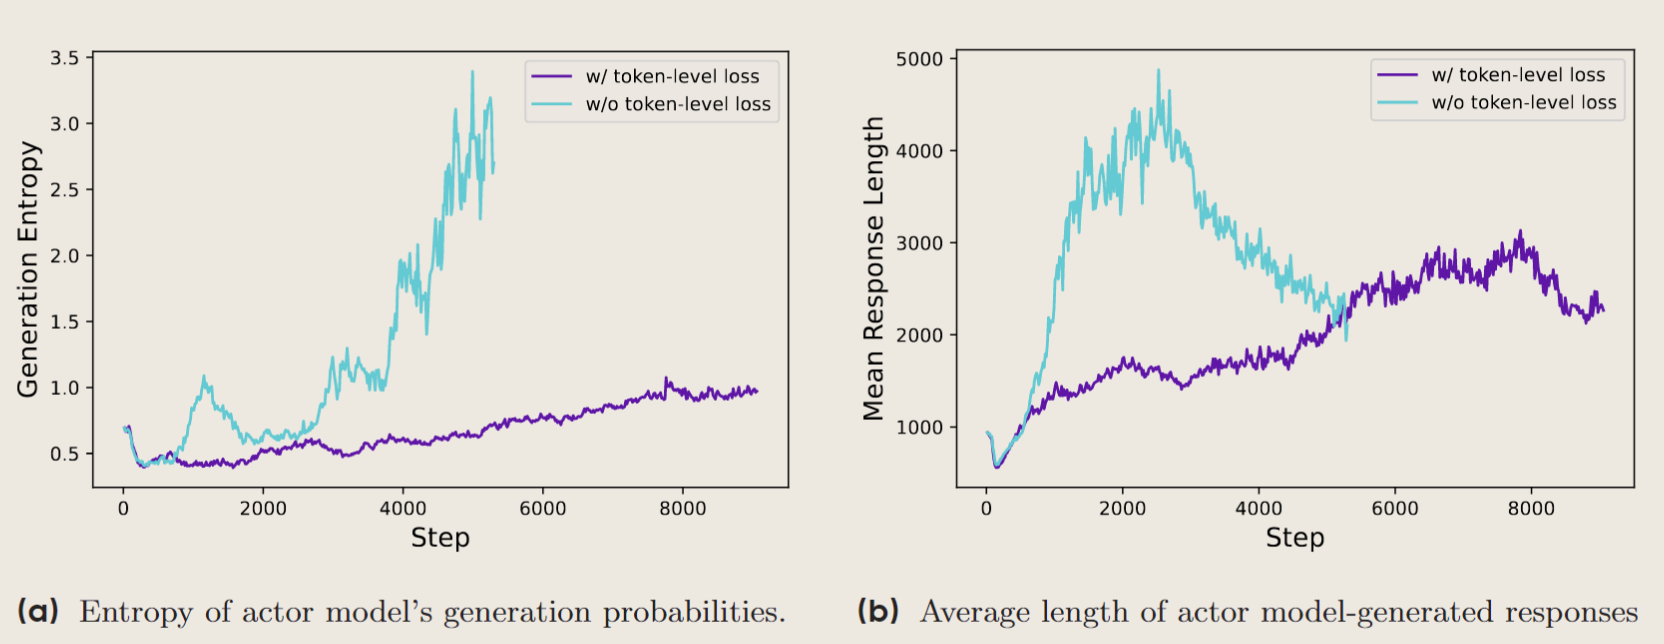
loss 实验 可以看到回答长度没有疯涨了,因为会遏制重复的垃圾话模式
Overlong Reward Shaping
主要是关于有的回答过长而被截断的情况,这种 reward 非常影响训练,文章使用了分段函数解决这个问题:
\[R_{\text{length}}(y) = \begin{cases}0, & |y| \leq L_{\text{max}} - L_{\text{cache}} \\\frac{(L_{\text{max}} - L_{\text{cache}}) - |y|}{L_{\text{cache}}}, & L_{\text{max}} - L_{\text{cache}} < |y| \leq L_{\text{max}} \\-1, & L_{\text{max}} < |y|\end{cases}\]越长惩罚越大,从下图可以看到整体平稳了很多
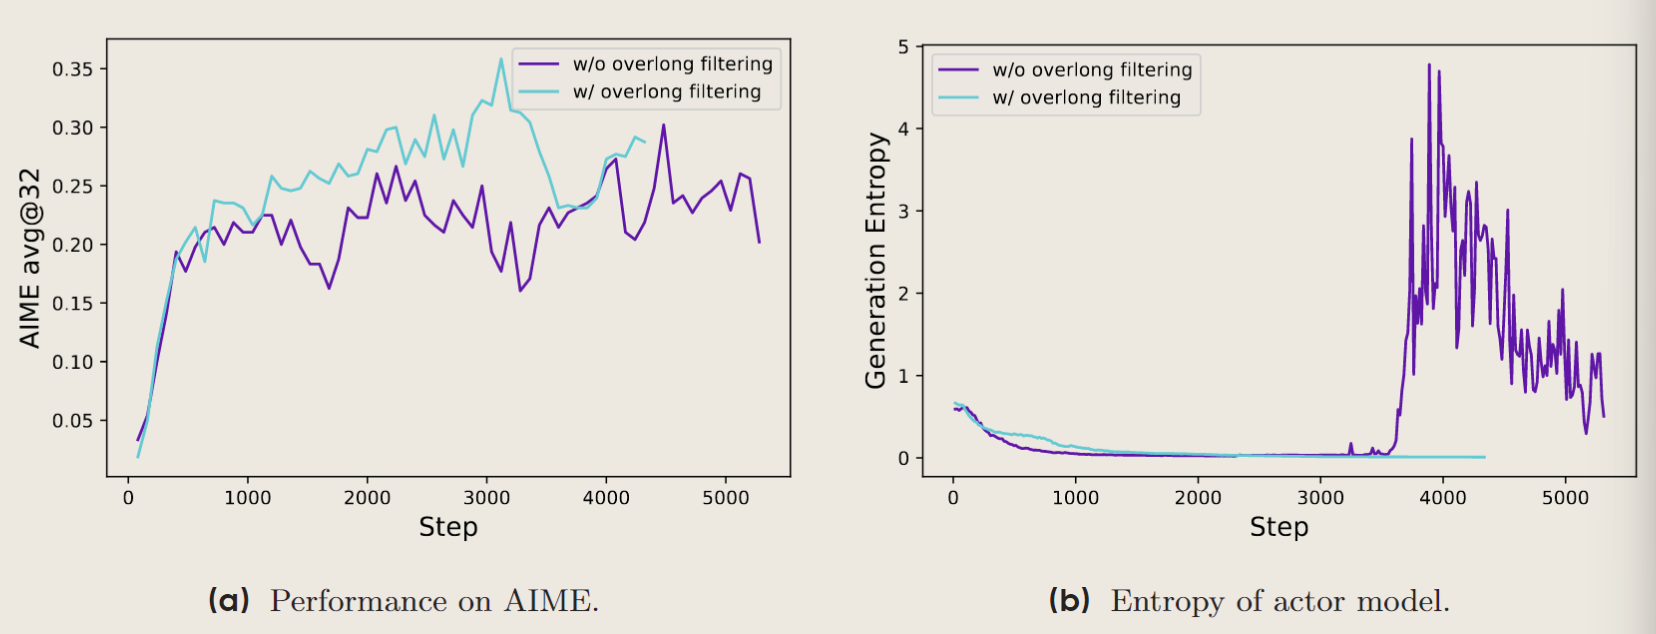
长度惩罚对比实验 最后是每一项提点的表现
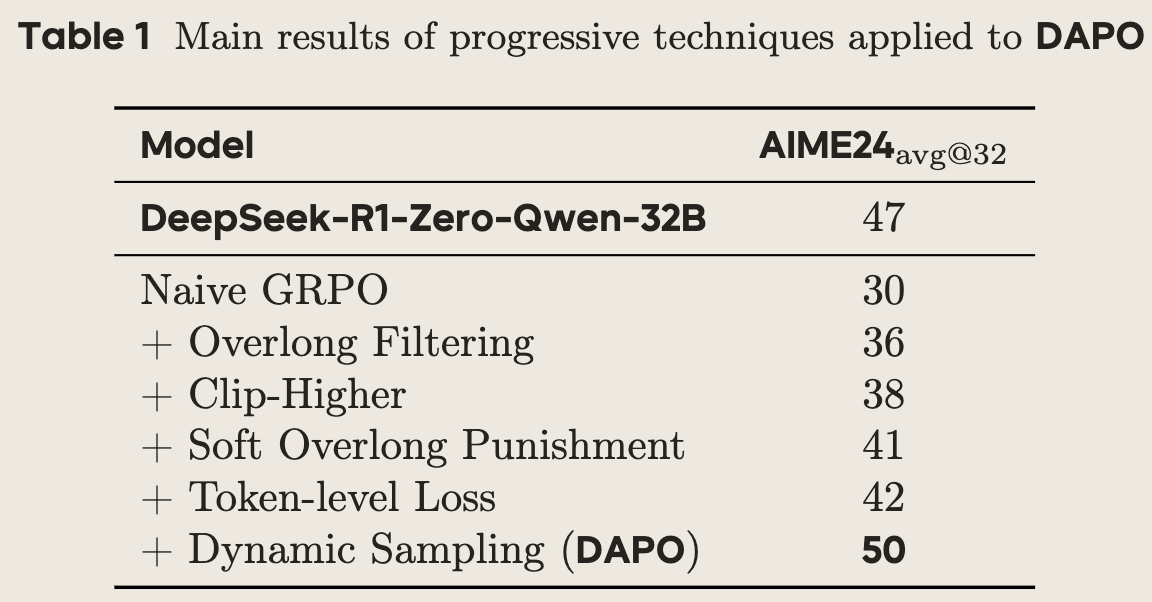
总体表现 GSPO
Group Sequence Policy Optimization 是 Qwen 团队基于 GRPO 之上提出的强化学习方法。在 RL 中常常为了采样的效率考虑,会把一个大 batch 分成多个 mini-batch。这就使得了采样来自 old policy 用于优化 new policy,这也是为什么需要重要性采样的原因关于重要性采样可以阅读重要性采样与PPO、TRPO以及重要性采样(Importance Sampling)等文章
文章提出了 GRPO 中一个根本性的问题:重要性采样权重的错误应用导致 long-response 任务训练时会 model collapse。简单来说,就是 GRPO 的重要性采样时 token level 的,但是整个奖励确实 sample level 的。这会使得训练的梯度有高方差的噪声,特别是在训练 long-response 数据和使用 clipping 的时候,如果使得 model collapse 即便加载之前的 checkpoint 也无法逆转这点是为什么呢,因为加载过后也会走老路吗 对此,论文提出了 GSPO
\[\mathbb{E}_{x \sim \mathcal{D},\, \{y_i\}_{i=1}^G \sim \pi_{\theta_{\text{old}}}(\cdot|x)} \left[ \frac{1}{G} \sum_{i=1}^G \min\left( s_i(\theta) \hat{A}_i,\, \text{clip}\left(s_i(\theta), 1-\varepsilon, 1+\varepsilon\right) \hat{A}_i \right) \right]\]其中
\[s_i(\theta) = \left( \frac{\pi_\theta(y_i|x)}{\pi_{\theta_{\text{old}}}(y_i|x)} \right)^{\frac{1}{|y_i|}} = \exp\left( \frac{1}{|y_i|} \sum_{t=1}^{|y_i|} \log \frac{\pi_\theta(y_{i,t}|x, y_{i,<t})}{\pi_{\theta_{\text{old}}}(y_{i,t}|x, y_{i,<t})} \right)\]可以看到主要的区别在于对重要性的计算上,GSPO 是对每个 token 的重要性采样然后进行求和得到,从下面的代码可以看出: GSPO 对于每一个 token 的重要性采样都是一样的,即 sample level
# source: https://github.com/huggingface/trl/blob/main/trl/trainer/grpo_trainer.py
# get old policy logps, there is need the old policy logps on update every step
generate_every = self.args.steps_per_generation * self.num_iterations
if self.args.gradient_accumulation_steps % generate_every != 0 or (
    self.use_vllm and self.vllm_importance_sampling_correction
):
    old_per_token_logps, _ = self._get_per_token_logps_and_entropies(
        self.model,
        prompt_completion_ids,
        attention_mask,
        logits_to_keep,
        batch_size,
        num_images=num_images,
        **forward_kwargs,
    )
else:
    old_per_token_logps = None

# get reference model logs
ref_per_token_logps = self._get_per_token_logps(
		self.ref_model, prompt_completion_ids, attention_mask, logits_to_keep
)

# get KL
if self.beta != 0.0:
    ref_per_token_logps = inputs["ref_per_token_logps"]
    per_token_kl = (
        torch.exp(ref_per_token_logps - per_token_logps) - (ref_per_token_logps - per_token_logps) - 1
    )

# get Reward
rewards_per_func = self._calculate_rewards(inputs, prompts, completions, completion_ids_list)

# Apply weights to each reward function's output and sum
rewards = (rewards_per_func * self.reward_weights.to(device).unsqueeze(0)).nansum(dim=1)

# get the Advantages
mean_grouped_rewards = rewards.view(-1, num_generations).mean(dim=1)
mean_grouped_rewards = mean_grouped_rewards.repeat_interleave(num_generations, dim=0)
advantages = rewards - mean_grouped_rewards

if self.scale_rewards in ["group", "none"]:
    # If self.scale_rewards = "none", we'll still log group level std
    std_rewards = rewards.view(-1, num_generations).std(dim=1)
    std_rewards = std_rewards.repeat_interleave(num_generations, dim=0)
elif self.scale_rewards == "batch":
    # Compute global std
    std_rewards = rewards.std().expand_as(rewards)
else:
    raise ValueError(
        f"Invalid value for scale_rewards: {self.scale_rewards}. Must be one of 'batch', 'group', or 'none'."
    )

# get Importance Sample issue: https://github.com/huggingface/trl/issues/2608
old_per_token_logps = per_token_logps.detach() if old_per_token_logps is None else old_per_token_logps
log_ratio = per_token_logps - old_per_token_logps
if self.importance_sampling_level == "token":      # for GRPO
    log_importance_weights = log_ratio
elif self.importance_sampling_level == "sequence": # for GSPO
    log_importance_weights = (log_ratio * completion_mask).sum(-1) / completion_mask.sum(-1).clamp(min=1.0)
		log_importance_weights = log_importance_weights.unsqueeze(-1)
else:
    raise ValueError(
        f"Unknown importance sampling level: {self.importance_sampling_level}. Possible values are 'token' "
        "and 'sequence'."
    )

# alppy Clip
coef_1 = torch.exp(log_importance_weights)
# From here, log_importance_weights (and all subsequent tensors, coef_1, coef_2, etc.) shape depends on

# importance_sampling_level: "token" level: (B, T); "sequence" level: (B, 1)
if self.loss_type in ["grpo", "bnpo", "dr_grpo", "dapo"]:
    coef_2 = torch.clamp(coef_1, 1 - self.epsilon_low, 1 + self.epsilon_high)
    # Two-sided clipping
    if self.args.delta is not None:
        coef_1 = torch.clamp(coef_1, max=self.args.delta)

    per_token_loss1 = coef_1 * advantages
    per_token_loss2 = coef_2 * advantages
    per_token_loss = -torch.min(per_token_loss1, per_token_loss2)
else:
    raise ValueError(f"Unknown loss type: {self.loss_type}")

# add kl
if self.beta != 0.0:
    per_token_loss = per_token_loss + self.beta * per_token_kl

# normalize loss
if self.loss_type == "grpo":
    loss = ((per_token_loss * completion_mask).sum(-1) / completion_mask.sum(-1).clamp(min=1.0)).mean()
    loss = loss / self.current_gradient_accumulation_steps
elif self.loss_type in ["cispo", "dapo"]:
    normalizer = inputs["num_items_in_batch"] / self.accelerator.num_processes
    loss = (per_token_loss * completion_mask).sum() / normalizer
从梯度影响上看
GRPO
\[\mathbb{E}_{x \sim \mathcal{D},\, \{y_i\}_{i=1}^G \sim \pi_{\theta_{\text{old}}}(\cdot|x)} \left[ \frac{1}{G} \sum_{i=1}^G \hat{A}_i \cdot \frac{1}{|y_i|} \sum_{t=1}^{|y_i|} \frac{\pi_\theta(y_{i,t}|x, y_{i,<t})}{\pi_{\theta_{\text{old}}}(y_{i,t}|x, y_{i,<t})} \nabla_\theta \log \pi_\theta(y_{i,t}|x, y_{i,<t}) \right]\]GSPO
\[\mathbb{E}_{x \sim \mathcal{D},\, \{y_i\}_{i=1}^G \sim \pi_{\theta_{\text{old}}}(\cdot|x)} \left[ \frac{1}{G} \sum_{i=1}^G \left( \frac{\pi_\theta(y_i|x)}{\pi_{\theta_{\text{old}}}(y_i|x)} \right)^{\frac{1}{|y_i|}} \hat{A}_i \cdot \frac{1}{|y_i|} \sum_{t=1}^{|y_i|} \nabla_\theta \log \pi_\theta(y_{i,t}|x, y_{i,<t}) \right]\]可以看出来 GRPO 的重要性采样对每一个 token 的梯度都会有影响,这在 long-response 的情况可能会出现不可预测的问题当错误的时候,累积过多,可能直接 model collapse 。GSPO 更像一个平均策略,这样会更稳一点波动小点,但不一定更精确
番外篇
关于 GRPO 一开始训练 loss 为零的问题,主要是因为最开始 new policy 和 old policy 是一样的,此时重要性采样为 1, KL 为 0,而 advantage 的期望为 0,所以 loss 非常接近 0。loss 为0,参数为啥还能更新呢?有两种说法是:advantage 的期望是 0 但可能不会完全为 0;bf16 计算本来也有误差很难完全为 0。详细讨论可以参考:Why does the loss start at 0 when I train GRPO, and then possibly increase?
Reference
An Efficient Post-Processing Framework for Mixing Diverse Preference Alignment
不靠谱】有关DPO训练时,为什么chosen和rejected的reward一起下降的猜想
Why does the loss start at 0 when I train GRPO, and then possibly increase
-
♣ 让 Packing 加速你的大模型训练
📅 August 20, 2025 📂 AI
这篇 Blog 介绍一下跟训练效率相关的内容,来自于两篇主要通过 Packing 技术解决 VLM 和 LLM 中 Load Unbalance 的 Paper,都是来自上海交通大学和商汤科技研究院的两项工作
这篇 Blog 介绍一下跟训练效率相关的内容,来自于两篇主要通过 Packing 技术解决 VLM 和 LLM 中 Load Unbalance 的 Paper,都是来自上海交通大学和商汤科技研究院的两项工作
在解读论文之前,先对 Data Packing 进行一个简单的介绍,现在看来它是一种很常见的消除组内 Padding 的方法。如下图所示,左边是我们一般组 batch 的方式,绿色是文本原本的 token,灰色是 Padding 的 token,这样子组 batch 的缺点在于会浪费算力去算灰色的 token(这些token 是原本不需要去计算的)
当我们采用 Packing 的方式去组 batch 时,就不存在这个问题了(如右边)。需要考虑的是怎么样才可以使得组到我们想要的长度(尽量将算力全用到有效的地方)以及会不会给 loss 计算带来问题

Packing 示意图 OmniBal
介绍的第一篇论文是 Towards Fast Instruction-Tuning for Vision-Language Models via Omniverse Computation Balance,OmniBal 是 Omniverse Balance 的简称。它主要是针对多模态模型训练效率的优化,论文中分别在 DeepSpeed 和 Megatron 上对当时的 Internvl 和 Qwenvl 进行了实验。提出从三个方面来对训练进行优化:data、model 和 memory,接下来我们进行一一介绍
Data Imbalance
经过我开头对 Packing 的介绍,很容易知道一般的组 batch 方式很容易造成 token 计算的浪费。其实除了这个问题,如下图所示我们考虑 DP 层面,由于各个 DP 中 mini-batch 数据长度总和不一样,那么各个 DP 的计算量也就不一样,从而致使可能计算量小的 DP 等待计算量大的 DP 的情况当然你可以将数据都 Padding 到固定长度,但这样的话就会浪费更多 token 的计算 。假如我们能把每个 DP 的数据 Packing 到一样的长度这里是假设计算量和数据总长度大致线性相关时 ,就可以解决这个问题

传统组 batch 的劣势 文中使用了一种称之为 Iterative Sampling Filtering 的算法来进行 Packing,具体流程如下伪代码所示,首先是 sampling 阶段:
def sampling(data_list):
	group = []  # 当前进行 pack 的组,eg: [data1, data2, ...]
	# 存在已经满足条件的组, eg: [[data1, data2, ...], [data4, ...], ...]
	groups = []
	vit_len_sum, total_len_sum = 0, 0
	for data in data_list:
		vit_len, total_len = data
		# 当前的长度满足所设定的最大值 vit_length total_lenth 时,完成该 group 的 packing
		if vit_len_sum + vit_len > vit_length or total_len_sum + total_len > total_lenth:
			groups.append(group)
			vit_len_sum = vit_len
			total_len_sum = total_len
			group = [data]
		else:
			# 否则直接加入该 group
			group.append(data)
			vit_len_sum += vit_len
			total_len_sum += total_len
	groups.append(group)
	return groups
由上面的代码可是得知,组好的 group (除了最后一个)都是在差一条数据的情况就达到组 group 条件之一:group 的 vit 数量之和大于设定 vit 的最大值
vit_length;group 数据长度之和大于设定的长度最大值total_lenth。那么就会存在一个问题,如下图所示黄色部分是阈值长度,group1 和 group2 都差一条数据(灰色部分)达到阈值从而组成了 group,但是他们之间也会存在长度差距
sampling 结果示意图 所以,需要筛出离指定阈值差距较大的 group,如下进行 Filtering 阶段:
def filtering(groups):
	filter_groups = []  # 用于存放满足过滤条件的 group
	need_resampling_data = []  # 需要再进行 group 的数据
	for group in groups:
		group_vit_len = sum_vit_len(group)
		group_total_len = sum_total_len(group)
		# total_lenth >= group_total_len > total_length_thresh 满足组好的条件
		if group_vit_len == vit_length or group_total_len >= total_length_thresh:
			filter_groups.append(group)
		else:
			need_resampling_data.extend(group)

	return filter_groups, need_resampling_data
对于需要重新 sample 的数据
need_resampling_data,我们可以再次放进sampling进行组 group,然后filtering,如此循环,体现出了 Iterative Sampling Filtering 中的 Iterative。经过这样的算法,得到的 Packing 结果的总长度可以控制在一定的范围内,使各个 DP 间得到较好的 balanceModel Imbalance & Memory Imbalance
这两个优化是建立在 Data Balance 之上,当 DP 拥有了近似计算量的输入时,需要考虑对于 VLM 怎么去设置 PP 划分是更合适的。其原因是 VLM 是一个异构的架构,单纯的参数或者层均分都可以造成 PP 之间的计算量不均衡的情况
论文使用了一种 profile 每一层的 forward 时间,那么就能得到总的 forward 时间。假如要对模型进行 PP 3 的切分,也就是需要找到中间两层作为切分点,由于有 forward 时间信息,很容易找到能均分 PP 时间的两层,假如是
\[\text{VAR}(\text{fwd_time}) = \sum_{i=1}^{N} \left(\text{FWD}(S_i) - \overline{\text{FWD}(S_i)}\right)^2\] \[\text{SUM}(\text{comm}) = \sum_{i=1}^{N-1} \text{ACTIV}(l_{pi})\]layer_m和layer_n。另外论文还会找这两层上下层一起作为候选的切分层,因此对于 PP 切分点1 有[layer_m-1 layer_m layer_m+1]三层,同理对于 PP 切分点2 也有同样的三层,总的切分办法一共是 9 种。那么怎么衡量这 9 种方法哪种更好呢,文中提出了一下指标:\(\text{VAR}(\text{fwd_time})\) 是各 PP 的时间与均值时间的差值总和,\(\text{SUM}(\text{comm})\) 是各 PP 之间激活值(应该是每个 PP 中最后一层的输出)通信量的总和。也就是文章考虑了计算和通信两个层面来进行选择
对于 memory 是对于不同长度的输入,来调整 model 需要开启 checkpoint 的层数,本质上是尽量提高显存的利用率,减少重计算的层数,从而提高训练效率
Performance

deepspeed 和 megatron 上的表现 可以看到,在两种后端的提速表现都非常明显,而且保证了精度没有明显损失的情况

不同 size model 上的表 在不同 size 的模型上也进行了速度验证,最快有超过 3 倍的提速!
HBP
HBP 是 Hierarchical Balance Packing 的简称,来自论文 Towards Efficient Supervised Fine-tuning for Long-Context LLM。有了上面的基础,比较容易理解 HBP,实际上这篇论文解决的问题很清晰:训练长文本时,难免出现其他长度的数据或者想和其他长度的数据训练(128k 和 32k 8k 混训),那么如果全都 Packing 到 128k,在开 SP 的情况下会存在 all to all 通信浪费
论文的实验都是基于 DeepSpeed 为后端进行的,整体的 Framework 如下图所示

HBP Framework 在 OmniBal 中我们介绍了可以通过调整开启 checkpoint 的层数来减少重计算从而加速训练,那么现在当开启 SP 时,SP 开得越大,空出来的显存越多,多的显存可以用于减少开启 checkpoint 的层数,但是 SP 越大通信就越耗时,所以这俩需要进行均衡取舍的,上图中的 Hierarchical Groups Auto-Selection 就是干这个事
当对于每个 length 确定了该用什么样的 checkpoint 和 SP 后,就可以进行 Hierarchical Packing 了。由上图可知,对数据按照 length 进行分组后,先 Packing 较长的 length,并用短的数据进行尝试填充,使其尽量 Packing 到指定长度,然后再 Packing 短的
接下来详细介绍这两部分以及为了训练稳定做的课程学习和 Loss 修改部分
Hierarchical Groups Auto-Selection

Auto-Selection 算法 整个流程,首先对每个 length 在开某个 SP 的条件下,尽量去尝试不开 checkpoint 的最大层数,比如对于 32k 开 SP 为 2 对应不开的 checkpoint 的最大层数为 0(即需要全开),继续 profile SP 为 4、8 不开 checkpoint 的层数(尽量不要超过 8 因为节点间通信慢),最后得到 32k 在 SP 为 8 不开 checkpoint 层数为 24 层是 32k 所有配置中最快的,同理我们可以得出 128k、64k 以及 16k、8k 的最快对应的 SP checkpoint 配置,同时我们也可以得出最快的 length 是哪一个,如下图则是对 LLama 8B profile 的配置结果(注意这里的每个 iter 会调整 gradient accumulation step 来使得每个 iter 过的 token 数量一样)

各 length 结果 一般来讲,profile 的最大 length 是我们需要训练的最大 length ~ \(l_{max}\),\(l_{max.sp}\) 为 \(l_{max}\) 最快的 SP 配置,这个 length 一定在我们的训练 config 中。最快的 length(如果不是 max)也是需要加到 config 这里标记为 \(l_{best}\) 和对应 SP \(l_{best.sp}\),这两个配置是一定有的,另外我们需要考虑长度为 \(l_1=l_{best}/l_{best.sp}\) 以及 \(l_2=l_{max}/l_{max.sp}\) 可以理解为这两个 length 是 max 和 best SP 后每个 rank 跑的 length,对应的 SP 设置为 1(即没有 all to all 通信,一个 rank 是一个 DP)。如果 \(l_2 \lt l_{best}\) 则直接并入 \(l_{best}\),因此最后最多有四组 Packing length 的设置,最少有三组
Balance Packing
经过了上述的 profile 后,我们可以根据需要训练的 length 对数据进行分组,从 length 最长的组进行 Packing,由 OmniBal 的 ISF 可知,可能存在一些组未到
length_thresh的标准,这个时候 HBP 的做法则是一次从后面的组取出 sample 进行补充 Packing 直到达到 thresh 或者遍历完,如下为伪代码所示:# packed_samples 为已经用 ISF Packing 过的 groups for sample_id_l, sample_l in enumerate(packed_samples): llm_num = token_sum(sample_l) # 如果 group 长度达到 thresh,即 pack_thresh < llm_num < pack_length 则略过 if llm_num > packed_thresh: continue # g_id 越小,里面的数据长度就越小,比如 grouped_samples[0] 都是还未 Packing 的 8k 以下的数据 for sub_g_id in range(g_id-1, -1, -1): for sample_s in grouped_samples[sub_g_id]: if llm_num > packed_thresh: break # 如果该 sample 用于去 Packing 更长数据组了,则需要改正其 g_id # 不再加入原长度组的 Packing if sample_s['group_id'] == sub_g_id and llm_num + sample_s['token_num'] < packed_length: sample_s['group_id'] = g_id packed_samples[sample_id_l].append(sample_s) llm_num += sample_s['token_num']最后 Packing 数据的形式会是怎么样呢,如下图所示:

packing 结果 可以看到对于
g_id=2会有来自短数据的来进行充分 Packing,对于g_id=1是由两个小包组成一个大包,每个 DP 分到一个小包,如果还需要 SP,则每个 rank 实际跑的数据长度会更小这里有 2 个细节需要处理:
- 对于每一个层级需要设置不同的 SP group
- 对于每一个层级的 gradient accumulation step 不同
Curriculum Learning & Stable Loss Normalizer
这两个都是为了稳定训练的,前者是通过调整数据训练顺序让短数据先训练一部分,使模型能先适应数据的类型。后者则是为了缓解 Packing 给长短数据带来的影响,比如如果长数据和短数据一起训的时候,由于是长短数据一共的 token 数作为 normalization,那么短数据的 loss 贡献程度必然会被大幅度削减,从而影响较短数据优化。文中使用一个 global batch size 的 token 作为 normalization 实际上使用了一个常数,这样保证梯度不大而且各长度数据 loss 贡献不变
Performance

HBP 结果 可以看到加速效果非常明显,这里 balance 是指对于有没有按照包总长度平方进行 sort(这里是对 attention 那的计算量做了一个均衡)
以上便是关于两篇论文的全部内容了
-
♣ AI 之旅之从识图到读书
📅 August 15, 2025 📂 LIFE
这是我对过去三年工作的一个小总结。TS 公司是我毕业后加入的第一家公司,所在的部门是公司研究院下所在的部门。
这是我对过去三年工作的一个小总结。TS 公司是我毕业后加入的第一家公司,所在的部门是公司研究院下所在的部门。部门的整体氛围很好,上下级之间、同事之间都能愉快的相处,这使得我这期间的工作生活很顺心。回到工作内容部分,总体而言可以分为两部分的工作:CV 和 LLM
Computer Vision Period
我研究生期间的研究方向是深度学习目标检测(DeepLearning Detection),有一段在华为中央研究院实习的经历,在研究生阶段参加过几次百度举办的 算法复现比赛以及贡献过相应的开源项目。入职后,接手的第一个任务就是复现 YoloV6 算法,因为硕士期间参加过百度的复现比赛百度的大佬也对我进行过一些代码和复现方法上的指导 ,所以上手还算顺利
复现
没错!从上面可以看出来,我的第一个主营业务就是复现,所谓复现就是把别人的算法加到自己的训练框架里面不管你 copy 也好,自己重新搭网络结构也好 。最终的目的是:在我们的框架用相同的 config 能去训练这个算法并在测试集上跟官方 paper 的公示精度指标一致
那么我在这个阶段复现了哪些算法呢?主要是一些当时 SoTA 的目标检测算法:YoloV6、Onenet、YoloV7、DINO 等当然其实在之前参加百度复现赛和 PaddleDetection 做开源贡献时,复现过 Retinanet、ATSS、Fast RCNN、Faster RCNN 以及 Sparse RCNN 算是非常适合这个岗位了 。当然在做完算法复现后,我们常常会做一些组合操作来探索算法的特性,像各种标签匹配:OTA、简化版 OTA、匈牙利算法匹配、TAL 等等,各种分类的 loss、框回归的 loss 以及辅助 loss 等等,我们会将上述的和不同的网络结构以及数据增强的方式进行组合搭配,看看有什么化学反应,能不能训练出比较厉害的 baseline model 出来。总之 CV 时代,前处理、网络结构、后处理,都玩得很花
Other
除了复现和日常的框架维护、代码迁移和答疑外,也有做一些其他方面的探索,主要分为以下几个方面:
- 对于 Onenet 的改进,使用单 anchor 或者 point 来预测框,主要是对框的个数以及 anchor 的设置以及添加 iou branch 的探索。简化为单 anchor 或 point 后,对于推理时简化了后处理流程,会有提速效果。当然这里不乏数据增强的加持,才能保证点不掉,其中把目标复制多个的数据增强提升最明显也很容易理解,主要增加了正样本数量吧
- 参与了一个可视化检测结果的工作虽然没什么人用,是为了几个人做的需求 ,并且打通了训练完的模型能自动化的进行精度测验以及 base case 可视化
- ri4rover 比赛训练模型这个比赛的重点不是模型训练这块,所以只能算是跟着大佬混了一下 ,包括:数据划分、多尺度实验 、anchor尺度实验、学习率实验、数据增强实验、cos-ema 实验、标小车数据。由于任务比较简单,最后采用单 stride 提取特征图,速度上有非常明显提升
- 调研了一下当时比较火的两个项目 segment anything 和 GroundingDINO。这两个项目给到的启示是:数据标注层面(人工到半人工到模型)和语言与视觉的 Pipline 的打通。同时也跑通了他们的推理 Code,加到了框架里面。由于 SAM 只支持二分割,尝试进行多类别分割,效果不行
- 最后是跟车有关的项目:主要是地面标识的识别和分割。一部分是需要跟外部合作(最后不了了之),另外一部分看看能不能降低自己的标注成本。技术路线也很简单:首先上大模型进行训练,然后根据 bad case 情况是否需要补充数据或者对于不同检测或分割的物体进行不同分辨率模型或 head 进行检测或分割。最后都基本到达了要求,标注成本也有个 30% 左右下降。这期间也尝试过 SAM 和 groudingdino 的方案,以及将他们串起来
以上是一些主要部分,当然也有一部分时间在跑其他部门的屎山代码。这个期间我们组整体工作还是做得不错的。我们不仅维护了一个易用且算法和功能丰富的 CV 训练框架,而且进行了大量的算法探索(虽然大部分是排列组合与缝合),算是即懂算法也懂框架
Large Language Model Period
随着 openai 点燃了大语言模型的火焰,世界也看到了 LLM 的巨大潜力。我们整个部门也进行了及时调转船头支持 LLM 训练、推理以及量化了。由于模型同质化非常严重,结构基本一致,所以训练将重心放在了训练框架上
框架的搭建
虽然本质上我们是基于 DeepSpeed 和 Megatron 之上搭建的缝合怪,但是在那个时期可用的外部框架并不多,所以还是对内部有用的工作。而且框架初期有非常多的杂事需要做,比如,需要不断和外部框架进行精度和速度的对齐、新的模型(qwen internlm baichuan)的精度对齐、新的算子接入时的精度对齐、各种保存模型时的问题、模型加载的问题、dataloader 报错问题、flash attention 接入的问题、打各种镜像、支持各种需要的数据前处理(预先 pack 的,纯文本和 vqa 数据混训)、模型转换(ds 和 mg)以及长文本训练的支持
在对齐的路上遇到过各种奇葩的问题,例如:两边某个层里面一个系数的数据类型不同、数据处理逻辑不通、环境问题(未指定统一版本 cuda)、lr scheduler 不同。总是每天上一当,当当不一样
Load Unbalance
借着和 VLM 团队的合作,我们在 data 层面一定程度解决了在 VLM 训练中的负载不均衡问题,虽然原本的任务只是把内部的模型改到使用 Megatron 进行训练。
首先使用 packing 技术解决了 batch 内 padding 浪费的问题与 DP 之间计算量不均衡等待的问题。同时发现了长短文本混训且在使用 SP 时,存在由短文本 packing 组成的长文本被 SP 后,有不必要的 all to all 通信浪费。对此,我们使用了先组成小 group,再由小 group 组成设定长度的大 group,控制 batch collector 与 sampler 让 rank 拿到属于自己 group 以及保证一个 global batch size 内都是同一种类型的数据(要么是纯长文本,要么是短文本组成的长文本)。另外我们还对 Megatron 内 PP 和 CKPT 的设置使用了 profile 的方式求出最佳值。这部分内容我们整理成了论文发表在了 ICML 2025 上,也是我的第一篇顶会论文

VLM Packing 算法 无独有偶,我们在与 LLM 团队合作时,同样对当前的 LLM 中 load unbalance 和 packing 技术进行优化。针对长短文本混训的场景,采用分层级的 packing 策略,首先确定最长训练长度为 128k,通过 profile 得出其最快的 SP 和 CKPT 配置,假设是 SP=8。那么我们还需要一个配置是 16k(128k/8) 的 group,得到 16k 的 SP 为 1 以及 profile 好其最佳的 CKPT 配置,然后我们需要组好 8 个 16k 的 group 给 8 个 rank。另外假如我们 profile 发现 32k SP=4 是最快的配置,那么需要加入一个 32k 的配置,然后去除 16k 的配置(虽然 16k 没 all to all 通信,但是有最快的为啥不用),最后整理一下就是会有两个层级 128k SP8 和 32k SP4,32k 以下的只 packing 到 32k。假如最快的是 8k SP1,那么则有 128k SP8、16k SP1 和 8k SP1,8k 以下的只 packing 到 8k。最后我们通过控制 sampler 做了课程学习以及 loss normalization 的改进,这部分也整理成了论文处于在投状态

Hierarchical Batch Packing 示意图 论文这部分工作,我主要的工作在实现算法和处理数据,以及做实验、测验模型精度等
Other
最后来自于一些杂七杂八的探索和调研,包括 deepseek R1 训练特性的探索、FP8 训练的适配看了 deepgemm,deepseek 的工程能力真的太强了 、视频训练(主要是 internvl 和 qwen vl)的调研等等
总结和安排
可以看到,在 LLM 时代大部分做的事还是以 Infra 为主的,但整体的工作比较上层,不够深入,这是需要改进的地方。之后可能会去做 LLM 算法相关的工作,也是转了一个方向,目前我对 LLM 训练的认识是 LLM 训练中两个最重要的点:数据的生成和筛选和训练的 pipeline。需要学习的地方还有很多,加油吧少年~
-
♣ DETR SERIES
📅 May 19, 2023 📂 AI
🎍本篇文章主要对 DETR 的相关类容进行简单的介绍,内容涉及DETR、Deformable DETR、DAB-DETR、DN-DETR 和 DINO 等 Transformer 在目标检测领域应用的算法。
🎍本篇文章主要对 DETR 的相关类容进行简单的介绍,内容涉及DETR、Deformable DETR、DAB-DETR、DN-DETR 和 DINO 等 Transformer 在目标检测领域应用的算法。
DETR
Framework

DETR 算是 Transformer 在视觉领域应用的第一篇文章,至少是我读过的第一篇,即 End-to-End Object Detection with Transformers。可以看出 image 通过 CNN 或者 Transformer 作为 backbone 进行提取 feature,然后经过 Transformer 进行进一步的特征提取,最后送入检测头预测。
Transformer

显然在 DETR 中最重要的就是 Transformer 了。其是由多个 encoder 和多个 decoder 组成。decoder 的第二个多头注意力 (Multi-Head Attention MHA) 将 encoder 的输出作为两个输入。实际上 MAH 中主要由点积放缩注意力算子组成,大概可以看到其由 Query、Key 和 Value 三者作为输入,进行一系列矩阵操作得到结果。

通过上图可以简单对点积缩放注意力算子进行介绍。每一个 Embedding 可以生成对应的 Q、K、V ,然后每一个 Embedding 的 Q 都会跟 n 个 K (包括自己的)进行向量内积计算,从而得到 n 个 值,再通过 softmax 得到 n 个权重,最后和 n 个 V 相乘得到了最后的结果。这个过程可以通过右边矩阵相乘实现,里面涉及两个矩阵乘法 Q x K,其结果和 V 进行矩阵相乘。而对于 encoder 而言,Embedding 的个数是和 image 的尺寸成正比,那么其矩阵相乘的计算复杂度就和 image 的尺寸就成平方关系了。
Deformable-DETR
Motivation
Deformable DETR 这篇文章是商汤发表的文章。在这篇文章里面,认为 DETR 收敛慢的原因在于训练初期由于初始化的因素,模型对特征图的关注是非常均衡的,但是我们训练的目的是为了突出一个位置进行特别的关注,因此要想达到这种效果,原 DETR 需要经过较长时间的收敛。受到可变形卷积的启发,于是想到能不能做可变形注意力机制来进行加快收敛。
Framework

从上图我们可以看出,对于特征图的每一个位置会生成参考点(reference point),并且通过 Query 来生成相应的 sampling offsets,图中的是每一个点会生成三个 offsets 代表由三个偏移点来生成这个点的特征值,而这三个偏移点的权重也是由 Query 生成的 (Attention Weights)。从这里看到其中没有涉及矩阵乘法,因此和 image 的尺寸是成线性关系的。
Focus
- deformable attention
最核心的地方应该在于如何进行可变形注意力的计算了,可见下面两行代码:
  sampling_offsets = self.sampling_offsets(query).view(N, Len_q, self.n_heads, self.n_levels, self.n_points, 2)

  attention_weights = self.attention_weights(query).view(N, Len_q, self.n_heads, self.n_levels * self.n_points)
这里的 self.n_points 一般为 4,Len_q 为 query embedding 的个数,在 encoder 里面则为 Hi * Wi,decoder 中则为需要预测 boxes 的个数。这里对每一个位置生成了 4 个采样点的偏移和4 个采样点的权重,这个偏移加上基础点的位置得到最后采样点的坐标(这里是不是很像 anchor + offsets 的感觉),得到坐标之后就可以用双线插值法得到这些点的 Value,乘上
attention_weights就能得到最终的输出了。这里是其 pytorch 的实现 cuda 实现也基本一致 - two-stage & iterative bounding box refinement 这里讲的是从 encoder 里面出来后的输出的使用,和如何不断在 decoder 中迭代每一个 decoder layer 的输出。 首先前者会通过 encoder 得到每个位置的偏移预测和分数,通过分数选出 topk 的 proposal,这里我们有他们的偏移和 anchor 的位置,肯定也能得到其最终坐标,这个坐标就是进行 decoder 中起始的 anchor 坐标。通过对得到的坐标进行维度的转换得到进入 decoder 的query 和位置编码。源码位置在这里。 后者 boxes 的迭代可以理解为每个 decoder layer 层对 boxes 进行 refine 送入下一层中作为起始的 anchor 坐标。这里是不是很像 Cascade RCNN 的思路
最终效果也是非常明显,将 Epoch 从 500 降低至了 50!
DAB-DETR
从这篇文章开始,都是粤港澳大湾区数字经济研究院的工作了,接下来的三篇文章基本都是基于 Deformable DETR 之上进行做的,基本是针对 DETR 收敛速度的研究。因此只介绍基于 Deformable DETR 之上的版本。
Motivation

文章通过前人的经验得出,导致 DETR 训练速度慢的原因很大可能是因为 decoder 中 cross attention 这个模块,由上面的对比可以看出其与 self attention 的区别主要就在于 query 的不同。文章猜想两个原因:query 比较难学和 query 的位置编码方式不对。
Framework

文章分别进行了实验:1、使用训练好的 query 来进行实验,发现并没有加快收敛;2、对 decoder 的位置编码改为正弦位置编码,并让 query 中的一个 embedding 关注一个位置发现收敛变快。最终得到上述的网络框架,通过编码的 anchor 会和 query、key 结合,当然这种情况仅限与 DETR 的改动,在 Deformable DETR 里面仅仅对位置编码进行重新调整了一下,源码在这里。
Focus
这篇文章里面还有一些其他改进,但是经过我的实验发现可能只是对这个模型有效,所以就没介绍。我觉得其最重要的是,它告诉了我们 decoder 里面的 query 到底在学什么?它就是位置的先验,最后出来的也是有多少 embedding 就有多少的框。这是文章最重要的意义,也指引后面的工作可以朝着这个方向去努力。
DN-DETR
Motivation
DN-DETR 从另外一个方面来探索 DETR 收敛慢的原因,那就是匈牙利算法匹配的不稳定性。比如经常出现这个 anchor 在上一次的匹配中是匹配给 GT1 的,但是这一次就匹配给 GT2 了,这使得 anchor 老是换来换去学习,从而致使收敛慢。那么这个问题是由什么引起的呢?
经过前面几篇论文的探索,我们可以把类 DETR 的学习氛围两阶段:good anchor 和 relative offsets 的学习,前者是在 encoder 中学习,后者的微调是在 decoder 中的。然而good anchor 容易办到,offsets 的学习却难。因此,文章认为导致匹配不稳定的因素主要是这个。offsets 的学习质量可以用 L1 loss 很好的量化,文中也涉及了一些指标来量化是否稳定。从实验上看,确实 L1 更稳定时,匹配也稳定,这两者是相辅相成的。
Framework

其实可以看到,与 DAB-DETR 相比,最大的差别仍然在 decoder 处,主要是 query 的输入。DN-DETR 认为我们可以把对 offsets 的学习,看作一种对噪声学习的过程,因此,可以直接在 GT 周围生成一些 noised boxes,这些 boxes 是 GT 进行稍微移动得到的。然后将得到的 noised boxes 转化为高维的 embedding 与原本的 query 进行 cat,同时这些 noised boxes 的类别本应该是 GT 的类别,但是为了学习类别的噪声,因此将其任意翻转到其他类别再进行 embed。最后希望通过模型的学习,将 offsets 学好,同时把类别整对。这里可以看作增加了很多 good anchor 供模型学习,而且这些 boxes 最后不用参加匈牙利匹配,因为它们是由某个 GT 演化而来,从出生开始就已经形成了天然的匹配。
Focus

那么还有另外一个问题没有解决,就是生成的 noised boxes 是带有 GT 信息的,不能被由正常 query 预测的 boxes 在进行注意力计算的时候学到。因为真正到推理的时候,就没有人给你提供 GT 的信息了。文章通过上图中右边的 attention mask 来对其进行了屏蔽。灰色的是信息不相通的,对于生成的部分 (denoising part) 互相看不见,自己只能跟自己玩,生成的部分可以看见正常预测的部分 (matching part),但是正常预测的看不见生成的部分。这里很合理,因为正常预测的部分不含有 GT 信息,被不被看到无所谓。(这个 mask 的看法为:group1 横着对出去灰色的是看不见的,彩色的看得见,其余皆是如此。
最后收敛效果也很显著,只需要 12 epoch 就能达到 44.1 AP
DINO
DINO 则是这个系列的集大成者,代码的话建议看这个,原 repo 感觉有点乱。DINO 整体的 pipline 没有太大变化,主要基于 DN-DETR 在三个方面上进行了改进。

Contrastive DeNoising Training

首先动刀的地方在加噪声这个环境,之前 DN-DETR 的噪声实际上只有正样本的噪声没有负样本的,因此 DINO 在生成正样本的同时也生成了高质量的负样本噪声,简单来说就是负样本噪声离 GT 比正样本噪声更远,宽高形变更严重。这样做主要使得小目标检测的效果变化好了,不过论文好像没有研究这个的原因。
It can inhibit confusion and select high-quality anchors (queries) for predicting bounding boxes
Mixed Query Selection

这里对比了一下 Deformable DETR 和 DINO 进入 decoder 前 query 和 position-embedding 的生成。可以发现 DINO 的 query 并没有由 proposal 来生成,文章是这样说的:
As the selected features are preliminary content features without further refinement, they could be ambiguous and misleading to the decoder
Look Forward Twice

其实差别就在于,上一层的 points 需不需要 detach 后再送入下一层进行 refine,文章是这样说的:
However, we conjecture that the improved box information from a later layer could be more helpful to correct the box prediction in its adjacent early layer
虽然论文讲了挺多,后面两个改动,在代码中的表现就一行。文章的消融实验其实没有太大对比性,因为文章中消融实验的 AP 为 47.9 是 DINO-scale 的精度,但是 repo 的精度已经到了 49.0 了。不过有一说一这确实厉害,12 epoch 能跑出这个成绩!
至此从 DETR 到 DINO 的就讲完啦🍇🍇🍇
- deformable attention
最核心的地方应该在于如何进行可变形注意力的计算了,可见下面两行代码:
-
♣ CUDA 编程(进阶篇)
📅 February 9, 2023 📂 AI
GEMM 优化本身是一个非常值得讨论的课题,其优化也涉及 GPU 中优化的大多数常用的技巧。这部分以解析知乎大佬有了琦琦的棍子文章中的代码进行解读,也作为代码阅读笔记梳理整个思路
GEMM 优化本身是一个非常值得讨论的课题,其优化也涉及 GPU 中优化的大多数常用的技巧。这部分以解析知乎大佬有了琦琦的棍子文章中的代码进行解读,也作为代码阅读笔记梳理整个思路
General Matrix Multiplication
首先,其优化技巧分块计算、shared memory 的多次利用、register 的多次利用以及各种 bank 的 conflict 解决,有的甚至会涉及到汇编层面的优化,这里有些技巧在基础篇已经讲过,就不再赘述了。
其次,简单叙述一下优化的思路,主要的思路就是对矩阵进行分块计算,不同 block 负责计算出 C 中的不同部分,同时在 block 内又让不同线程负责不同部分,这里面为了能多次利用 shared memory,需要进行多次循环,因此在 block 内有多次大循环,在大循环内又有每个线程中的多次小循环。因为涉及到把数据不断搬到 shared memory,所以作者设计了预取 prefetch 的做法,这样做可以掩盖 io 的 latency,因此也要设计哪些线程搬运哪些数据。由于可能在访问 shared memory 的时候有 bank conflict,所以也要设计哪些线程访问哪些内存
分块计算的思路
首先如下图,对 C 进行分块:

由图可知,C 被分为 MxN/BlOCK_SIZE_M/BlOCK_SIZE_N 块,每块的大小为高 BLOCK_SIZE_M,宽 BLOCK_SIZE_N,每一块对应 A 中的相应行,对应 B 中相应列。其中一个块交给一个 block 来计算,在本次示例中,A、B、C 都是 2048 的方阵,每块的大小为 128 的方阵,因此需要 256 个 block。
对于每个 block 而言,实际上是 A 中的某些行形成的矩阵(Ai)和 B 中的某些列形成的矩阵(Bi)进行矩阵乘法得到的。如上图所示,我们可以对 Ai 中的按列进行再一次划分(Aij)和 Bi 中按照相同的规则按行再次进行划分(Bij),其实可以发现 Ai 中的第 i 列只会和 Bi 中的第 i 行进行相应的运算,其实运算结果的矩阵就是 128 的方阵,所以其实 Ai 和 Bi 的矩阵乘法结果也可以看成多个 128 方阵的累加结果。对于一个 block 来说要进行 K/BLOCK_SIZE_K=8 次循环,然后将结果进行点对点叠加得到

对于每个 Aij 和 Bij 进行矩阵乘法的时候也不是直接按传统的 Aij 的某一行与 Bij 的某一列进行向量相乘得到最终结果的一个元素来算的,我们每次只计算 Aij 中的第 m 列和 Bi 中的第 m 行的运算结果。这实际上是有考虑 shared memory 的 bank conflict,并且虽然我们设定每个线程在每次小迭代中只计算 Aij 中的 8 个元素和 Bij 中的 8 个元素运算的结果,然而这 8 个元素并不是紧挨着的,如上如可知,我们开了 256 个线程来计算这 128x128 的矩阵,每个线程负责 64 个元素。256 个线程一共 8 个 wrap,我们需要使得每个 wrap 内不发生 bank conflict。上图展示了这个 8 个 wrap 负责的位置,以及 wrap 内线程的负责情况。下面先详细介绍一下 bank conflict:
Bank Conflict

在 shared memory 中的连续的内存被放入 32 个 bank 中,通常每 4 Bytes 一个 bank。如上图所示,一个 float 或者一个 int 占某一个 bank 中的一格,因此可以将一个 bank 理解为一个内存块,一个 bank 是一列,32 个 bank 组成 shared memory。一般 shared memory 的大小是 64 KB,也就是说一个 bank 最多有 2000 Bytes(500 行)。当我们给一个 wrap 中线程分配访问 shared memory 的地址时,也就是分配哪一个线程访问哪一个 bank 中的哪一格。什么是 bank conflict?当 同一 wrap 中 的 不同线程,访问 同一 bank 中的 不同地址 ,此时不能并行访问,只能串行,所以会导致速度下降。shared memory 中的访问可能性:
- 不同线程,访问不同 bank;这种情况是最希望的,因为可以并行访问
- 不同线程,访问同一 bank 中的同一地址(同一格),这种情况 gpu 会自动广播给所有线程,因此不影响速度
- 不同线程,访问同一 bank 中的不同地址(比如有 64 个线程,一个线程访问 4 Bytes,那么第 0 线程访问的 0,第 32 线程访问的 32,他们都属于 bank 0)这时候就会 conflict
为何不讨论不同 wrap 之间的 conflict 呢?因为不同 wrap 不能同时访问 SM 中的 shared memory。关于如何解决呢? 目前一般有两个办法:
- 对 shared memory 开辟的长度进行改变,比如 32x6,对 0 线程而言 ,tid x 6 / 32,那么 16 线程就会发现冲突。如果将其改为 32 x 7 就不会了
- 对线程访问的地址进行设计,使其不会冲突
最后我们基于他的代码进行分析和学习(源代码注释也挺清楚的了):
template <
    const int BLOCK_SIZE_M,  // C 中每个分块的高
    const int BLOCK_SIZE_K,  // A 中每次需要搬到共享内存块的宽
    const int BLOCK_SIZE_N,  // C 中每个分块的宽
    const int THREAD_SIZE_Y, // C 中每个分块中一个线程需要计算的块的宽
    const int THREAD_SIZE_X,  // C 中每个分块中一个线程需要计算的块的高
    const bool ENABLE_DOUBLE_BUFFER // 是否开启预取
    >
__global__ void Sgemm(
    float * __restrict__ A,
    float * __restrict__ B,
    float * __restrict__ C,
    const int M,
    const int N,
    const int K) {
    // Block 索引
    int bx = blockIdx.x;
    int by = blockIdx.y;

    // Thread 索引
    int tx = threadIdx.x;
    int ty = threadIdx.y;

    // 一个 block 线程的总数
    const int THREAD_X_PER_BLOCK = BLOCK_SIZE_N / THREAD_SIZE_X;
    const int THREAD_Y_PER_BLOCK = BLOCK_SIZE_M / THREAD_SIZE_Y;
    const int THREAD_NUM_PER_BLOCK = THREAD_X_PER_BLOCK * THREAD_Y_PER_BLOCK;

    // 线程在当前 block 中的索引
    const int tid = ty * THREAD_X_PER_BLOCK + tx;

    // 为搬运 A、B 矩阵,开了两份共享内存
    __shared__ float As[2][BLOCK_SIZE_K][BLOCK_SIZE_M];
    __shared__ float Bs[2][BLOCK_SIZE_K][BLOCK_SIZE_N];
    // 在寄存器上开辟了记录累积结果以便把最终结果搬到 C 中
    float accum[THREAD_SIZE_Y][THREAD_SIZE_X];
    #pragma unroll
    for(int i=0; i<THREAD_SIZE_Y; i++){
        #pragma unroll
        for(int j=0; j<THREAD_SIZE_X; j++){
            accum[i][j]=0.0;
        }
    }
    // 当前线程为搬运共享内存到寄存器上所开辟的内存
    float frag_a[2][THREAD_SIZE_Y];
    float frag_b[2][THREAD_SIZE_X];
    // 这里计算每个线程每次搬运 4 个 float 需要搬运的次数(从 global 搬到 shared 上)
    const int ldg_num_a = BLOCK_SIZE_M * BLOCK_SIZE_K / (THREAD_NUM_PER_BLOCK * 4);
    const int ldg_num_b = BLOCK_SIZE_K * BLOCK_SIZE_N / (THREAD_NUM_PER_BLOCK * 4);
    float ldg_a_reg[4*ldg_num_a];
    float ldg_b_reg[4*ldg_num_b];

    // 搬运一行需要的线程数
    const int A_TILE_THREAD_PER_ROW = BLOCK_SIZE_K / 4;
    const int B_TILE_THREAD_PER_ROW = BLOCK_SIZE_N / 4;

    // 计算当前线程应该从哪一行哪一列开始搬运
    const int A_TILE_ROW_START = tid / A_TILE_THREAD_PER_ROW;
    const int B_TILE_ROW_START = tid / B_TILE_THREAD_PER_ROW;

    const int A_TILE_COL = tid % A_TILE_THREAD_PER_ROW * 4;
    const int B_TILE_COL = tid % B_TILE_THREAD_PER_ROW * 4;

    // 总体搬运一次需要跨过的行数 -- stride
    const int A_TILE_ROW_STRIDE = THREAD_NUM_PER_BLOCK / A_TILE_THREAD_PER_ROW;
    const int B_TILE_ROW_STRIDE = THREAD_NUM_PER_BLOCK / B_TILE_THREAD_PER_ROW;

    // 指向属于该 block 那个块的首地址
    A = &A[(BLOCK_SIZE_M * by)* K];
    B = &B[BLOCK_SIZE_N * bx];

    // 需要该线程搬运共享内存的索引(从 shared 搬到 register 上)
    const int warp_id = tid / 32;
    const int lane_id = tid % 32;
    const int a_tile_index =  warp_id/2*16 + lane_id/8*4;
    const int b_tile_index =  warp_id%2*32 + lane_id%8*4;
上面这份代码主要对需要的 index 进行了计算,其中
    // 需要该线程搬运共享内存的索引(从 shared 搬到 register 上)
    const int warp_id = tid / 32;
    const int lane_id = tid % 32;
    const int a_tile_index =  warp_id/2*16 + lane_id/8*4;
    const int b_tile_index =  warp_id%2*32 + lane_id%8*4;
这段代码的作用就是为了避免 bank conflict ,其效果如讲解分块时的图是一致的。首先,进行了计算该线程属于哪一个 wrap,在 wrap 中的局部 id 是多少,然后计算去共享内存搬运数据时从哪一个地址开始,举例说明:对于 A 矩阵需要搬运的共享内存而言,根据 wrap id 来确定大的位置(即这一片都是这个 wrap 需要搬运的数据,可参考前面分块画那个示意图)
warp_id/2*16得知每行两个 wrap,排完两个 wrap,跳(stride)16 个 foat。从lane_id/8*4可以看出 在 wrap 内 每行 8 个线程,也就是一共 4 行,4 行跳了 16 float,所以一个线程搬运 A 中的 4 个 float 刚好可以用 float4 这样可以访存对齐。由于开 256 个线程,一共 8 个 wrap 每行两个,一共 4 行,那才 64 float。但 A (转置后)一行有 128 个 float,所以需要搬运两次,因此一个线程搬运 8 个 float。需要的 index 计算完成后,接下来就是数据的搬运了
    // 首先将第一次大迭代相应的数据 global memory 搬运至 shared memory
    #pragma unroll
    for ( int i = 0 ; i < BLOCK_SIZE_M ; i += A_TILE_ROW_STRIDE) {
        int ldg_index = i / A_TILE_ROW_STRIDE * 4;
        FETCH_FLOAT4(ldg_a_reg[ldg_index]) = FETCH_FLOAT4(A[OFFSET(
            A_TILE_ROW_START + i, // row
            A_TILE_COL, // col
            K)]);
        As[0][A_TILE_COL][A_TILE_ROW_START + i]=ldg_a_reg[ldg_index];
        As[0][A_TILE_COL+1][A_TILE_ROW_START + i]=ldg_a_reg[ldg_index+1];
        As[0][A_TILE_COL+2][A_TILE_ROW_START + i]=ldg_a_reg[ldg_index+2];
        As[0][A_TILE_COL+3][A_TILE_ROW_START + i]=ldg_a_reg[ldg_index+3];
    }

    #pragma unroll
    for ( int i = 0 ; i < BLOCK_SIZE_K; i += B_TILE_ROW_STRIDE) {
        FETCH_FLOAT4(Bs[0][B_TILE_ROW_START + i][B_TILE_COL]) = FETCH_FLOAT4(B[OFFSET(
                B_TILE_ROW_START + i, // row
                B_TILE_COL, // col
                N )]);
    }
    __syncthreads();

    // 再把 shared memory 中的第一次小迭代数据搬到 register 中
    FETCH_FLOAT4(frag_a[0][0]) = FETCH_FLOAT4(As[0][0][a_tile_index]);
    FETCH_FLOAT4(frag_a[0][4]) = FETCH_FLOAT4(As[0][0][a_tile_index + 64]);

    FETCH_FLOAT4(frag_b[0][0]) = FETCH_FLOAT4(Bs[0][0][b_tile_index]);
    FETCH_FLOAT4(frag_b[0][4]) = FETCH_FLOAT4(Bs[0][0][b_tile_index + 64]);
可以注意到上一段代码,最后搬到 register 确实搬了两次。首先,这段代码将第一次大迭代需要的数据存入了 shared memory 里面,然后把第一次小迭代需要的数据存入了 register,其中:
FETCH_FLOAT4:是利用 cuda 中的类型 float4 而设置的宏,很明显一次可以取 4 个 float,可以避免访存不对齐的问题;ldg_a_reg:显然要想从 A 中搬运数据到存 A 数据的 shared memory 需要转置,此时不能直接使用FETCH_FLOAT4
接下来就是正式计算的代码了
// 作为预取数据的数组 index int write_stage_idx = 1; int tile_idx = 0; do{ // 大迭代中每次的 stride 为 BLOCK_SIZE_K tile_idx += BLOCK_SIZE_K; // 先将下一次大迭代的 global memory 中的数据考到 register 中 if(tile_idx< K){ #pragma unroll for ( int i = 0 ; i < BLOCK_SIZE_M ; i += A_TILE_ROW_STRIDE) { int ldg_index = i / A_TILE_ROW_STRIDE * 4; FETCH_FLOAT4(ldg_a_reg[ldg_index]) = FETCH_FLOAT4(A[OFFSET( A_TILE_ROW_START + i, // row A_TILE_COL + tile_idx, // col K )]); } #pragma unroll for ( int i = 0 ; i < BLOCK_SIZE_K; i += B_TILE_ROW_STRIDE) { int ldg_index = i / B_TILE_ROW_STRIDE * 4; FETCH_FLOAT4(ldg_b_reg[ldg_index]) = FETCH_FLOAT4(B[OFFSET( tile_idx + B_TILE_ROW_START + i, // row B_TILE_COL, // col N )]); } } // 作为加载数据的数组的 index write 为 0 load 就为 1 int load_stage_idx = write_stage_idx ^ 1; #pragma unroll for(int j=0; j<BLOCK_SIZE_K - 1; ++j){ // 第一次大迭代中 load_stage_idx 就为 0 // 因为在上部分代码中,我们已经进行了数据的预取 // 这里把下一次小迭代的需要数据放入 register 中 FETCH_FLOAT4(frag_a[(j+1)%2][0]) = FETCH_FLOAT4(As[load_stage_idx][(j+1)][a_tile_index]); FETCH_FLOAT4(frag_a[(j+1)%2][4]) = FETCH_FLOAT4(As[load_stage_idx][(j+1)][a_tile_index + 64]); FETCH_FLOAT4(frag_b[(j+1)%2][0]) = FETCH_FLOAT4(Bs[load_stage_idx][(j+1)][b_tile_index]); FETCH_FLOAT4(frag_b[(j+1)%2][4]) = FETCH_FLOAT4(Bs[load_stage_idx][(j+1)][b_tile_index + 64]); // 这里把第一次小迭代的数据拿出来进行计算 #pragma unroll for (int thread_y = 0; thread_y < THREAD_SIZE_Y; ++thread_y) { #pragma unroll for (int thread_x = 0; thread_x < THREAD_SIZE_X; ++thread_x) { accum[thread_y][thread_x] += frag_a[j%2][thread_y] * frag_b[j%2][thread_x]; } } } if(tile_idx < K){ // 将刚才的预取到 register 中的数据,存到 shared momery 中 // 供下一次小迭代反复使用 #pragma unroll for ( int i = 0 ; i < BLOCK_SIZE_M ; i += A_TILE_ROW_STRIDE) { int ldg_index = i / A_TILE_ROW_STRIDE * 4; As[write_stage_idx][A_TILE_COL][A_TILE_ROW_START + i]=ldg_a_reg[ldg_index]; As[write_stage_idx][A_TILE_COL+1][A_TILE_ROW_START + i]=ldg_a_reg[ldg_index+1]; As[write_stage_idx][A_TILE_COL+2][A_TILE_ROW_START + i]=ldg_a_reg[ldg_index+2]; As[write_stage_idx][A_TILE_COL+3][A_TILE_ROW_START + i]=ldg_a_reg[ldg_index+3]; } #pragma unroll for ( int i = 0 ; i < BLOCK_SIZE_K; i += B_TILE_ROW_STRIDE) { int ldg_index = i / B_TILE_ROW_STRIDE * 4; FETCH_FLOAT4(Bs[write_stage_idx][B_TILE_ROW_START + i][B_TILE_COL]) = FETCH_FLOAT4(ldg_b_reg[ldg_index]); } __syncthreads(); // 下一次的预取索引就应该是上一次的加载索引 // 同理上面使用的预取索引就是下一次的加载索引 预取就是为了未来的加载嘛 write_stage_idx ^= 1; } // 把第一次小迭代的数据预取至寄存器 FETCH_FLOAT4(frag_a[0][0]) = FETCH_FLOAT4(As[load_stage_idx^1][0][a_tile_index]); FETCH_FLOAT4(frag_a[0][4]) = FETCH_FLOAT4(As[load_stage_idx^1][0][a_tile_index + 64]); FETCH_FLOAT4(frag_b[0][0]) = FETCH_FLOAT4(Bs[load_stage_idx^1][0][b_tile_index]); FETCH_FLOAT4(frag_b[0][4]) = FETCH_FLOAT4(Bs[load_stage_idx^1][0][b_tile_index + 64]); // 计算最后一次小迭代 #pragma unroll for (int thread_y = 0; thread_y < THREAD_SIZE_Y; ++thread_y) { #pragma unroll for (int thread_x = 0; thread_x < THREAD_SIZE_X; ++thread_x) { accum[thread_y][thread_x] += frag_a[1][thread_y] * frag_b[1][thread_x]; } } }while(tile_idx< K);每次大迭代中最后一次小迭代放到搬完数据的最后来做,猜测这样在执行指令的时候就可以边取存下一次迭代的数据时,边执行计算。最后把每个线程寄存器上的结果搬回 C 中
    const int c_block_row = a_tile_index;
    const int c_block_col = b_tile_index;

    //store C00 block
    for(int i=0; i<4; i++){
      FETCH_FLOAT4(C[OFFSET(
        BLOCK_SIZE_M * by + c_block_row + i,
        BLOCK_SIZE_N * bx + c_block_col,
        N)]) = FETCH_FLOAT4(accum[i][0]);
    }
    //store C01 block
    for(int i=0; i<4; i++){
      FETCH_FLOAT4(C[OFFSET(
        BLOCK_SIZE_M * by + c_block_row + i,
        BLOCK_SIZE_N * bx + c_block_col + 64,
        N)]) = FETCH_FLOAT4(accum[i][4]);
    }
    //store C10 block
    for(int i=0; i<4; i++){
      FETCH_FLOAT4(C[OFFSET(
        BLOCK_SIZE_M * by + c_block_row + 64 + i,
        BLOCK_SIZE_N * bx + c_block_col,
        N)]) = FETCH_FLOAT4(accum[i+4][0]);
    }
    //store C11 block
    for(int i=0; i<4; i++){
      FETCH_FLOAT4(C[OFFSET(
        BLOCK_SIZE_M * by + c_block_row + 64 + i,
        BLOCK_SIZE_N * bx + c_block_col + 64,
        N)]) = FETCH_FLOAT4(accum[i+4][4]);
    }
Trick
- 首先分块:如何分给 block,block 内如何分给线程
- 然后搬运数据:大迭代的数据怎么搬运、小迭代的数据怎么搬运、利用 shared memory 和 register 提高搬运数据的效率;利用预取掩盖访问 latency
- 最后如何防止 bank conflict,对各个 wrap 应该访问的地址进行了设计
To Be Continued
-
♣ YoloV7 标签匹配及 loss 计算解析
📅 November 6, 2022 📂 AI
🎍本篇文章主要对 YoloV7 的后处理进行详细讲解,YoloV7 除了结构上,对前后处理都进行了改进,其余包括 scheduler、optimizer 等与 YoloV6 都是保持一致的。
🎍本篇文章主要对 YoloV7 的后处理进行详细讲解,YoloV7 除了结构上,对前后处理都进行了改进,其余包括 scheduler、optimizer 等与 YoloV6 都是保持一致的。而前处理中的多数 trick 也可以由其他,例如 X 中的数据增强方式替代。因此我们着重介绍后处理部分

如上如所示,YoloV7 同大多数单阶段目标检测算法属于密集检测 (dense detection)。上图是一个 7x7 的特征图红色的点是基于特征图的网格点,进行偏移后的点,然后在其上铺设 anchor box,每个点铺设一定数量的 anchor。当然也有直接在网格点上进行铺设的,一般来讲没有太大差别。下面我们开始介绍 v7 后处理,主要分为两部分:标签匹配和 loss 计算
Label Assignment
📄标签匹配主要分为两步:先是进行粗筛,然后是进行精筛
Find-3-Positive
📑顾名思义,第一步是找到三个正样本,就是对于每一个 GT 找到上图的三个 anchor 作为正样本。首先我们先大概讲一下匹配的规则

如上图所示,对于每一个网格,会被分为四个部分,绿色点是 GT 中心点,蓝色点是匹配给 GT 的正样本点。首先 GT 中心点所在的网格会被定义为正样本,然后根据中心点在网格的位置来找到另外两个正样本。比如在位置 1 是左上的点会被定义为其正样本,位置 2 是右上,位置 3 是左下,位置 4 是右下

📚下面是代码的注解和讲解:
# na -- num_anchor nt -- num_targets
# targets [nt, 6] [bs_id, cls, x, y, w, h]
na, nt = self.na, targets.shape[0]
# indices for assignment idx
# anch for assignment anchor
indices, anch = [], []
# 用于将 target 映射到特征图的网格上
gain = torch.ones(7, device=targets.device).long()
# [na, nt] eg. ai[0, :] = [0, ..., 0] ai[1, :] = [1, ..., 1]
ai = torch.arange(na, device=targets.device).float().view(na, 1).repeat(1, nt)
# [na, nt, 7]
targets = torch.cat((targets.repeat(na, 1, 1), ai[:, :, None]), 2)
# 预设 4 个方向上的偏移
g = 0.5
off = torch.tensor([[0, 0],
                    [1, 0], [0, 1], [-1, 0], [0, -1],
                   ], device=targets.device).float() * g
    # 对每个特征层进行匹配
	for i in range(self.nl):
        # 获取特征图 i 的 anchors [3, 2]
        anchors = self.anchors[i]
        # gain = [1, 1, w_i, h_i, w_i, h_i, 1]
        gain[2:6] = torch.tensor(p[i].shape)[[3, 2, 3, 2]]
        t = targets * gain
        if nt:
            # 获取每个 gt 与 anchor 的长之间的比与宽之间的比 [na, nt, 2]
            r = t[:, :, 4:6] / anchors[:, None]
            # 获得比值都小于阈值 anchor_t 的 mask [na, nt]
            j = torch.max(r, 1. / r).max(2)[0] < self.hyp['anchor_t']
            # 获得满足条件的 gt [n1, 7]
            t = t[j]
            # gt 在该特征图上的坐标
            gxy = t[:, 2:4]
            # 将坐标映射到网格的对称位置,网格的 1 和 4 对称,2 和 3 对称
            gxi = gain[[2, 3]] - gxy
            # 如果在网格位置 1:j、k 均为真值,即找到了左上两个正样本
            # 位置 2:j 为假,k 为真(上) 但此时位置 2 无法缺少一个正样本没有表示
            # [n1] [n1]
            j, k = ((gxy % 1. < g) & (gxy > 1.)).T
            # 由上行就可以看出无法表示 2 的全部正样本,对于位置 2 只能找到一个正样本
            # 3,4 位置正样本无法表示,因此要将 2,3,4 映射到对称位置上
            # 其中位置 1:j -> 1、k -> 1、l -> 0、m -> 0
            # 其中位置 2:j -> 0、k -> 1、l -> 1、m -> 0
            # 其中位置 3:j -> 1、k -> 0、l -> 0、m -> 1
            # 其中位置 4:j -> 0、k -> 0、l -> 1、m -> 1
            l, m = ((gxi % 1. < g) & (gxi > 1.)).T
            # [n1 ,5] 是否选取 gt 中心点所在网格上下左右四个网格为正样本
            # jklm 分别代表左、上、右、下
            j = torch.stack((torch.ones_like(j), j, k, l, m))
            # [5, n1, 7] -> [n2, 7]
            t = t.repeat((5, 1, 1))[j]
            # [5, n1, 2] -> [n2, 2] 获得偏移,以便后面得到三个正样本的坐标
            # 所以这里的 n2 = 3 * n1
            offsets = (torch.zeros_like(gxy)[None] + off[:, None])[j]
        else:
            t = targets[0]
            offsets = 0
        # 正样本的 bs_idx、cls、横纵坐标、宽高
        b, c = t[:, :2].long().T
        gxy = t[:, 2:4]
        gwh = t[:, 4:6]
        # 获得正样本 xy 坐标
        gij = (gxy - offsets).long()
        gi, gj = gij.T
        # 所有正样本匹配的 anchor idx
        a = t[:, 6].long()
        indices.append((b, a, gj.clamp_(0, gain[3] - 1), gi.clamp_(0, gain[2] - 1)))
        anch.append(anchors[a])

    return indices, anch
OTA
📑在获得初步的正样本后,然后进行第二次筛选,使用的是简易的 OTA,其计算过程是:先计算每个 gt 与所有 anchor 的 iou 并将前十的 iou 之和作为该 gt 匹配的正样本个数,然后计算每一个 gt 和 anchor 计算 cost 来确定最后的正样本,需要注意的是选正样本是基于第一步的基础之上
def build_targets(self, p, targets, imgs):
    indices, anch = self.find_3_positive(p, targets)

    # [[], [], []]
    matching_bs = [[] for pp in p]
    matching_as = [[] for pp in p]
    matching_gjs = [[] for pp in p]
    matching_gis = [[] for pp in p]
    matching_targets = [[] for pp in p]
    matching_anchs = [[] for pp in p]

    nl = len(p)

    for batch_idx in range(p[0].shape[0]):
		# 取出第 batch_idx 的 target
        b_idx = targets[:, 0]==batch_idx
        this_target = targets[b_idx]
        if this_target.shape[0] == 0:
            continue
            # 将 target 完全映射回原长度
        txywh = this_target[:, 2:6] * imgs[batch_idx].shape[1]
        txyxy = xywh2xyxy(txywh)

        pxyxys = []
        p_cls = []
        p_obj = []
        from_which_layer = []
        all_b = []
        all_a = []
        all_gj = []
        all_gi = []
        all_anch = []

        for i, pi in enumerate(p):
            # 取出第 i 个 level 的匹配的信息
            b, a, gj, gi = indices[i]
            # 取出该图在 level 匹配到的样本信息 mask
            idx = (b == batch_idx)
            b, a, gj, gi = b[idx], a[idx], gj[idx], gi[idx]
            all_b.append(b)
            all_a.append(a)
            all_gj.append(gj)
            all_gi.append(gi)
            all_anch.append(anch[i][idx])
            from_which_layer.append(torch.ones(size=(len(b),)) * i)
            # 获得所有正样本的预测 [n, 85]
            fg_pred = pi[b, a, gj, gi]
            p_obj.append(fg_pred[:, 4:5])
            p_cls.append(fg_pred[:, 5:])

            grid = torch.stack([gi, gj], dim=1)
            pxy = (fg_pred[:, :2].sigmoid() * 2. - 0.5 + grid) * self.stride[i]
            pwh = (fg_pred[:, 2:4].sigmoid() * 2) ** 2 * anch[i][idx] * self.stride[i]
            pxywh = torch.cat([pxy, pwh], dim=-1)
            pxyxy = xywh2xyxy(pxywh)
            pxyxys.append(pxyxy)
            # [n ,4]
        pxyxys = torch.cat(pxyxys, dim=0)
        if pxyxys.shape[0] == 0:
            continue
        p_obj = torch.cat(p_obj, dim=0)
        p_cls = torch.cat(p_cls, dim=0)
        from_which_layer = torch.cat(from_which_layer, dim=0)
        all_b = torch.cat(all_b, dim=0)
        all_a = torch.cat(all_a, dim=0)
        all_gj = torch.cat(all_gj, dim=0)
        all_gi = torch.cat(all_gi, dim=0)
        all_anch = torch.cat(all_anch, dim=0)
        # [n, n] 获取每一个 tgt 与预测框的 iou
        pair_wise_iou = box_iou(txyxy, pxyxys)
        pair_wise_iou_loss = -torch.log(pair_wise_iou + 1e-8)
        # [n, 10] 取与 tgt iou 排名前 10 的预测框
        top_k, _ = torch.topk(pair_wise_iou, min(10, pair_wise_iou.shape[1]), dim=1)
        # [n] 对于每个 tgt 的正样本个数取为上述前 10 个 iou 的和
        dynamic_ks = torch.clamp(top_k.sum(1).int(), min=1)
        # [n, n, 80]
        gt_cls_per_image = (
            F.one_hot(this_target[:, 1].to(torch.int64), self.nc)
            .float()
            .unsqueeze(1)
            .repeat(1, pxyxys.shape[0], 1)
        )

        num_gt = this_target.shape[0]
        # [n, n, 80]
        cls_preds_ = (
            p_cls.float().unsqueeze(0).repeat(num_gt, 1, 1).sigmoid_()
            * p_obj.unsqueeze(0).repeat(num_gt, 1, 1).sigmoid_()
        )

        y = cls_preds_.sqrt_()
        # [n, n] 计算 cls 的代价
        pair_wise_cls_loss = F.binary_cross_entropy_with_logits(
            torch.log(y/(1-y)) , gt_cls_per_image, reduction="none"
        ).sum(-1)
        del cls_preds_

        cost = (
            pair_wise_cls_loss
            + 3.0 * pair_wise_iou_loss
        )
        # [n, n]
        matching_matrix = torch.zeros_like(cost)

        for gt_idx in range(num_gt):
            # 对于每个 gt 选择 cost 前 dynamic_ks 个小的预测框作为正样本
            _, pos_idx = torch.topk(
                cost[gt_idx], k=dynamic_ks[gt_idx].item(), largest=False
            )
            matching_matrix[gt_idx][pos_idx] = 1.0

        del top_k, dynamic_ks
        # [n] 计算每个 anchor 匹配到了多少个 gt
        anchor_matching_gt = matching_matrix.sum(0)
        if (anchor_matching_gt > 1).sum() > 0:
            # [n, am] 获取匹配 gt 数大于 1 的 anchor 与 gt 最小的 cost 的 gt 的下标
            _, cost_argmin = torch.min(cost[:, anchor_matching_gt > 1], dim=0)
            # 先全部置为 0
            matching_matrix[:, anchor_matching_gt > 1] *= 0.0
            # 将与 anchor 中 cost 最小对应的 gt 设置为它的正样本
            # 这样做的原因是因为保证每一个 anchor 只匹配到一个 gt
            matching_matrix[cost_argmin, anchor_matching_gt > 1] = 1.0
        # [n] 获得 anchor 的 mask,其中 true 为正样本,反之为负样本
        fg_mask_inboxes = matching_matrix.sum(0) > 0.0
        # 获取每个 anchor 匹配到 gt 的下标
        matched_gt_inds = matching_matrix[:, fg_mask_inboxes].argmax(0)
        # 获取所有正样本的信息
        from_which_layer = from_which_layer[fg_mask_inboxes]
        all_b = all_b[fg_mask_inboxes]
        all_a = all_a[fg_mask_inboxes]
        all_gj = all_gj[fg_mask_inboxes]
        all_gi = all_gi[fg_mask_inboxes]
        all_anch = all_anch[fg_mask_inboxes]

        this_target = this_target[matched_gt_inds]
        # 进行分层储存,得到不同 level 的正样本
        for i in range(nl):
            layer_idx = from_which_layer == i
            matching_bs[i].append(all_b[layer_idx])
            matching_as[i].append(all_a[layer_idx])
            matching_gjs[i].append(all_gj[layer_idx])
            matching_gis[i].append(all_gi[layer_idx])
            matching_targets[i].append(this_target[layer_idx])
            matching_anchs[i].append(all_anch[layer_idx])

    for i in range(nl):
        if matching_targets[i] != []:
        	matching_bs[i] = torch.cat(matching_bs[i], dim=0)
        	matching_as[i] = torch.cat(matching_as[i], dim=0)
        	matching_gjs[i] = torch.cat(matching_gjs[i], dim=0)
        	matching_gis[i] = torch.cat(matching_gis[i], dim=0)
        	matching_targets[i] = torch.cat(matching_targets[i], dim=0)
        	matching_anchs[i] = torch.cat(matching_anchs[i], dim=0)
        else:
            matching_bs[i] = torch.tensor([], device='cuda:0', dtype=torch.int64)
            matching_as[i] = torch.tensor([], device='cuda:0', dtype=torch.int64)
            matching_gjs[i] = torch.tensor([], device='cuda:0', dtype=torch.int64)
            matching_gis[i] = torch.tensor([], device='cuda:0', dtype=torch.int64)
            matching_targets[i] = torch.tensor([], device='cuda:0', dtype=torch.int64)
            matching_anchs[i] = torch.tensor([], device='cuda:0', dtype=torch.int64)

    return matching_bs, matching_as, matching_gjs, matching_gis, matching_targets, matching_anch
Loss Computation
📑v7 的 loss 计算分为:分类损失、回归损失和目标损失
def __call__(self, p, targets, imgs):
    device = targets.device
    lcls, lbox, lobj = torch.zeros(1, device=device), torch.zeros(1, device=device), torch.zeros(1, device=device)
    bs, as_, gjs, gis, targets, anchors = self.build_targets(p, targets, imgs)
    # 每个 level 特征图的宽高
    pre_gen_gains = [torch.tensor(pp.shape, device=device)[[3, 2, 3, 2]] for pp in p]


    for i, pi in enumerate(p):
        # 取出第 level 的正样本信息
        b, a, gj, gi = bs[i], as_[i], gjs[i], gis[i]
        tobj = torch.zeros_like(pi[..., 0], device=device)

        n = b.shape[0]
        if n:
            # 获得正样本的预测结果
            ps = pi[b, a, gj, gi]

            # 正样本的坐标
            grid = torch.stack([gi, gj], dim=1)
            # 这里得到的是用 stride norm 过后的预测框
            pxy = ps[:, :2].sigmoid() * 2. - 0.5
            pwh = (ps[:, 2:4].sigmoid() * 2) ** 2 * anchors[i]
            pbox = torch.cat((pxy, pwh), 1)

            selected_tbox = targets[i][:, 2:6] * pre_gen_gains[i]
            # 预测的是离格点距离,因此 gt 需要减去相应格点的坐标
            selected_tbox[:, :2] -= grid
            iou = bbox_iou(pbox.T, selected_tbox, x1y1x2y2=False, CIoU=True)
            lbox += (1.0 - iou).mean()

            # 将 obj label 中正样本位置设置为与 gt 的 iou,其余为 0
            tobj[b, a, gj, gi] = (1.0 - self.gr) + self.gr * iou.detach().clamp(0).type(tobj.dtype)

            selected_tcls = targets[i][:, 1].long()
            if self.nc > 1:
                # cls loss 只计算了正样本的 loss
                t = torch.full_like(ps[:, 5:], self.cn, device=device)
                t[range(n), selected_tcls] = self.cp
                lcls += self.BCEcls(ps[:, 5:], t)

            # obj 计算为全部样本的 loss
            obji = self.BCEobj(pi[..., 4], tobj)
            lobj += obji * self.balance[i]  # obj loss
            if self.autobalance:
                self.balance[i] = self.balance[i] * 0.9999 + 0.0001 / obji.detach().item()

    if self.autobalance:
        self.balance = [x / self.balance[self.ssi] for x in self.balance]
    lbox *= self.hyp['box']
    lobj *= self.hyp['obj']
    lcls *= self.hyp['cls']
    bs = tobj.shape[0]  # batch size

    loss = lbox + lobj + lcls
    return loss * bs, torch.cat((lbox, lobj, lcls, loss)).detach()
☕Yolov7 其他部分如 scheduler 和 optimizer 与 Yolov6 保持一致,另外值得一提的是 v7 的隐性层可以提点 0.5 左右,但是也许仅限 v7 同时对隐性层的 lr 等需要特殊设置
-
♣ 变限积分求导的种种
📅 June 5, 2022 📂 MATH
变上限积分求导的理解
假设 \(F(x)\) 是 \(f(x)\) 的一个原函数,即 \(F^{\prime}(x) = f(x)\)。那么对 \(f(x)\) 积分,有:
\[\int f(x) dx = \int F^{\prime}(x) dx= F(x) +C\]其中 \(C\) 是常数,可以将其表示为 \(-F(a)\)。如果 \(f(x)\) 在 \([a, x]\) 上连续,我们对其进行积分:
\[\int_{a}^{x} f(t) dt = \int_{a}^{x} F^{\prime}(t) dt= F(x) - F(a) = F(x) + C\]变上限积分求导的理解
假设 \(F(x)\) 是 \(f(x)\) 的一个原函数,即 \(F^{\prime}(x) = f(x)\)。那么对 \(f(x)\) 积分,有:
\[\int f(x) dx = \int F^{\prime}(x) dx= F(x) +C\]其中 \(C\) 是常数,可以将其表示为 \(-F(a)\)。如果 \(f(x)\) 在 \([a, x]\) 上连续,我们对其进行积分:
\[\int_{a}^{x} f(t) dt = \int_{a}^{x} F^{\prime}(t) dt= F(x) - F(a) = F(x) + C\]因此,其中我们称 \(\int_{a}^{x}f(t)dt\) 为 \(f(x)\) 的变上限积的定积分,也算是 \(f(x)\) 的一个原函数。同时我们也可以得到牛顿-莱布尼茨 (Newton-Leibniz) 公式:
\[\int_{a}^{x=b} f(t)dt = F(b) - F(a)\]以上严谨的推导需要通过积分中值配合导数的定义来进行求证,这里暂时省略一段。对于变上限积分求导有:
\[\frac{d\int_{a}^{x} f(t) dt}{dx} = \frac{d(F(x) - F(a))}{dx} = F^{\prime}(x) = f(x)\]对于更一般的情况,当上下限是关于 \(x\) 的可导函数时:
\[\begin{aligned}\frac{d\int_{\phi(x)}^{\psi(x)} f(t)dt}{dx} &= \frac{dF(\psi(x)) - F(\phi(x))}{dx} \\ &= F^{\prime}(\psi(x))\psi^{\prime}(x) - F^{\prime}(\phi(x))\phi^{\prime}(x) \\ &=f(\psi(x))\psi^{\prime}(x) - f(\phi(x))\phi^{\prime}(x)\end{aligned}\]因此对变上下限积分求导有下式:
\[\frac{d\int_{\phi(x)}^{\psi(x)} f(t)dt}{dx} =f(\psi(x))\psi^{\prime}(x) - f(\phi(x))\phi^{\prime}(x)\]应用示例展示
介绍完理论知识,这里进行举例进行应用。其中涉及到变上限积分时,换元操作易出现错误以及被积函数包含积分上限变量的情况。
♣ 换元易错示例:
- 问题:
- 常规解法:
- 学妹的错误解法:
-
学妹的问题在于没有进行上限的变换以及积分变量的换元替换,因此容易出现失误(不熟悉时不建议这么做),咱们按步骤来:
-
先进行积分变量的替换,令 \(a = t^2\),有 \(da =d(t^2) \rightarrow da = 2tdt \rightarrow \frac{da}{2t} = dt\)
-
然后进行积分上下限的计算,当 \(t=0\) 时,\(a=0\);当 \(t=x^2\) 时,\(a=x^4\)。带入有:
-
♠ 被积函数包含积分上限变量示例:
本示例借用一个学长探究 Newton-Leibniz 公式与 Navier-Stokes 方程关系时,示范容易出现变上限积分求导时犯的错误,学长本身的推导没有错,只是觉得可以用来提醒其他同学:
-
问题:
求变上限积分 \(\int_{a(t)}^{b(t)} f(x, t)dx\) 的导数
将 N-S 方程 \(\frac{\partial \rho}{\partial t}+ \frac{\partial (\rho \mu)}{\partial t} = 0\) 与上式进行联系
-
解答:
我们将上述式子具象化,使用一维流动假设进行联系,假设下述是一根无限长的水管,在 \(t\) 时刻有一滴水(橙色部分),其密度与时间和空间的函数为: \(\rho(x, t)\) ,如下图所示,水滴的边界为 \(a(t)\) 和 \(b(t)\) 。经过时间 \(\Delta t\) ,水滴位置变为 \(a(t+\Delta t)\) 和 \(b(t+\Delta t)\) ,密度变为 \(\rho(x, t+\Delta t)\)(蓝色部分)。

在这迅速变化的世界,我们应该找寻不变的真理。这里的真理就是质量守恒定律,水滴不可能跑着跑着质量还减少了吧,搁这儿减肥呢?因此水滴的质量可以由\(m(t)=\int_{a(t)}^{b(t)}\rho(x,t)dx\) 求得,由质量守恒定律,即质量对时间的导数为 0,有:
这里是不是很眼熟了,不就是变上限积分求导吗?桥豆麻袋,被积函数含有上限变量 \(t\) ,还能使用其之前的方法直接求导吗?我们举个例子试试:
题目:
\[\frac{d}{dx}\int_{0}^{x^2} xt^{2}dt\]解法一:直接对变上限积分直接求导
\[\frac{d}{dx}\int_{0}^{x^2} xt^{2}dt=2x\cdot x \cdot x^4 = 2x^6\]解法二:先积分后求导,因为 \(x\) 不是积分变量,因此我们可以直接将其提到积分号的外面
\[\begin{aligned} \frac{d}{dx}\int_{0}^{x^2} xt^{2}dt&=\frac{d}{dx}x\int_{0}^{x^2} t^{2}dt \\ &=\frac{d}{dx}x\cdot \frac{1}{3}t^3 \Bigg|^{x^2}_{0} = \frac{7x^6}{3} \end{aligned}\]解法三:将 \(x\) 放到积分号外面,对里面的使用变上限积分求导
\[\begin{aligned} \frac{d}{dx}\int_{0}^{x^2} xt^{2}dt&=\frac{d}{dx}x \cdot\int_{0}^{x^2} t^{2}dt \\ &=\int_{0}^{x^2} t^{2}dt + x \cdot 2x \cdot (x^2)^2 = \frac{7x^6}{3} \end{aligned}\]显然解法二和解法三是正确的。圆规正转,由上可知我们不能直接对 \(\rho(x,t)\) 使用变上限积分求导。可是我们无法直接先积分后求导,也无法将 \(t\) 分出来。所以只能采取最原始的办法,即使用导数定义的方式来求解了:
\[\frac{dm}{dt} = \lim_{\Delta t\rightarrow 0}\frac{1}{\Delta t}\Bigg(\int_{a(t+\Delta t)}^{b(t+\Delta t)}\rho(x,t+\Delta t)dx-\int_{a(t)}^{b(t)}\rho(x,t)dx\Bigg)\]我们可以看到上述分母既有积分上下限的变化,也有被积函数的变化。前者是空间的变化,后者是时间的变化。因此我们得把时空分离开来:
\[\begin{aligned} \frac{dm}{dt} = \lim_{\Delta t\rightarrow 0}\frac{1}{\Delta t}\Bigg(\int_{b(t)}^{b(t+\Delta t)}\rho(x,t+\Delta t)dx&+\int_{a(t+\Delta t)}^{a(t)}\rho(x,t+\Delta t)dx \\ + \int_{a(t)}^{b(t)}\rho(x,t+\Delta t)dx &-\int_{a(t)}^{b(t)}\rho(x,t)dx\Bigg) \end{aligned}\]上式前面两项是左右边界的变化(空间的变化),因为被积函数保持一致。后面两项则是密度场随时间的变化。前两项分别是积分上限和下限变化,因此使用变限积分求导:
\[\begin{aligned} \lim_{\Delta t\rightarrow 0}\frac{1}{\Delta t}\int_{b(t)}^{b(t+\Delta t)}\rho(x,t+\Delta t)dx &= \rho(b(t),t)\frac{db(t)}{dt}=\rho(b(t),t)\mu(b(t),t) \\ \lim_{\Delta t\rightarrow 0}\frac{1}{\Delta t}\int_{a(t+\Delta t)}^{a(t)}\rho(x,t+\Delta t)dx &= \rho(a(t),t)\Big(-\frac{da(t)}{dt}\Big)=\rho(b(t),t)\mu(a(t),t) \end{aligned}\]其中 \(\mu(x,t)\) 为速度场。使用牛顿-莱布尼兹公式将其合并:
\[\rho(b(t),t)\frac{db(t)}{dt}-\rho(a(t),t)\frac{da(t)}{dt} =\int_{a(t)}^{b(t)}\frac{\partial (\rho(x,t)\mu(x,t))}{\partial x}dx\]后两项积分上下限一致,可见是对密度函数的求导,易得:
\[\lim_{\Delta t\rightarrow 0}\frac{1}{\Delta t}\Bigg(\int_{a(t)}^{b(t)}\rho(x,t+\Delta t)-\rho(x,t)dx\Bigg)=\int_{a(t)}^{b(t)}\frac{\partial \rho(x,t)}{\partial t}dx\]将上述两个结果整理得到最后求导结果:
\[\frac{dm}{dt} = \int_{a(t)}^{b(t)}\Bigg(\frac{\partial (\rho(x,t)\mu(x,t))}{\partial x}+\frac{\partial \rho(x,t)}{\partial t} \Bigg)dx = 0\]对于任意成立的 \(a(t)\) 和 \(b(t)\) 位置,有:
\[\frac{\partial \rho(x,t)}{\partial t}+\frac{\partial (\rho(x,t)\mu(x,t))}{\partial x} = 0\]这便是一维的流动连续性方程,对于动量、动量矩、能量积分,便可得到完整的 NS 方程。
🌸🌸🌸 这段故事完结 🌈🌈🌈
-
♣ Tufte-style Jekyll blog
📅 April 13, 2020 📂 JEKYLL
The Tufte Jekyll theme is an attempt to create a website design with the look and feel of Edward Tufte’s books and handouts. Tufte’s style is known for its extensive use of sidenotes, tight integration of graphics with text, and well-set typography.
The Tufte Jekyll theme is an attempt to create a website design with the look and feel of Edward Tufte’s books and handouts. Tufte’s style is known for its extensive use of sidenotes, tight integration of graphics with text, and well-set typography. The idea for this project is essentially cribbed wholesale from Tufte and R Markdown’s Tufte Handout formatSee tufte-latex.github.io/tufte-latex/ and rmarkdown.rstudio.com/tufte_handout_format This page is an adaptation of the Tufte Handout PDF.
Jekyll customizations
This Jekyll blog theme is based on the github repository by Edward Tufte here, which was orginally created by Dave Leipmann, but is now labeled under Edward Tufte’s moniker. I borrowed freely from the Tufte-CSS repo and have transformed many of the typographic and page-structural features into a set of custom Liquid tags that make creating content using this style much easier than writing straight HTML. Essentially, if you know markdown, and mix in a few custom Liquid tags, you can be creating a website with this document style in short order.
The remainder of this sample post is a self-documenting survey of the features of the Tufte-Jekyll theme. I have taken almost all of the sample content from the Tufte-css repo and embedded it here to illustrate the parity in appearence between the two. The additional verbiage and commentary I have added is to document the custom Liquid markup tags and other features that are bundled with this theme.
The SASS settings file
I have taken much of the actual Tufte-css files and modified them as necessary to accomodate the needs inherent in creating a Jekyll theme that has additional writing aids such as the Liquid tags. I have also turned the CSS file into a SASS file (the .scss type). This means that you can alter things like font choices, text color, background color, and underlining style by changing values in this file. When the Jekyll site is built using
jekyll buildthe settings in this file will be compiled into the customized CSS file that the site uses. If you don’t use SCSS or SASS, you are missing out on a huge productivity tool.This file looks like this:
/* This file contains all the constants for colors and font styles */

$body-font:   ETBembo, Palatino, "Palatino Linotype", "Palatino LT STD", "Book Antiqua", Georgia, serif;
// Note that Gill Sans is the top of the stack and corresponds to what is used in Tufte's books
// However, it is not a free font, so if it is not present on the computer that is viewing the webpage
// The free Google 'Lato' font is used instead. It is similar.
$sans-font:  "Gill Sans", "Gill Sans MT", "Lato", Calibri, sans-serif;
$code-font: Consolas, "Liberation Mono", Menlo, Courier, monospace;
$url-font: "Lucida Console", "Lucida Sans Typewriter", Monaco, "Bitstream Vera Sans Mono", monospace;
$text-color: #111;
$bg-color: #fffff8;
$contrast-color: #a00000;
$border-color: #333333;
$link-style: color; // choices are 'color' or 'underline'. Default is color using $contrast-color set above
Any of these values can be changed in the
_sass/_settings.scssfile before the site is built. The default values are the ones from tufte-css.Fundamentals
Color
Although paper handouts obviously have a pure white background, the web is better served by the use of slightly off-white and off-black colors. I picked
#fffff8and#111111because they are nearly indistinguishable from their ‘pure’ cousins, but dial down the harsh contrast. Tufte’s books are a study in spare, minimalist design. In his book The Visual Display of Quantitative Information, he uses a red ink to add some visual punctuation to the buff colored paper and dark ink. In that spirit, links are styled using a similar red color.Headings
Tufte CSS uses
<h1>for the document title,<p>with classcodefor the document subtitle,<h2>for section headings, and<h3>for low-level headings. More specific headings are not encouraged. If you feel the urge to reach for a heading of level 4 or greater, consider redesigning your document:[It is] notable that the Feynman lectures (3 volumes) write about all of physics in 1800 pages, using only 2 levels of hierarchical headings: chapters and A-level heads in the text. It also uses the methodology of sentences which then cumulate sequentially into paragraphs, rather than the grunts of bullet points. Undergraduate Caltech physics is very complicated material, but it didn’t require an elaborate hierarchy to organize.
http://www.edwardtufte.com/bboard/q-and-a-fetch-msg?msg_id=0000hB
As a bonus, this excerpt regarding the use of headings provides an example of using block quotes. Markdown does not have a native
<cite>shorthand, but real html can be sprinkled in with the Markdown text. In the previous example, the<cite>was preceded with a single return after the quotation itself. The previous blockquote was written in Markdown thusly:[It is] notable that the Feynman lectures (3 volumes) write about all of physics in 1800 pages, using only 2 levels of hierarchical headings: chapters and A-level heads in the text. It also uses the methodology of *sentences* which then cumulate sequentially into *paragraphs*, rather than the grunts of bullet points. Undergraduate Caltech physics is very complicated material, but it didn’t require an elaborate hierarchy to organize. <cite>[http://www.edwardtufte.com/bboard/q-and-a-fetch-msg?msg_id=0000hB](http://www.edwardtufte.com/bboard/q-and-a-fetch-msg?msg_id=0000hB)</cite>In his later books http://www.edwardtufte.com/tufte/books_be , Tufte starts each section with a bit of vertical space, a non-indented paragraph, and sets the first few words of the sentence in small caps. To accomplish this using this style, enclose the sentence fragment you want styled with small caps in a custom Liquid tag called ‘newthought’ like so:
{% newthought 'In his later books' %}Text
In print, Tufte uses the proprietary Monotype BemboSee Tufte’s comment in the Tufte book fonts thread. font. A similar effect is achieved in digital formats with the now open-source ETBembo, which Tufte-Jekyll supplies with a
@font-facereference to a .ttf file. Thanks to Linjie Ding, italicized text uses the ETBembo Italic font instead of mechanically skewing the characters. In case ETBembo somehow doesn’t work, Tufte CSS degrades gracefully to other serif fonts like Palatino and Georgia. Notice that Tufte CSS includes separate font files for bold (strong) and italic (emphasis), instead of relying on the browser to mechanically transform the text. This is typographic best practice. It’s also really important. Thus concludes my unnecessary use of em and strong for the purpose of example.Code snippets ape GitHub’s font selection using Microsoft’s Consolas and the sans-serif font uses Tufte’s choice of Gill Sans. Since this is not a free font, and some systems will not have it installed, the free google font Lato is designated as a fallback.
Epigraphs
The English language . . . becomes ugly and inaccurate because our thoughts are foolish, but the slovenliness of our language makes it easier for us to have foolish thoughts.
For a successful technology, reality must take precedence over public relations, for Nature cannot be fooled.
If you’d like to introduce your page or a section of your page with some quotes, use epigraphs. The two examples above show how they are styled. Epigraph elements are modeled after chapter epigraphs in Tufte’s books (particularly Beautiful Evidence). The Tufte-css gitub repository has detailed instructions on how to achieve this using HTML elements. As an easier alternative, the Tufte-jekyll theme uses custom Liquid tag pairs that allow the writer to embed elements such as epigraphs in the middle of the regular Markdown text being edited.
In order to use an epigraph in a page or section, type this:
{% epigraph 'text of citation' 'author of citation' 'citation source' %}to produce this:
I do not paint things, I paint only the differences between things.
"How did you go bankrupt?" Two ways. Gradually, then suddenly.
Lists
Tufte points out that while lists have valid uses, they tend to promote ineffective writing habits due to their “lack of syntactic and intellectual discipline”. He is particularly critical of hierarchical and bullet-pointed lists. So before reaching for an HTML list element, ask yourself:
- Does this list actually have to be represented using an HTML ul or ol element?
- Would my idea be better expressed as sentences in paragraphs?
- Is my message causally complex enough to warrant a flow diagram instead?
This is but a small subset of a proper overview of the topic of lists in communication. A better way to understand Tufte’s thoughts on lists would be to read “The Cognitive Style of PowerPoint: Pitching Out Corrupts Within,” a chapter in Tufte’s book Beautiful Evidence, excerpted at some length by Tufte himself on his website. The whole piece is information-dense and therefore difficult to summarize. He speaks to web design specifically, but in terms of examples and principles rather than as a set of simple do-this, don’t-do-that prescriptions. It is well worth reading in full for that reason alone.
For these reasons, Tufte CSS encourages caution before reaching for a list element, and by default removes the bullet points from unordered lists.
Figures
Margin Figures

F.J. Cole, “The History of Albrecht Dürer’s Rhinoceros in Zoological Literature,” Science, Medicine, and History: Essays on the Evolution of Scientific Thought and Medical Practice (London, 1953), ed. E. Ashworth Underwood, 337-356. From page 71 of Edward Tufte’s Visual Explanations.Images and graphics play an integral role in Tufte’s work. To place figures in the margin, use the custom margin figure liquid tag included in the
_pluginsdirectory like so:{% marginfigure 'mf-id-whatever' 'assets/img/rhino.png' 'F.J. Cole, “The History of Albrecht Dürer’s Rhinoceros in Zoological Literature,” *Science, Medicine, and History: Essays on the Evolution of Scientific Thought and Medical Practice* (London, 1953), ed. E. Ashworth Underwood, 337-356. From page 71 of Edward Tufte’s *Visual Explanations*.' %}.Note that this tag has three parameters. The first is an arbitrary id. This parameter can be named anything as long as it is unique to this post. The second parameter is the path to the image. And the final parameter is whatever caption you want to be displayed with the figure. All parameters must be enclosed in quotes for this simple liquid tag to work!
In this example, the Liquid marginfigure tag was inserted before the paragraph so that it aligns with the beginning of the paragraph. On small screens, the image will collapse into a small symbol: ⊕ at the location it has been inserted in the manuscript. Clicking on it will open the image.
Full Width Figures
If you need a full-width image or figure, another custom liquid tag is available to use. Oddly enough, it is named ‘fullwidth’, and this markup:
{% fullwidth 'assets/img/napoleons-march.png' 'Napoleon's March *(Edward Tufte’s English translation)*' %}Yields this:

Napoleon’s March (Edward Tufte’s English translation) Main Column Figures
Besides margin and full width figures, you can of course also include figures constrained to the main column. Yes, you guessed it, a custom liquid tag rides to the rescue once again:
{% maincolumn 'assets/img/export-imports.png' 'From Edward Tufte, *Visual Display of Quantitative Information*, page 92' %}yields this:

From Edward Tufte, Visual Display of Quantitative Information, page 92 Sidenotes and Margin notes
One of the most prominent and distinctive features of Tufte’s style is the extensive use of sidenotes and margin notes. Perhaps you have noticed their use in this document already. You are very astute.
There is a wide margin to provide ample room for sidenotes and small figures. There exists a slight semantic distinction between sidenotes and marginnotes.
Sidenotes
SidenotesThis is a sidenote and displays a superscript display a superscript. The sidenote Liquid tag contains two components. The first is an identifier allowing the sidenote to be targeted by the twitchy index fingers of mobile device users so that all the yummy sidenote goodness is revealed when the superscript is tapped. The second components is the actual content of the sidenote. Both of these components should be enclosed in single quotes. Note that we are using the CSS ‘counter’ trick to automagically keep track of the number sequence on each page or post. On small screens, the sidenotes disappear and when the superscript is clicked, a side note will open below the content, which can then be closed with a similar click. Here is the markup for the sidenote at the beginning of this paragraph:
{% sidenote 'sn-id-whatever' 'This is a sidenote and *displays a superscript*'%}Margin notes
Margin notesThis is a margin note without a superscript are similar to sidenotes, but do not display a superscript. The marginnnote Liquid tags has the same two components as the sidenote tag. Anything can be placed in a margin note. Well, anything that is an inline element. Block level elements can make the Kramdown parser do strange things. On small screens, the margin notes disappear and this symbol: ⊕ pops up. When clicked, it will open the margin note below the content, which can then be closed with a similar click. The Markdown content has a similar sort of markup as a sidenote, but without a number involved:
{% marginnote 'mn-id-whatever' 'This is a margin note *without* a superscript' %}Equations
The Markdown parser being used by this Jekyll theme is Kramdown, which contains some built-in Mathjax support. Both inline and block-level mathematical figures can be added to the content.
For instance, the following inline sequence:
When \(a \ne 0\), there are two solutions to \(ax^2 + bx + c = 0\)
is written by enclosing a Mathjax expression within a matching pair of double dollar signs:
$$:When $$ a \ne 0 $$, there are two solutions to $$ ax^2 + bx + c = 0 $$Similarly, this block-level Mathjax expression:
\[x = {-b \pm \sqrt{b^2-4ac} \over 2a}\]is written by enclosing the expression within a pair of
$$with an empty line above and below:$$ x = {-b \pm \sqrt{b^2-4ac} \over 2a} $$You can get pretty fancy, for instance, the wave equation’s nabla is no big thing:
\[\frac{\partial^2 y}{\partial t^2}= c^2\nabla^2u\]All of the standard LaTeX equation markup is available to use inside these block tags.
Please note that the block-level Mathjax expressions must be on their own line, separated from content above and below the block by a blank line for the Kramdown parser and the Mathjax javascript to play nicely with one another.
The Mathjax integration is tricky, and some things such as the inline matrix notation simply do not work well unless allowances are made for using the notation for a small matrix. Bottom line: If you are using this to document mathematics, be super careful to isolate your LaTeX blocks by blank lines!
Tables
Tables are, frankly, a pain in the ass to create. That said, they often are one of the best methods for presenting data. Tabular data are normally presented with right-aligned numbers, left-aligned text, and minimal grid lines.
Note that when writing Jekyll Markdown content, there will often be a need to get some dirt under your fingernails and stoop to writing a little honest-to-god html. Yes, all that hideous
<table>..<thead>..<th>nonsense. And you must wrap the unholy mess in a<div class="table-wrapper">tag to ensure that the table stays centered in the main content column.Tables are designed with an
overflow:scrollproperty to create slider bars when the viewport is narrow. This is so that you do not collapse all your beautiful data into a jumble of letters and numbers when you view it on your smartphone.Table 1: A table with default style formatting
Content and tone of front-page articles in 94 U.S. newspapers, October and November, 1974 Number of articles Percent of articles with negative criticism of specific person or policy Watergate: defendants and prosecutors, Ford’s pardon of Nixon 53749%Inflation, high cost of living 41528%Government competence: costs, quality, salaries of public employees 32230%Confidence in government: power of special interests, trust in political leaders, dishonesty in politics 26652%Government power: regulation of business, secrecy, control of CIA and FBI 15442%Crime 12330%Race 10325%Unemployment 10013%Shortages: energy, food 6816%This is not the One True Table. Such a style does not exist. One must craft each data table with custom care to the narrative one is telling with that specific data. So take this not as “the table style to use”, but rather as “a table style to start from”. From here, use principles to guide you: avoid chartjunk, optimize the data-ink ratio (“within reason”, as Tufte says), and “mobilize every graphical element, perhaps several times over, to show the data.Page 139, The Visual Display of Quantitative Information, Edward Tufte 2001. Furthermore, one must know when to reach for more complex data presentation tools, like a custom graphic or a JavaScript charting library.
As an example of alternative table styles, academic publications written in LaTeX often rely on the
booktabspackage to produce clean, clear tables. Similar results can be achieved in Tufte CSS with thebooktabsclass, as demonstrated in this table:Table 2: A table with booktabs style formatting
Items Animal Description Price ($) Gnat per gram 13.65 each 0.01 Gnu stuffed 92.50 Emu stuffed 33.33 Armadillo frozen 8.99 The table above was written in HTML as follows:
<div class="table-wrapper">
<table class="booktabs">
          <thead>
            <tr><th colspan="2" class="cmid">Items</th><th class="nocmid"></th></tr>
            <tr><th class="l">Animal</th><th>Description</th class="r"><th>Price ($)</th></tr>
          </thead>
          <tbody>
            <tr><td>Gnat</td>     <td>per gram</td><td class="r">13.65</td></tr>
            <tr><td></td>         <td>each</td>    <td class="r">0.01</td></tr>
            <tr><td>Gnu</td>      <td>stuffed</td> <td class="r">92.50</td></tr>
            <tr><td>Emu</td>      <td>stuffed</td> <td class="r">33.33</td></tr>
            <tr><td>Armadillo</td><td>frozen</td>  <td class="r">8.99</td></tr>
          </tbody>
</table>
</div>
I like this style of table, so I have made it the default for unstyled tables. This allows use of the Markdown Extra features built into the Kramdown parser. Here is a table created using the Markdown Extra table syntax to make a nice table which has the side benefit of being human readable in the raw Markdown file:
Table 3: a table created with Markdown Extra markup using only the default table styling
mpg cyl disp hp drat wt Mazda RX4 21 6 160 110 3.90 2.62 Mazda RX4 Wag 21 6 160 110 3.90 2.88 Datsun 710 22.8 4 108 93 3.85 2.32 Hornet 4 Drive 21.4 6 258 110 3.08 3.21 Hornet Sportabout 18.7 8 360 175 3.15 3.44 Valiant 18.1 6 160 105 2.76 3.46 Using the following Markdown formatting:
|                 |mpg  | cyl  |  disp  |   hp   |  drat  | wt  |
|:----------------|----:|-----:|-------:|-------:|-------:|----:|
|Mazda RX4        |21   |6     |160     |110     |3.90    |2.62 |
|Mazda RX4 Wag    |21   |6     |160     |110     |3.90    |2.88 |
|Datsun 710       |22.8 |4     |108     |93      |3.85    |2.32 |
etc...
The following is a more simple table, showing the Markdown-style table markup. Remember to label the table with a marginnote Liquid tag, and you must separate the label from the table with a single blank line. This markup:
{% marginnote 'Table-ID4' 'Table 4: a simple table showing left, center, and right alignment of table headings and data'  %}

|**Left** |**Center**|**Right**|
|:--------|:--------:|--------:|
 Aardvarks|         1|$3.50
       Cat|   5      |$4.23
  Dogs    |3         |$5.29
Yields this table:
Table 4: a simple table showing left, center, and right alignment of table headings and data
Left Center Right Aardvarks 1 $3.50 Cat 5 $4.23 Dogs 3 $5.29 Code
Code samples use a monospace font using the ‘code’ class. The Kramdown parser has the ‘GFM’ option enabled, which stands for ‘Github Flavored Markdown’, and this means that both inline code such as
#include <stdio.h>and blocks of code can be delimited by surrounding them with 3 backticks:(map tufte-style all-the-things)is created by the following markup:
```(map tufte-style all-the-things)```To get the code highlighted in the language of your choice like so:
module Jekyll
  class RenderFullWidthTag < Liquid::Tag
  require "shellwords"

    def initialize(tag_name, text, tokens)
      super
      @text = text.shellsplit
    end

    def render(context)
      "<div><img class='fullwidth' src='#{@text[0]}'/></div> " +
      "<p><span class='marginnote'>#{@text[1]}</span></p>"
    end
  end
end

Liquid::Template.register_tag('fullwidth', Jekyll::RenderFullWidthTag)
Enclose the code block in three backticks, followed by a space and then the language name, like this:
 ``` ruby
    module Jekyll
    blah, blah...
   ```