Policy Optimization MPO DAPO GSPO
这篇 Blog 主要对 MPO、DAPO、GSPO 进行介绍,这几种强化学习的方法或基于 DPO 或基于 GRPO 改进。因此默认已经有相关知识,这里就不再赘述了
MPO
首先先对 MPO 进行介绍。这里插播一个小插曲,由于我是直接搜索 MPO,因此刚开始我阅读错了 Paper → Mixing Preference Optimization。既然来都来了,那就还是介绍一下,不感兴趣可以跳过
An Efficient Post-Processing Framework for Mixing Diverse Preference Alignment
这篇论文主要想解决的是 MaxMin-RLHF 和 MORLHF 中遇到的问题。因此需要先介绍 MaxMin-RLHFMORLHF 与其思路大致一样 ,文中有大量的公式推导细节感兴趣的同学可以阅读原文 ,本文只做结论上的介绍
MaxMin-RLHF 指出来的问题是在 RLHF 中使用单一的 reward 无法满足人类偏好的多样性。文中特别提到了对于少数派或者某一群体比如学生和上班族的差异 的喜好时,单一的 reward 进行评估非常困难。因此论文训练了多个 reward,并根据 Egalitarian rule in social choice theory 选择对该回答评分不高的 reward 评分作为最后进行最大优化的评分关注少数派发言,使得模型不至于走不到那些极少关注的地方 。MaxMin 也在这里进行了体现
而这个 MPO 所做的事是在多个 reward 中的回答进行评价分数的 Normalization 的工作,主要是为了训练稳定。对 MaxMin 和 MORLHF 都提供了相应的解决方案
关于这个 MPO 就介绍到了这里,下面进入正题,Mixed Preference Optimization 这是 InternVL 系列用的强化学习方法,首先他的优化总目标如下:
\[\mathcal{L} = w_p \mathcal{L}_p + w_q \mathcal{L}_q + w_g \mathcal{L}_g\]文中主要把 Loss 分为三部分组成: Preference Loss, Quality Loss and Generation Loss
其中 Preference Loss 就是 DPO
\[\mathcal{L}_p = - \log \sigma \left( \beta \log \frac{\pi_\theta(y_c \mid x)}{\pi_0(y_c \mid x)} - \beta \log \frac{\pi_\theta(y_r \mid x)}{\pi_0(y_r \mid x)} \right)\]Quality Loss 是 BCO
\[\mathcal{L}_q = -\log \sigma \left( \beta \log \frac{\pi_\theta(y_c \mid x)}{\pi_0(y_c \mid x)} - \delta \right) - \log \sigma \left( - \left( \beta \log \frac{\pi_\theta(y_r \mid x)}{\pi_0(y_r \mid x)} - \delta \right) \right)\]Generation Loss
\[\mathcal{L}_g = - \frac{\log \pi_\theta(y_c \mid x)}{|y_c|}\]Binary Classifier Optimization for Large Language Model Alignment
DPO 就不过多介绍了,我们从 BCO 开始介绍。BCO 全称 Binary Classifier Optimization,不同于 KTO 单从 binary signals 出发,而是理论证明了 binary signal 和 preference optimization (DPO) 之间的联系从而优化。通过一个 a binary classifier 将 prompt+chosen_completion map 到 1 和 prompt+rejected_completion map 到 0,从而使用 binary cross-entropy loss 进行优化对于常见的 AI 应用有点赞和点踩功能,会更方便收集数据,并且可以防止 DPO 训练到一定程度后 choose 和 reject 同时下降的情况,本质上只需要 w > l 就行,可以参考讨论 并且证明了此种方法的 BCE Loss 是 DPO 的上界
其中 \(r_\theta(x, y) = \beta \log \frac{\pi_\theta(y \mid x)}{\pi_{\text{ref}}(y \mid x)}\),随着训练进行 BCE 会成为 DPO 严格的上界。由于上式应用了不等式 \(\log \sigma (x) + \log \sigma (y) \lt \log \sigma (x + y)\),所以比起 DPO 会出来误差项 \(e^{-x} + e^{-y}\)。为了更接近 DPO,文中使用了 reward shift \(\delta\) 进行缓解会使 \(e^{-x} + e^{-y}\) 变为 \(e^{-(x - \delta)} + e^{-(y - \delta)}\) ,最终 BCO 优化目标为:
\[\mathbb{E}_{(x, y_w, y_l) \sim \mathcal{D}^+} \left[ -\log \sigma(r_\theta(x, y_w) - \delta) \right] + \mathbb{E}_{(x, y_w, y_l) \sim \mathcal{D}^-} \left[ -\log \sigma(-(r_\theta(x, y_l) - \delta)) \right]\]文中推导了即便减去 reward shift 也不会改变 BCO 为 DPO 上界,reward shift 取值由均值不等式得到 \(\delta = \frac{\mathbb{E}{(x,y) \sim \mathcal{D}^+}[r\theta(x, y)] + \mathbb{E}{(x,y) \sim \mathcal{D}^-}[r\theta(x, y)]}{2}\),为了训练稳定,使用 EMA 进行计算。BCO 的介绍就完了
从 BCO 的介绍可以知道,它可以作为判断生成好坏的标签从绝对层面进行判断这个 response 的好坏,即 binary 二分 。Generation Loss 其实就是 SFT Loss 主要用于学习偏好回答生成的过程,下面是不同方法的对比结果
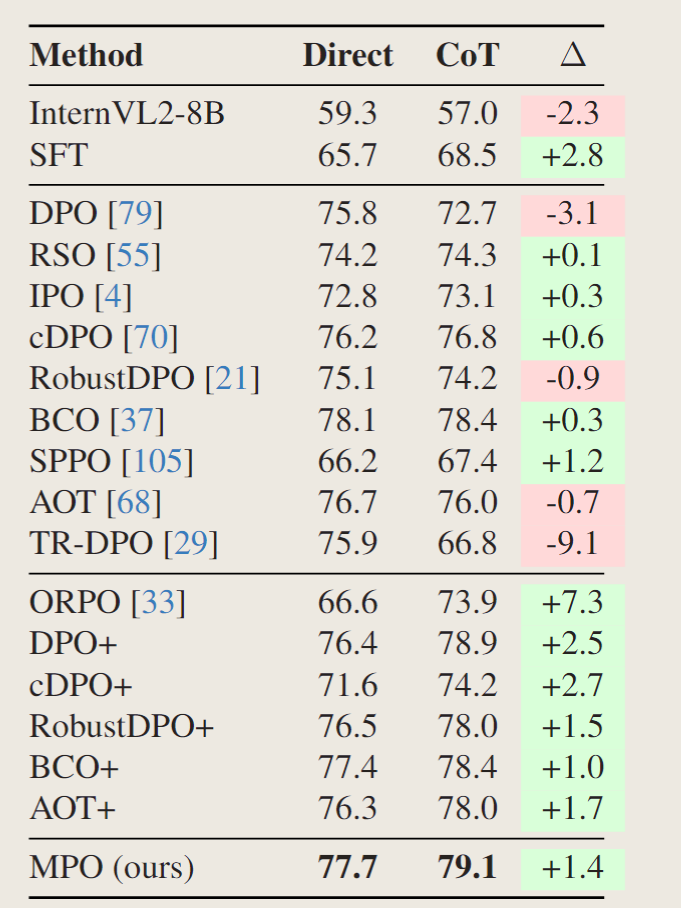
上图中的 + 是使用了 SFT Loss,如 DPO+ 指的 DPO + SFT Loss
DAPO
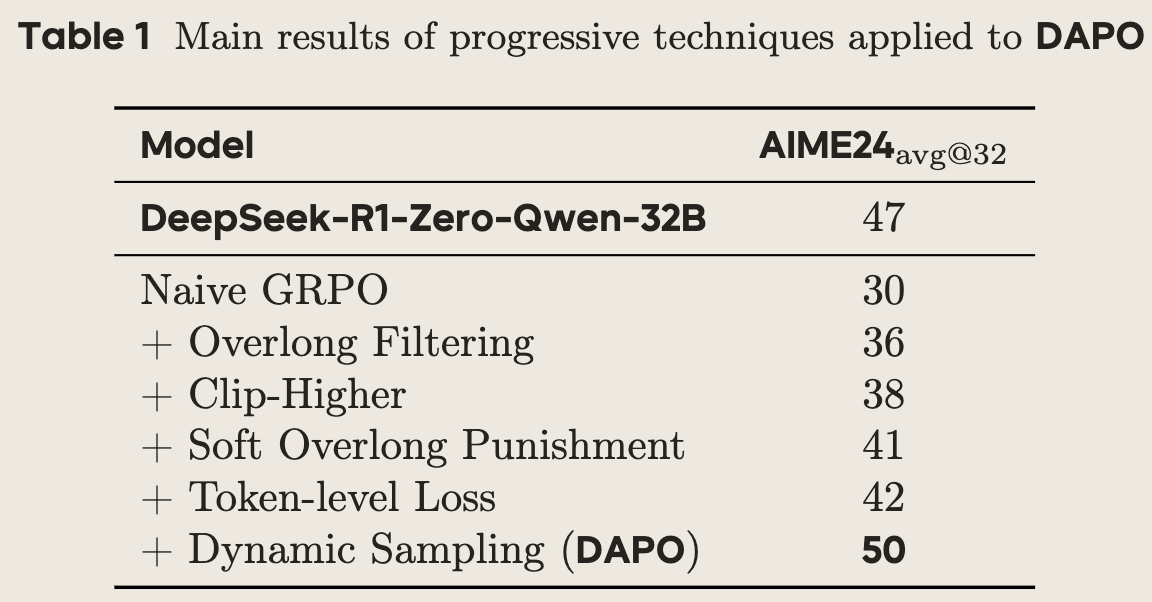
DAPO 是 GRPO 的改进版。作者指出很难去复现 GRPO 在 AIME 上的指标,其中发现了 entropy collapse,reward noise 和 training instability 等问题。为了解决这些问题,作者提出了 Decoupled clip and Dynamic sAmple Policy Optimization 算法,主要从五个方面进行了改进,首先是去除了 KL 散度,是考虑到所训练的 long-CoT reasoning model 的参数分布早已远远不同于初始的模型了,加上会限制模型的发挥
Clip-Higher
我们知道裁剪是对重要性采样的裁剪,如下式
\[1 - \varepsilon_{\text{low}} \le r_{i,t}(\theta) = \frac{\pi_\theta(o_{i,t} \mid q, o_{i,<t})}{\pi_{\theta_{\text{old}}}(o_{i,t} \mid q, o_{i,<t})} \le 1 +\varepsilon_{\text{high}}\]考虑 token 在原 policy 的概率为 0.9是一个高概率的 token ,在现 policy 的概率贡献最多可以为 1.08,同样对于一个较少采样的 token 其概率为 0.01,哪怕现 policy 概率为 1 也只能贡献 0.012 所占用的权重依然很小,导致模型很难选用这个 token。文中通过将裁剪的上界和下界分别进行设置,旨在提高原 policy 低概率 token 的采用可能性文中给这类 token 取名为 exploration token 能增强模型的探索的可能性,相反另外一种为 exploitation token 。因此第一个改动为
\[\text{clip}\left(r_{i,t}(\theta), 1 - \varepsilon, 1 + \varepsilon\right) \rightarrow \text{clip}\left(r_{i,t}(\theta), 1 - \varepsilon_{\text{low}}, 1 + \varepsilon_{\text{high}}\right)\]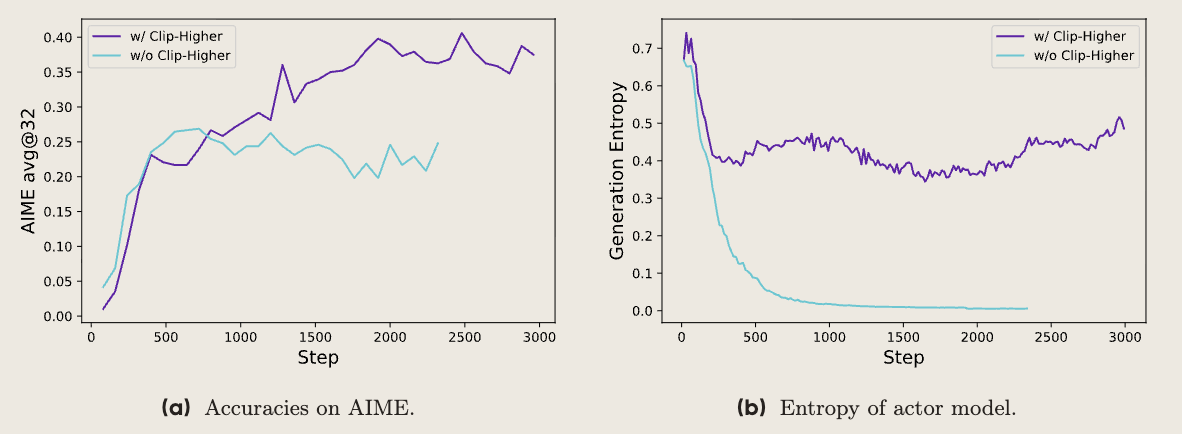
如图可知当使用了 clip higher 之后,old policy 中的低概率 token 会得到更多的贡献,但实际上是对于优势为正的 token 采取了更加激进的策略,增强了 old policy 中概率小于在 \(1/(1+\varepsilon)\) 的 token 采样几率,在上图表现为增加的粉红采样区域
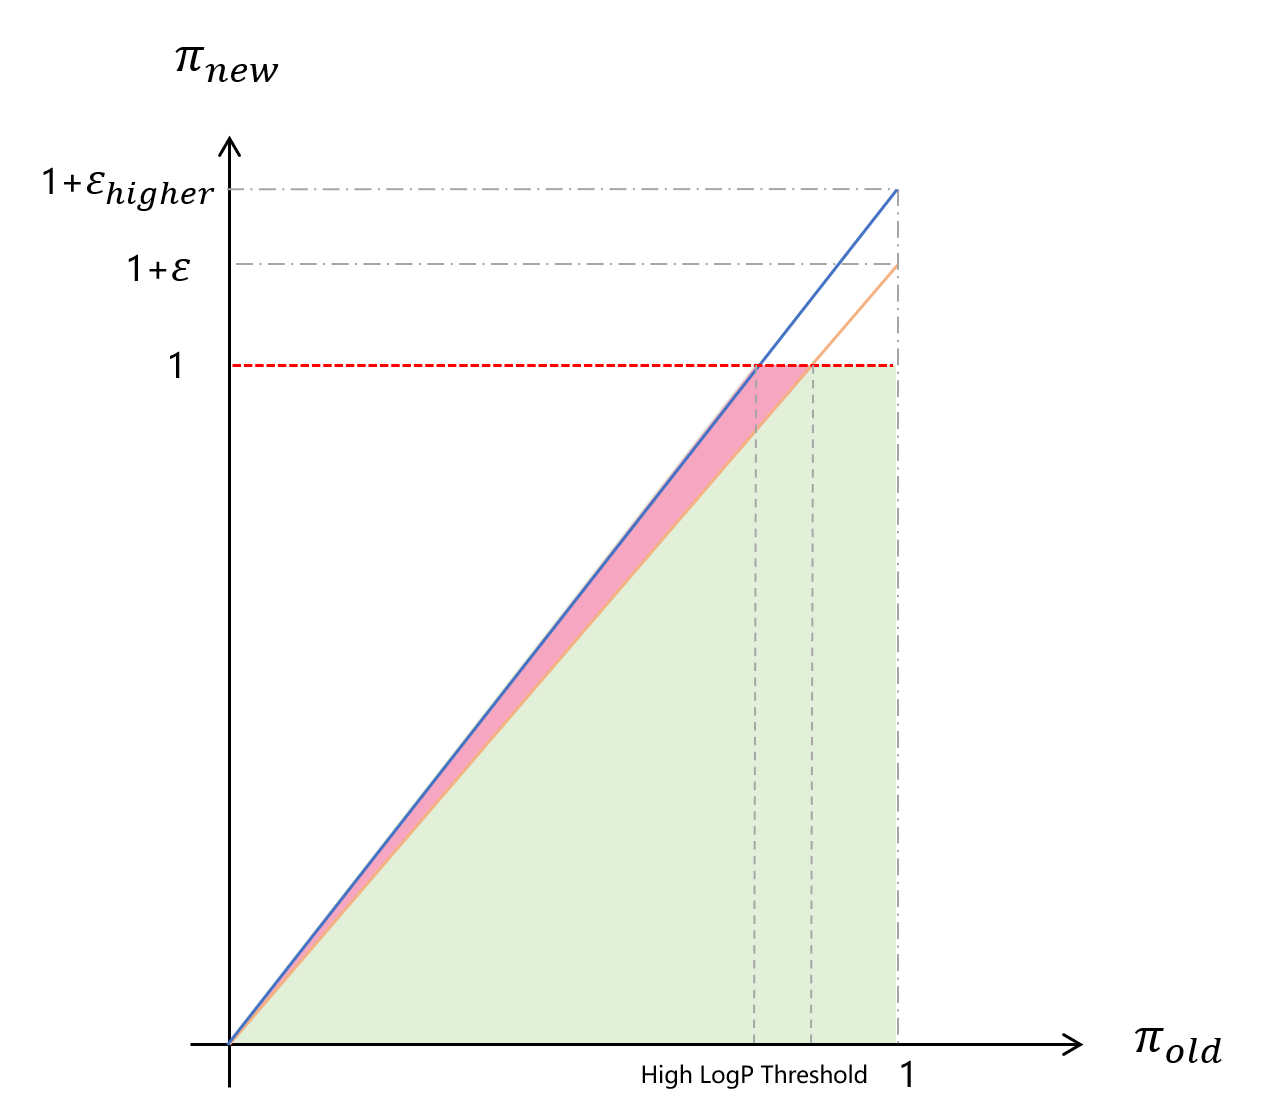
其中 clip 的上限提高了,为了防止低概率 token 容易更低,下限保持没变。效果也很明显, actor 的 entropy collapse 得到了一定程度的解决。文中采取以下配置 : \(\varepsilon_{\text{low}}\) 为 0.2 和 \(\varepsilon_{\text{high}}\) 为 0.28
Dynamic Sampling
这部分的改进主要是针对某些 prompt 生成的 response 都是对的,这时候 advantage 将会变为 0。那么梯度将会非常小,基本等于白跑。而且会造成梯度方差过大从而影响训练。改进方式也挺简单:一直 sample 直到不全为 0 或者 1论文特别说明这种策略并不会影响训练速度,主要是由于采样速度是由长尾数据影响的
Token-Level Policy Gradient Loss
我们可以先看看 GRPO 怎么算 loss 的
\[\frac{1}{G} \sum_{i=1}^{G} \frac{1}{|o_i|} \sum_{t=1}^{|o_i|} \left( \min \left( r_{i,t}(\theta) \hat{A}_{i,t},\ \text{clip}\left(r_{i,t}(\theta), 1 - \varepsilon, 1 + \varepsilon\right) \hat{A}_{i,t} \right) - \beta D_{\text{KL}}(\pi_\theta \| \pi_{\text{ref}}) \right)\]GRPO 是对于组内每一个 sample 进行 token 级别的平均,然后再进行 sample 级别的平均。这样对于每个 sample 实际上使用了相同的权重,比较长的回答实际上没有对 loss 有更多的贡献。会导致两个缺陷:对于高质量的长回答不能更加重视,既不能学习太多有效的长思考过程,也不能有效遏制重复的垃圾话。 DAPO 则是进行了 token 级别的计算
\[\frac{1}{\sum_{i=1}^{G} |o_i|} \sum_{i=1}^{G} \sum_{t=1}^{|o_i|} \min \left( r_{i,t}(\theta) \hat{A}_{i,t},\ \text{clip}\left(r_{i,t}(\theta), 1 - \varepsilon_{\text{low}}, 1 + \varepsilon_{\text{high}}\right) \hat{A}_{i,t} \right)\]假设单个 sample 的 loss 总和是 \(loss_i\),token 数量为 \(n_i\),一共 \(G\) 个 sample,则一个 group loss 计算变化如下:
\[\frac{loss_{0}}{n_{0}G} + \frac{loss_{1}}{n_{1}G} + \frac{loss_{2}}{n_{2}G} + \cdots \rightarrow \frac{loss_{0} + loss_{1} + loss_{2}+ \cdots }{n_{0} + n_{1} + n_{2} + \cdots }\]从上式可以看出来,DAPO 的 loss 实际上使用同样的 normalization,从相对数值来说,同样等于没用,这时候长回答的 loss 能够体现他真正的 loss 贡献GRPO 每个 sample 在内部做 normalize 被论文称为 sample level,DAPO 是 sample 内部并没有做 normalize 而是所有 token 一起求和后做 normalize 这样每个 token 的权重是一样的,不会因为 sample 的长度而不一样
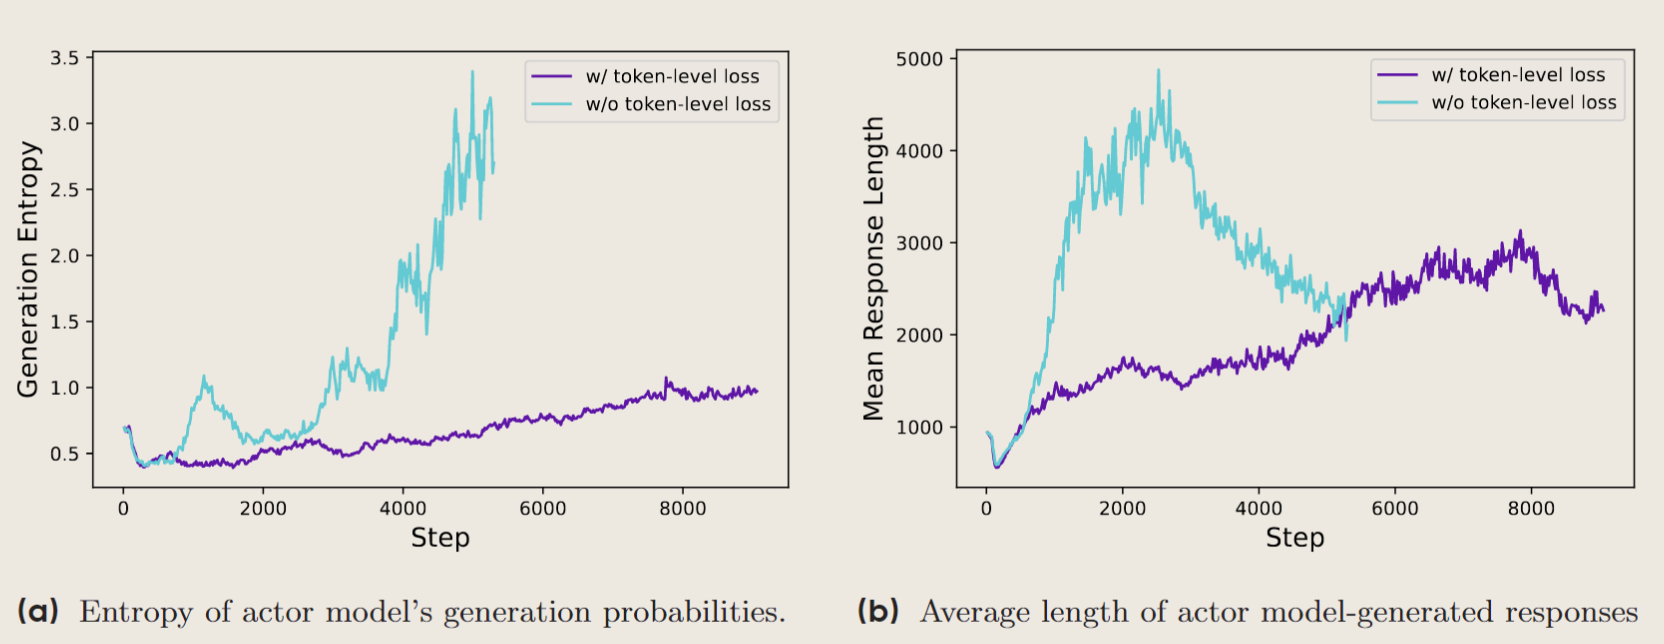
可以看到回答长度没有疯涨了,因为会遏制重复的垃圾话模式
Overlong Reward Shaping
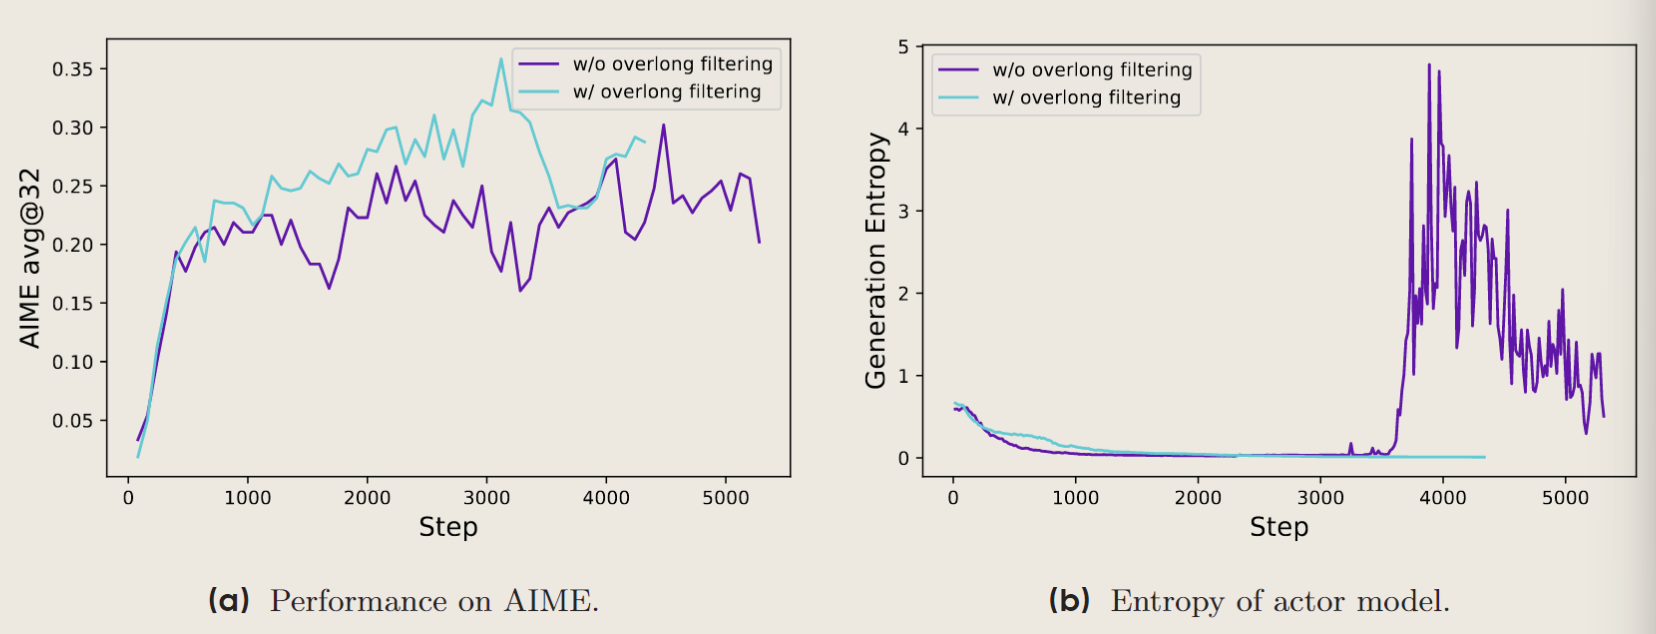
主要是关于有的回答过长而被截断的情况,这种 reward 非常影响训练,文章使用了分段函数解决这个问题:
\[R_{\text{length}}(y) = \begin{cases}0, & |y| \leq L_{\text{max}} - L_{\text{cache}} \\\frac{(L_{\text{max}} - L_{\text{cache}}) - |y|}{L_{\text{cache}}}, & L_{\text{max}} - L_{\text{cache}} < |y| \leq L_{\text{max}} \\-1, & L_{\text{max}} < |y|\end{cases}\]越长惩罚越大,从下图可以看到整体平稳了很多
最后是每一项提点的表现
GSPO
Group Sequence Policy Optimization 是 Qwen 团队基于 GRPO 之上提出的强化学习方法。在 RL 中常常为了采样的效率考虑,会把一个大 batch 分成多个 mini-batch。这就使得了采样来自 old policy 用于优化 new policy,这也是为什么需要重要性采样的原因关于重要性采样可以阅读重要性采样与PPO、TRPO以及重要性采样(Importance Sampling)等文章
文章提出了 GRPO 中一个根本性的问题:重要性采样权重的错误应用导致 long-response 任务训练时会 model collapse。简单来说,就是 GRPO 的重要性采样时 token level 的,但是整个奖励确实 sample level 的。这会使得训练的梯度有高方差的噪声,特别是在训练 long-response 数据和使用 clipping 的时候,如果使得 model collapse 即便加载之前的 checkpoint 也无法逆转这点是为什么呢,因为加载过后也会走老路吗 对此,论文提出了 GSPO
\[\mathbb{E}_{x \sim \mathcal{D},\, \{y_i\}_{i=1}^G \sim \pi_{\theta_{\text{old}}}(\cdot|x)} \left[ \frac{1}{G} \sum_{i=1}^G \min\left( s_i(\theta) \hat{A}_i,\, \text{clip}\left(s_i(\theta), 1-\varepsilon, 1+\varepsilon\right) \hat{A}_i \right) \right]\]其中
\[s_i(\theta) = \left( \frac{\pi_\theta(y_i|x)}{\pi_{\theta_{\text{old}}}(y_i|x)} \right)^{\frac{1}{|y_i|}} = \exp\left( \frac{1}{|y_i|} \sum_{t=1}^{|y_i|} \log \frac{\pi_\theta(y_{i,t}|x, y_{i,<t})}{\pi_{\theta_{\text{old}}}(y_{i,t}|x, y_{i,<t})} \right)\]可以看到主要的区别在于对重要性的计算上,GSPO 是对每个 token 的重要性采样然后进行求和得到,从下面的代码可以看出: GSPO 对于每一个 token 的重要性采样都是一样的,即 sample level
# source: https://github.com/huggingface/trl/blob/main/trl/trainer/grpo_trainer.py
# get old policy logps, there is need the old policy logps on update every step
generate_every = self.args.steps_per_generation * self.num_iterations
if self.args.gradient_accumulation_steps % generate_every != 0 or (
    self.use_vllm and self.vllm_importance_sampling_correction
):
    old_per_token_logps, _ = self._get_per_token_logps_and_entropies(
        self.model,
        prompt_completion_ids,
        attention_mask,
        logits_to_keep,
        batch_size,
        num_images=num_images,
        **forward_kwargs,
    )
else:
    old_per_token_logps = None

# get reference model logs
ref_per_token_logps = self._get_per_token_logps(
		self.ref_model, prompt_completion_ids, attention_mask, logits_to_keep
)

# get KL
if self.beta != 0.0:
    ref_per_token_logps = inputs["ref_per_token_logps"]
    per_token_kl = (
        torch.exp(ref_per_token_logps - per_token_logps) - (ref_per_token_logps - per_token_logps) - 1
    )

# get Reward
rewards_per_func = self._calculate_rewards(inputs, prompts, completions, completion_ids_list)

# Apply weights to each reward function's output and sum
rewards = (rewards_per_func * self.reward_weights.to(device).unsqueeze(0)).nansum(dim=1)

# get the Advantages
mean_grouped_rewards = rewards.view(-1, num_generations).mean(dim=1)
mean_grouped_rewards = mean_grouped_rewards.repeat_interleave(num_generations, dim=0)
advantages = rewards - mean_grouped_rewards

if self.scale_rewards in ["group", "none"]:
    # If self.scale_rewards = "none", we'll still log group level std
    std_rewards = rewards.view(-1, num_generations).std(dim=1)
    std_rewards = std_rewards.repeat_interleave(num_generations, dim=0)
elif self.scale_rewards == "batch":
    # Compute global std
    std_rewards = rewards.std().expand_as(rewards)
else:
    raise ValueError(
        f"Invalid value for scale_rewards: {self.scale_rewards}. Must be one of 'batch', 'group', or 'none'."
    )

# get Importance Sample issue: https://github.com/huggingface/trl/issues/2608
old_per_token_logps = per_token_logps.detach() if old_per_token_logps is None else old_per_token_logps
log_ratio = per_token_logps - old_per_token_logps
if self.importance_sampling_level == "token":      # for GRPO
    log_importance_weights = log_ratio
elif self.importance_sampling_level == "sequence": # for GSPO
    log_importance_weights = (log_ratio * completion_mask).sum(-1) / completion_mask.sum(-1).clamp(min=1.0)
		log_importance_weights = log_importance_weights.unsqueeze(-1)
else:
    raise ValueError(
        f"Unknown importance sampling level: {self.importance_sampling_level}. Possible values are 'token' "
        "and 'sequence'."
    )

# alppy Clip
coef_1 = torch.exp(log_importance_weights)
# From here, log_importance_weights (and all subsequent tensors, coef_1, coef_2, etc.) shape depends on

# importance_sampling_level: "token" level: (B, T); "sequence" level: (B, 1)
if self.loss_type in ["grpo", "bnpo", "dr_grpo", "dapo"]:
    coef_2 = torch.clamp(coef_1, 1 - self.epsilon_low, 1 + self.epsilon_high)
    # Two-sided clipping
    if self.args.delta is not None:
        coef_1 = torch.clamp(coef_1, max=self.args.delta)

    per_token_loss1 = coef_1 * advantages
    per_token_loss2 = coef_2 * advantages
    per_token_loss = -torch.min(per_token_loss1, per_token_loss2)
else:
    raise ValueError(f"Unknown loss type: {self.loss_type}")

# add kl
if self.beta != 0.0:
    per_token_loss = per_token_loss + self.beta * per_token_kl

# normalize loss
if self.loss_type == "grpo":
    loss = ((per_token_loss * completion_mask).sum(-1) / completion_mask.sum(-1).clamp(min=1.0)).mean()
    loss = loss / self.current_gradient_accumulation_steps
elif self.loss_type in ["cispo", "dapo"]:
    normalizer = inputs["num_items_in_batch"] / self.accelerator.num_processes
    loss = (per_token_loss * completion_mask).sum() / normalizer
从梯度影响上看
GRPO
\[\mathbb{E}_{x \sim \mathcal{D},\, \{y_i\}_{i=1}^G \sim \pi_{\theta_{\text{old}}}(\cdot|x)} \left[ \frac{1}{G} \sum_{i=1}^G \hat{A}_i \cdot \frac{1}{|y_i|} \sum_{t=1}^{|y_i|} \frac{\pi_\theta(y_{i,t}|x, y_{i,<t})}{\pi_{\theta_{\text{old}}}(y_{i,t}|x, y_{i,<t})} \nabla_\theta \log \pi_\theta(y_{i,t}|x, y_{i,<t}) \right]\]GSPO
\[\mathbb{E}_{x \sim \mathcal{D},\, \{y_i\}_{i=1}^G \sim \pi_{\theta_{\text{old}}}(\cdot|x)} \left[ \frac{1}{G} \sum_{i=1}^G \left( \frac{\pi_\theta(y_i|x)}{\pi_{\theta_{\text{old}}}(y_i|x)} \right)^{\frac{1}{|y_i|}} \hat{A}_i \cdot \frac{1}{|y_i|} \sum_{t=1}^{|y_i|} \nabla_\theta \log \pi_\theta(y_{i,t}|x, y_{i,<t}) \right]\]可以看出来 GRPO 的重要性采样对每一个 token 的梯度都会有影响,这在 long-response 的情况可能会出现不可预测的问题当错误的时候,累积过多,可能直接 model collapse 。GSPO 更像一个平均策略,这样会更稳一点波动小点,但不一定更精确
番外篇
关于 GRPO 一开始训练 loss 为零的问题,主要是因为最开始 new policy 和 old policy 是一样的,此时重要性采样为 1, KL 为 0,而 advantage 的期望为 0,所以 loss 非常接近 0。loss 为0,参数为啥还能更新呢?有两种说法是:advantage 的期望是 0 但可能不会完全为 0;bf16 计算本来也有误差很难完全为 0。详细讨论可以参考:Why does the loss start at 0 when I train GRPO, and then possibly increase?
Reference
An Efficient Post-Processing Framework for Mixing Diverse Preference Alignment
不靠谱】有关DPO训练时,为什么chosen和rejected的reward一起下降的猜想
Why does the loss start at 0 when I train GRPO, and then possibly increase
🌸 November 27, 2025
Comments
Sign in with GitHub to comment, or click the bottom icon to chat with me.