BFCL-TauBench
这篇 Blog 主要对关于 multi turn 和 function call 相关的 benchmark:The Berkeley Function-Calling Leaderboard 和 τ-Bench 进行介绍
The Berkeley Function-Calling Leaderboard(BFCL)
这是 Berkeley 做的一个关于 Function Call(FC) 的 benchmark。目前包括:Agentic、Multi Turn、Single Turn 和 Hallucination Measurement 等相关的 benchmark。这里主要针对其中 Multi Turn benchmark 的设计进行介绍
关于 Multi-Turn 与 Multi-Step 的定义
Multi Turn 指的多轮对话,Multi Step 指的是每一轮多步的 FC 调用。下图是关于 BFCL 中关于 Single Turn、Multi Turn 和 Multi Step 的示例
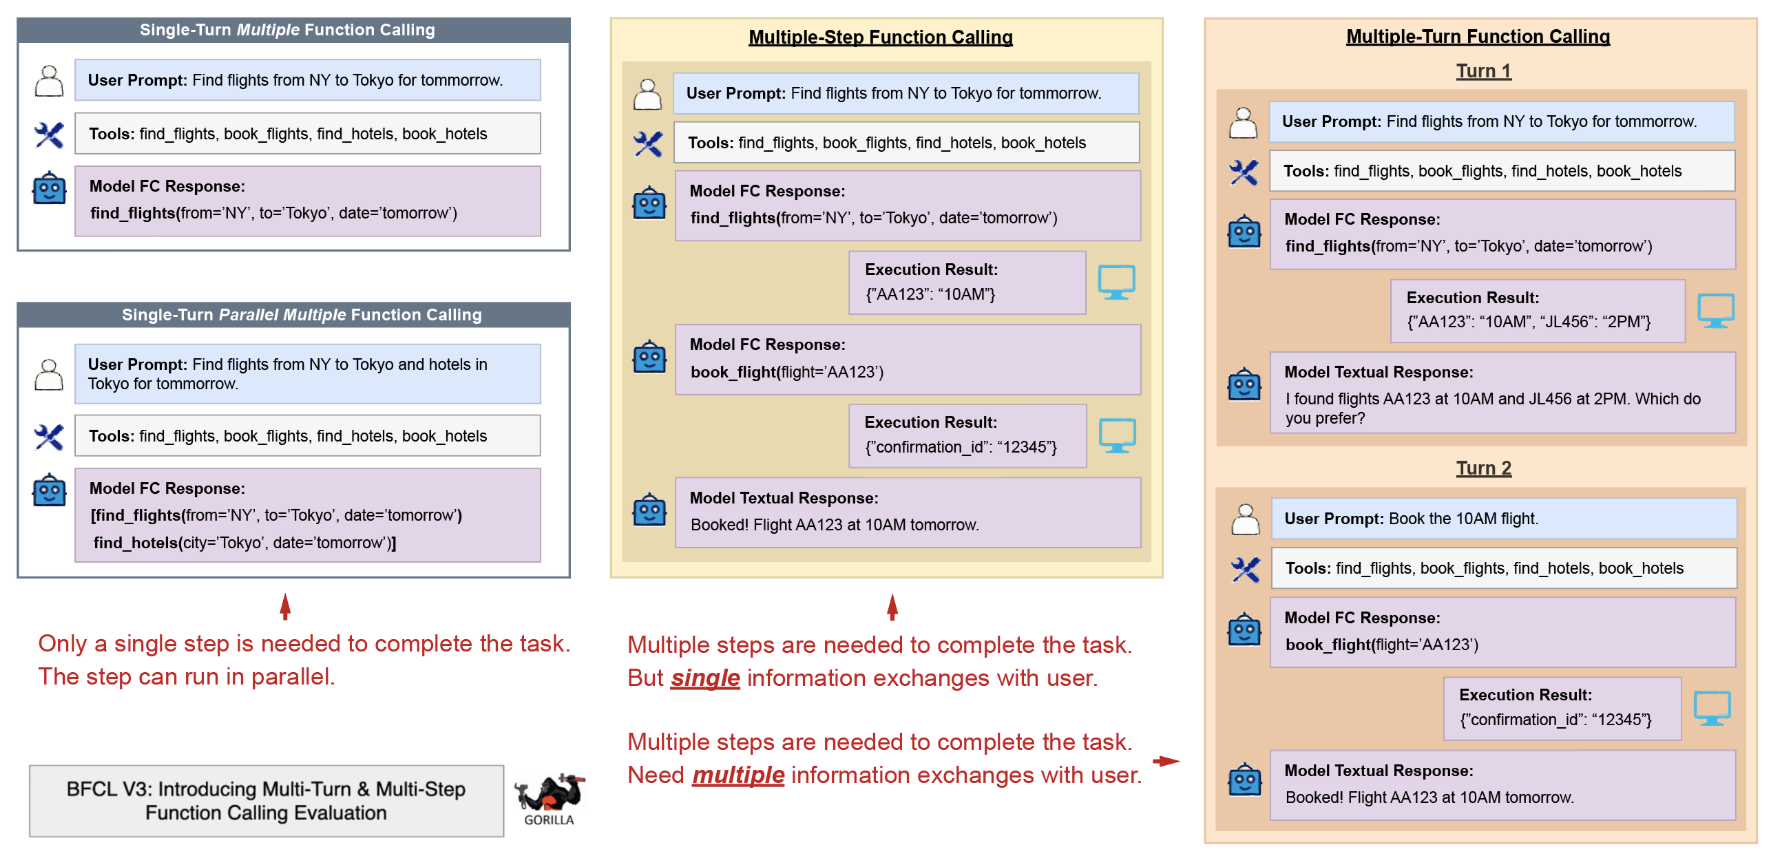
Multi-Turn 的必要性
- 与真实的情景更加的贴近,往往 user 需要不断在对话澄清自己的需求
- 在复杂的 workflow 里,往往一个 function 的输出是另外一个的输入(即 multi step)
- 在不断的找出和纠错的中可以使得对话系统更加 robust
关于数据集构建细节
现有数据集现状
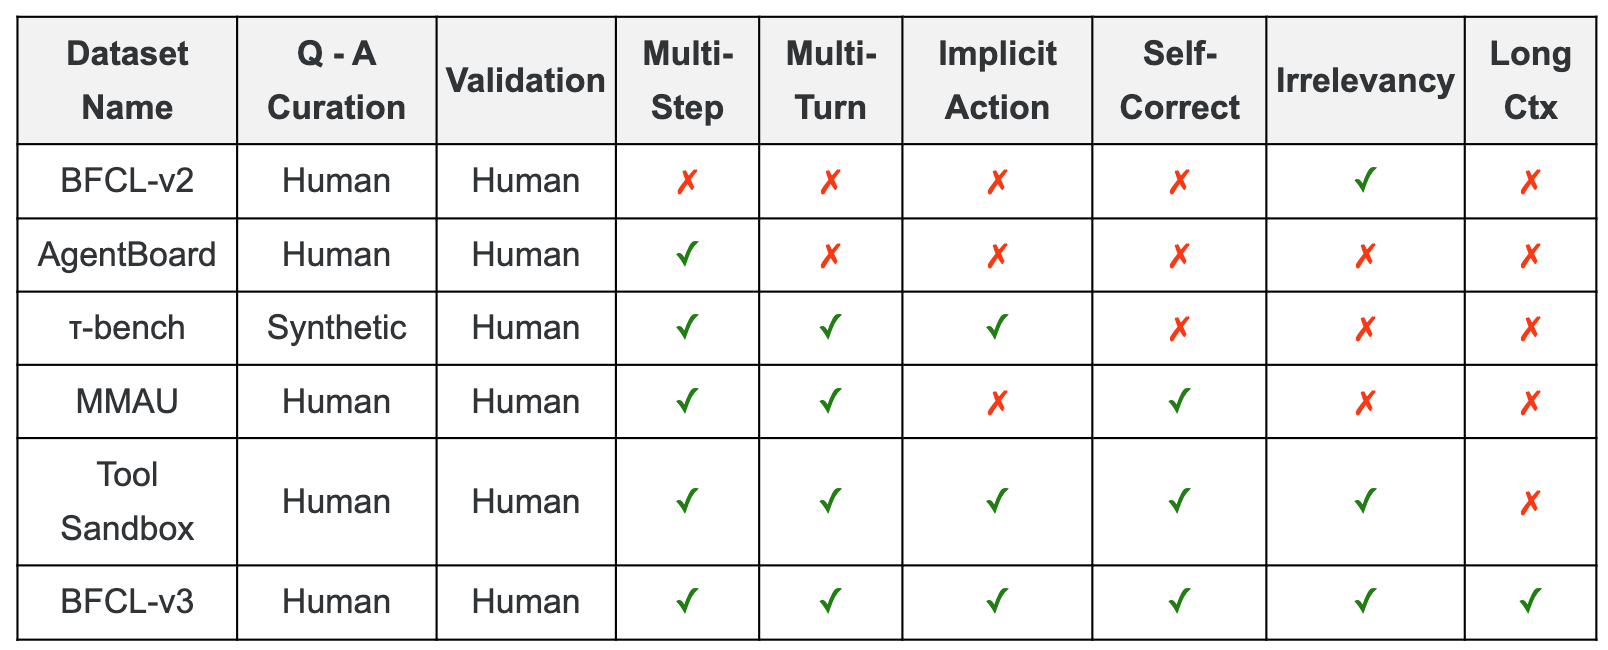
BFCL 中 Multi Turn 数据类型组成
数据总量 1000 条
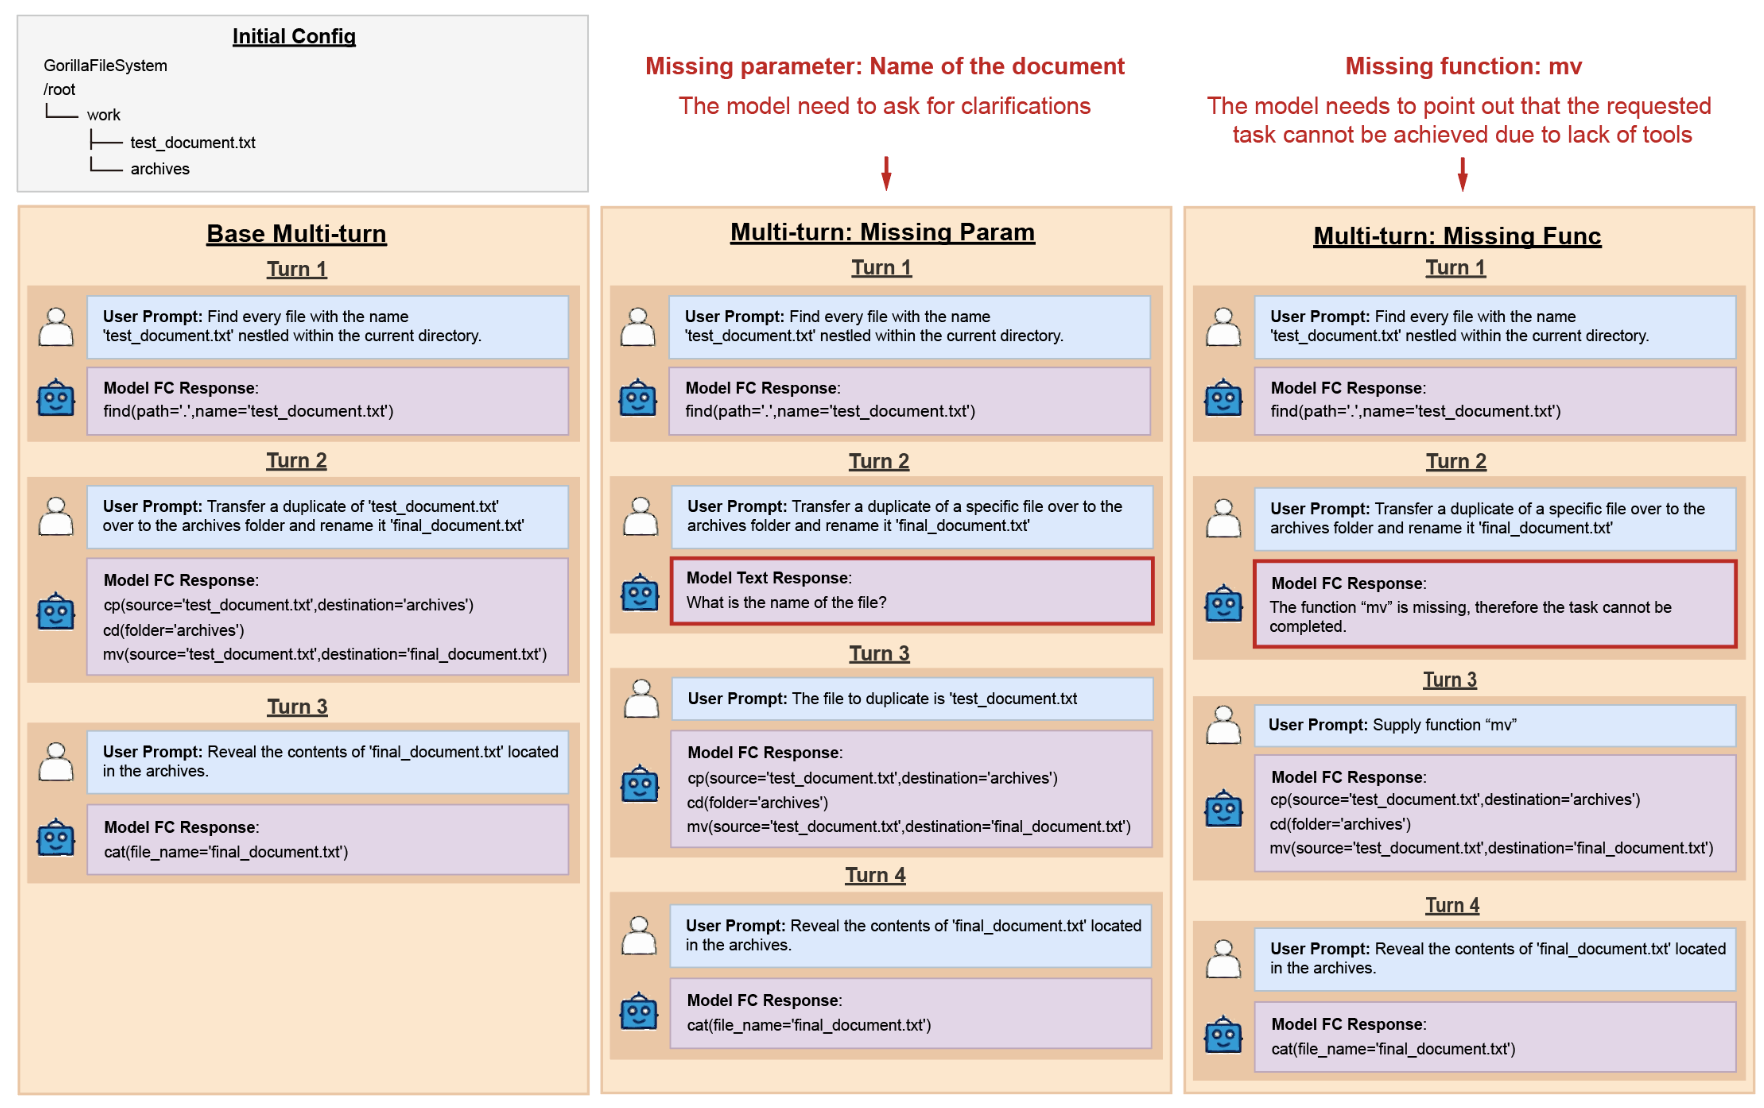
- Base Multi-Turn:一共 200 条。这部分的数据所有信息清楚明了,无论是用户的请求、前一轮的结果到后一轮的输出等
- Augmented Multi-Turn:一共 800 条。这部分数据或 prompts 模棱两可或当前状体不对,模型需要通过 QA 来获得更多细节才能进行做决定、清晰需求等,以下是子类别,每一类有 200 条
- Missing Parameters:缺少一些调用 function 的参数,此时模型需要继续询问
- Missing Functions:不存在或者缺少这个 function 可用的情况
- Long-Context Multi-Turn:长文本的情况,比如上百的文件或者上千条记录
- Composite:以上情况的组合情况
下图是相关的示意图
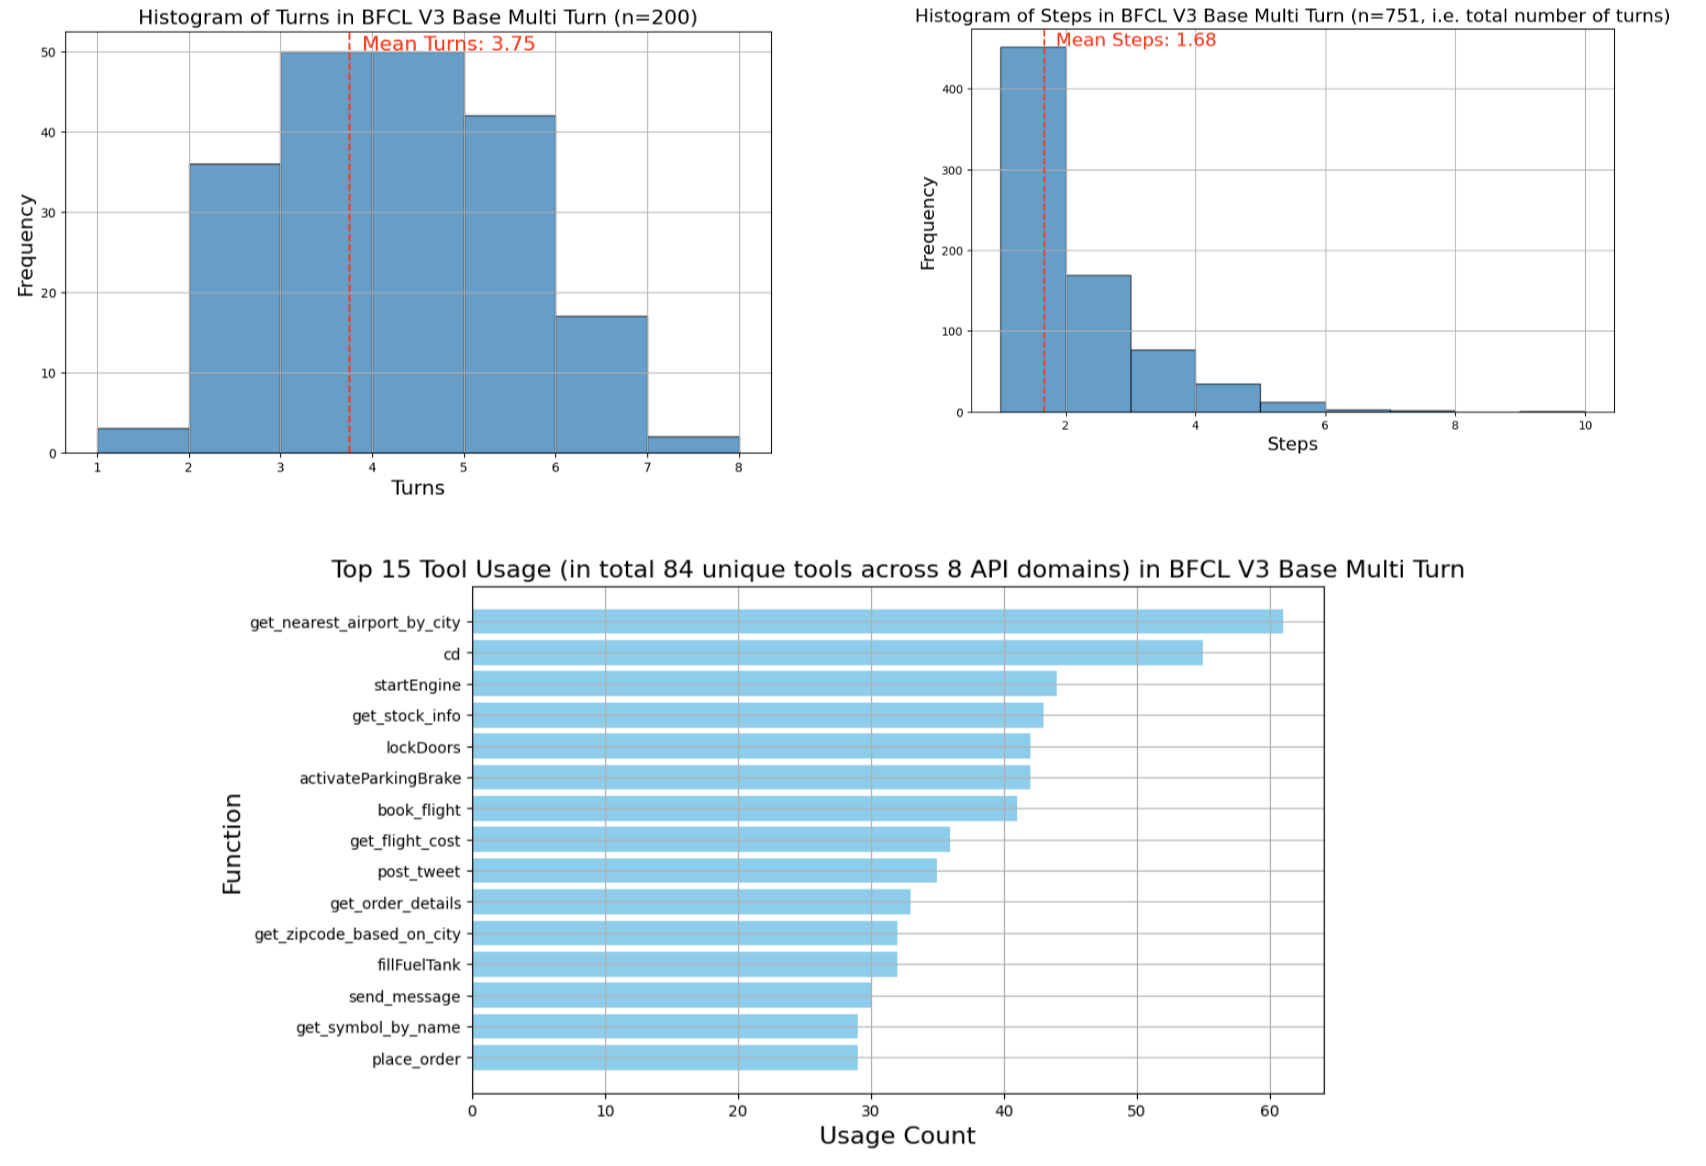
关于 turns 和 steps 的统计
数据集构建流程及细节
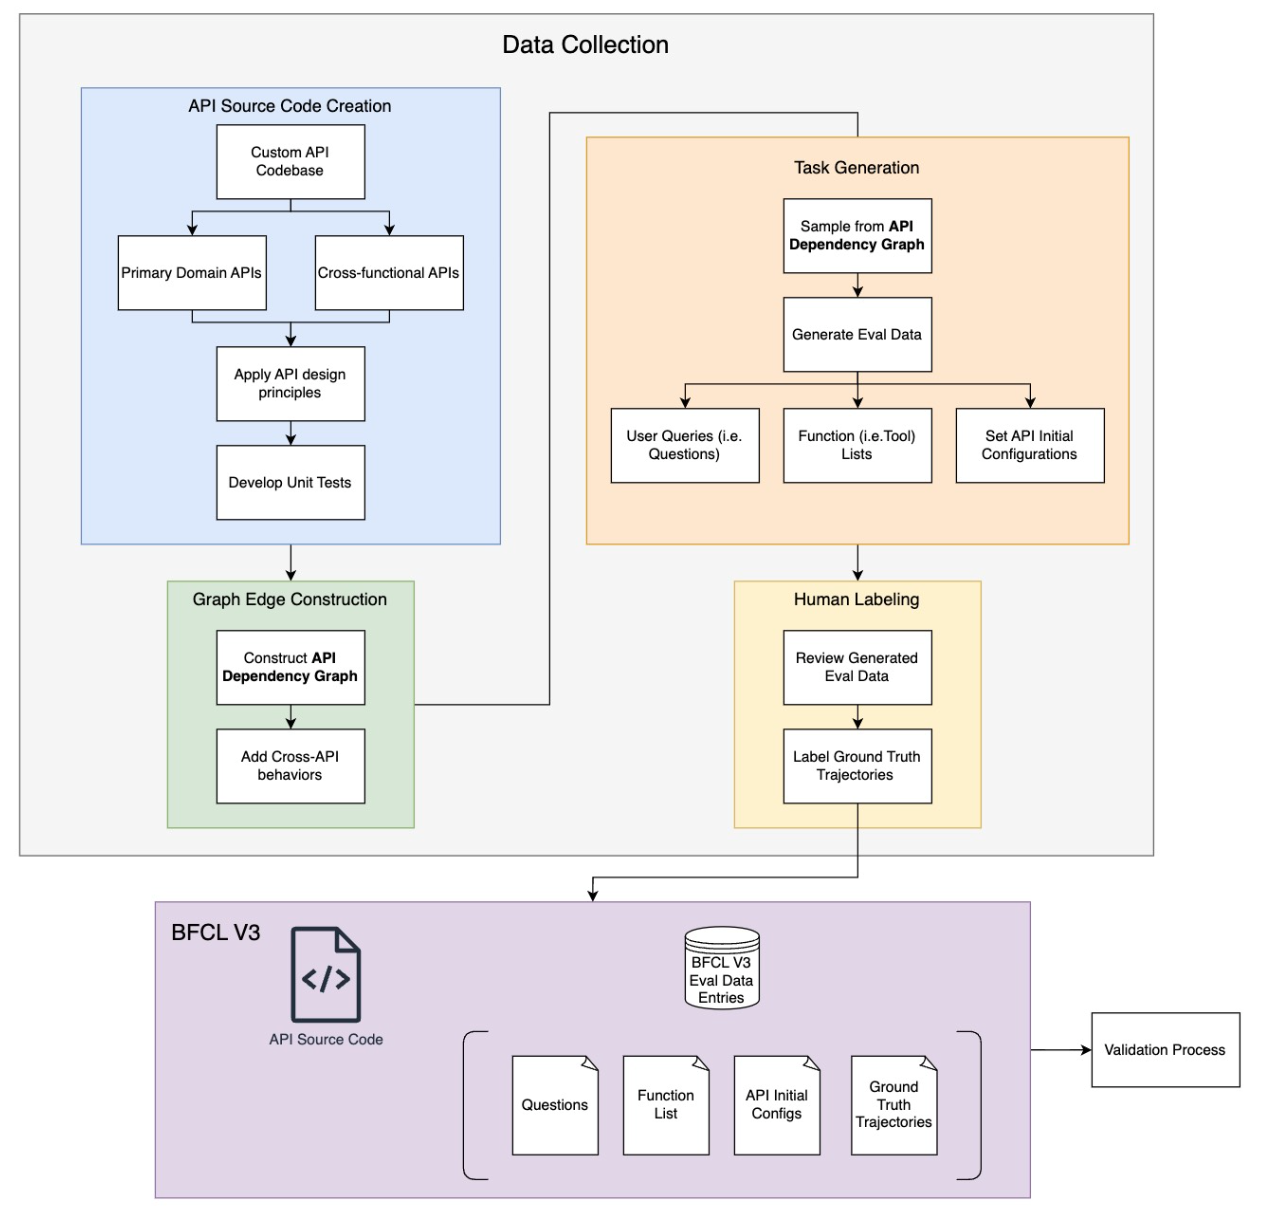
数据集构建主要分为三部分:
- 构建 API 之间的上下游关系,组建图
- 在图里 sample 不同的路径
- 人工根据初始设置核验结果
整体 pipline 如下
API Codebase Creation
主要分为两类 API
- Primary Domain APIs
- Vehicle Control:展示汽车的状态、预估距离等
- Trading Bots:获取股票信息、下单、获取账户信息等
- Travel Booking:订机票、获取最近机场的位置、买保险等
- Gorilla File System:ls cd cat 等系统操作命令
- Cross-functional APIs
- Message API:发送信息、删除信息、查看接收到的信息等
- Twitter API:发推、转推、评论等
- Ticket API:创建、关闭等
- Math API:平均值、方差等
其中 Primary Domain APIs 平均分布在 Base 和 Augmented Multi Turn 中,比如 Base 一共 200 条,其中涉及 Primary Domain APIs 下的 4 类各 50 条
Graph Edge Construction
有了这些 API 便可以根据他们的关系进行搭建图,最后根据图来随机 sample 路径进行构建数据。如图所示,使用 Trading API 时,就存在几个 API 的依赖关系,完成操作过后可能和其他 API,如 Message API 有依赖关系API 之间可能由次序的依赖关系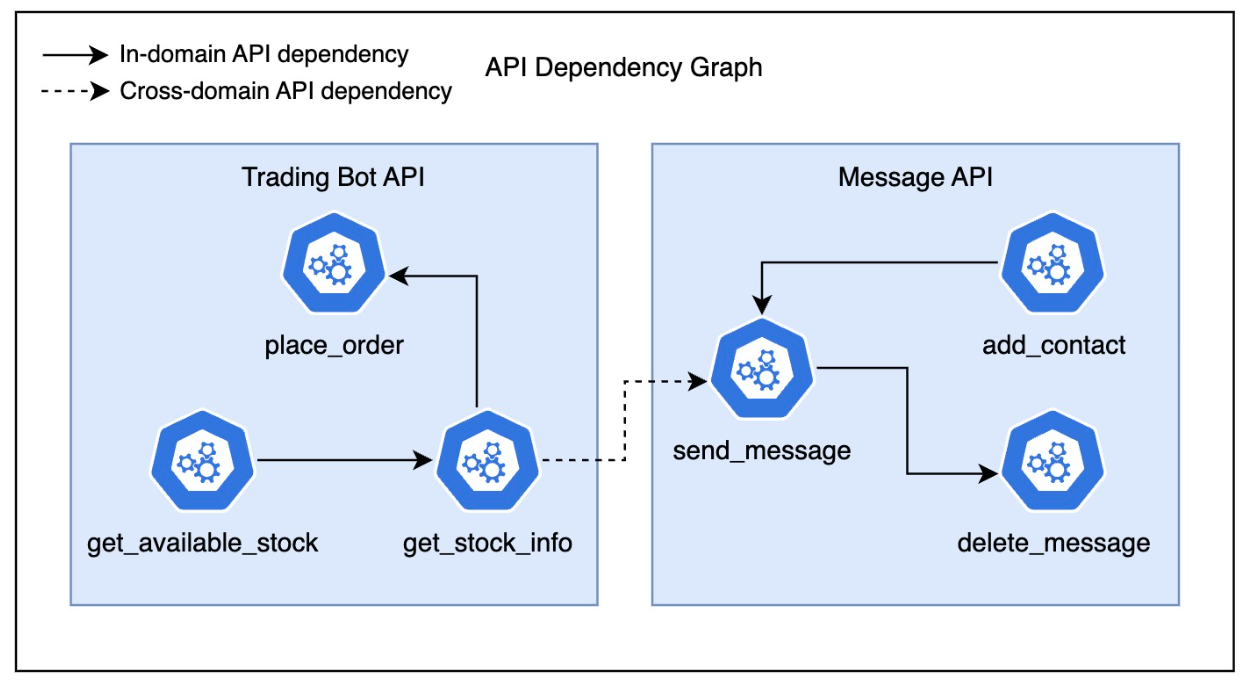
Task Generation
主要的构件如下:
- Question:考虑到不同人群的提问风格和语气问题:会从 Persona Hub 生成不同年龄、职业、性别的用户背景
- Function Lists:对于每一个 query,都会给 model 提供可用的 API 库
- Initial Configurations:比如对于一些任务中某些验证和授权已经给了,就避免后续的反复询问
Human-Labeled Ground Truth Multi-Turn Trajectories
人工对于数据的核验非常重要,可以防止 accuracy 过低以及生成的幻觉数据等
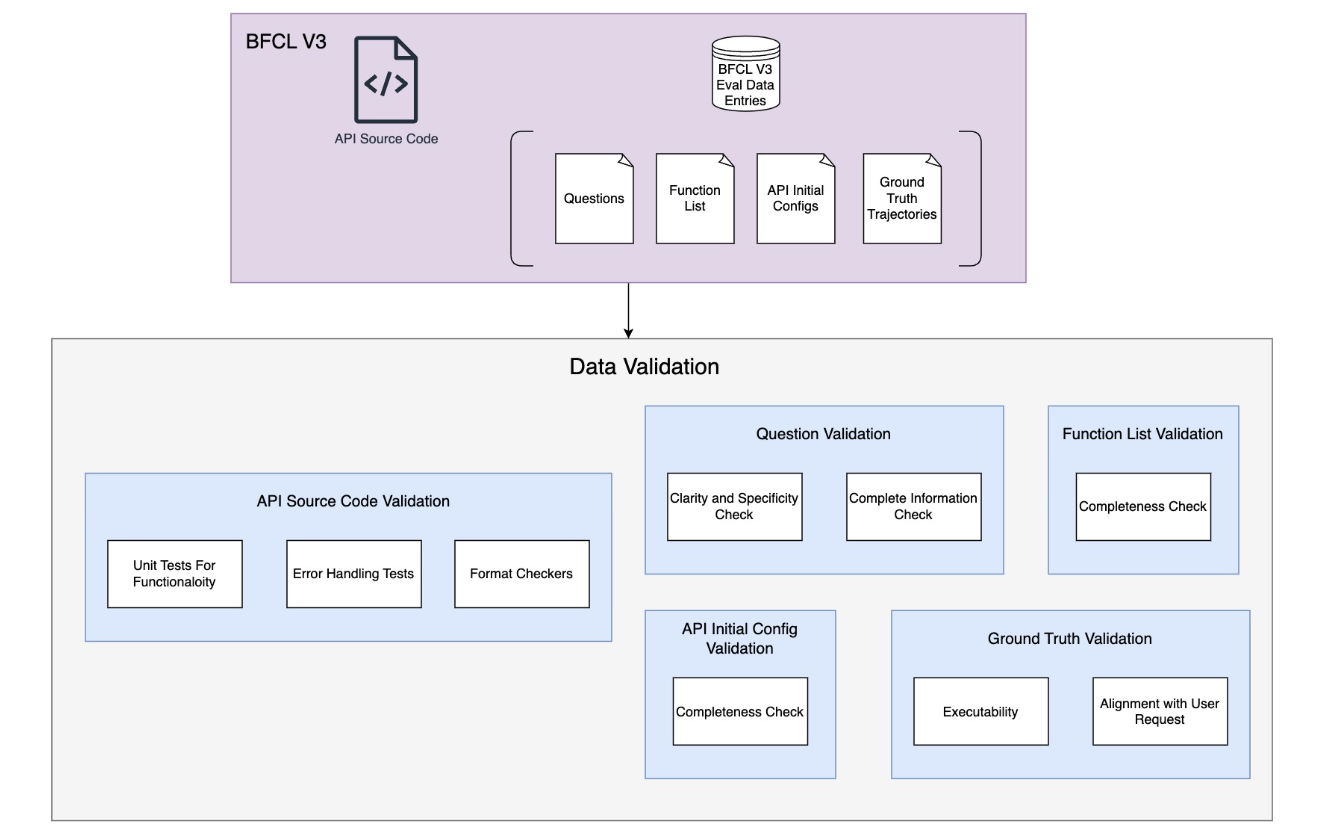
根据上图的示意主要对一下几个部分进行核验
Question Validation
对于每一个问题保证只有一种正确的答案
- Clarity and Specificity:更加清楚的需求:“上传一下文档” → “上传一下
这个文档“ - Complete Information:当前问题和之前的问题送到这轮时,都需要有所有必须的细节信息来调用正确的 function
Human-Labeled Ground Truth Validation
保证数据的可靠性
- Executability:所有 API 都是可执行的,不会报错
- Alignment with User Request:API 所采样路径和 API 调用的顺序需要和用户的意图一致,比如:获取价格肯定在下单之前
- Brevity:执行逻辑应该尽量简洁,不需要不必要的 API
Initial Configuration Validation
- Completeness:所有需要的信息都存在,比如:请求模型删除文件,需要验证文件是否存在
- Uniqueness:所有初始化信息应该是 unique 的,比如:一个 card 存在,就不应该被重复 register
Function List Validation
- Completeness:保证模型能够正常的 call
API Code Validation
- Unit Tests for Functionality:每个 API 需要进行单元测试
- Error Handling Tests:一些 functions 可以被设计为缺少某些参数或者无效的输入时发生错误的 handing
- Automated Format Checkers:对于严格要求数据类型的 function 需要检查和纠正格式和数据类型
Evaluation
Pip-line
- Initialization:初始的 config 用于初始化 API backend 的状态,每一次 query 都需要更新
- Start of a Turn:在最开始的一轮对话,用户的信息以及可用的工具都会加到历史对话中
- Within a Turn:在一轮对话主要进行之前信息的获取,当前步骤的执行,以及历史对话的更新,进行下一步骤
- Termination of a Turn:一轮对话的结束主要包括,没有调用有效的 function 或者执行完成函数;超出了最大 step 数
Metrics
主要分为 state-based 和 response-based 两个方面
- state-based:可能存在多种方式解决问题的情况,检查最后的效果可能会更好
- response-based:将执行路径和标注的最短路径进行比较,检查模型有没有做无意义的操作
τ-Bench 1 & 2
τ-bench 是 Sierra 这个公司(一家做智能客户客户的公司)提出的 Tool Agent 相关的 benchmark,这里主要关注他们关于数据构建相关的工作 τ1-banch and τ2-bench
Tool-Agent-User Interaction In Version 1
整个过程可以当作马尔可夫决策过程来看待:状态空间 S、行为空间 A、观察空间 O、转换空间 T、指令空间 U 一起组成该过程
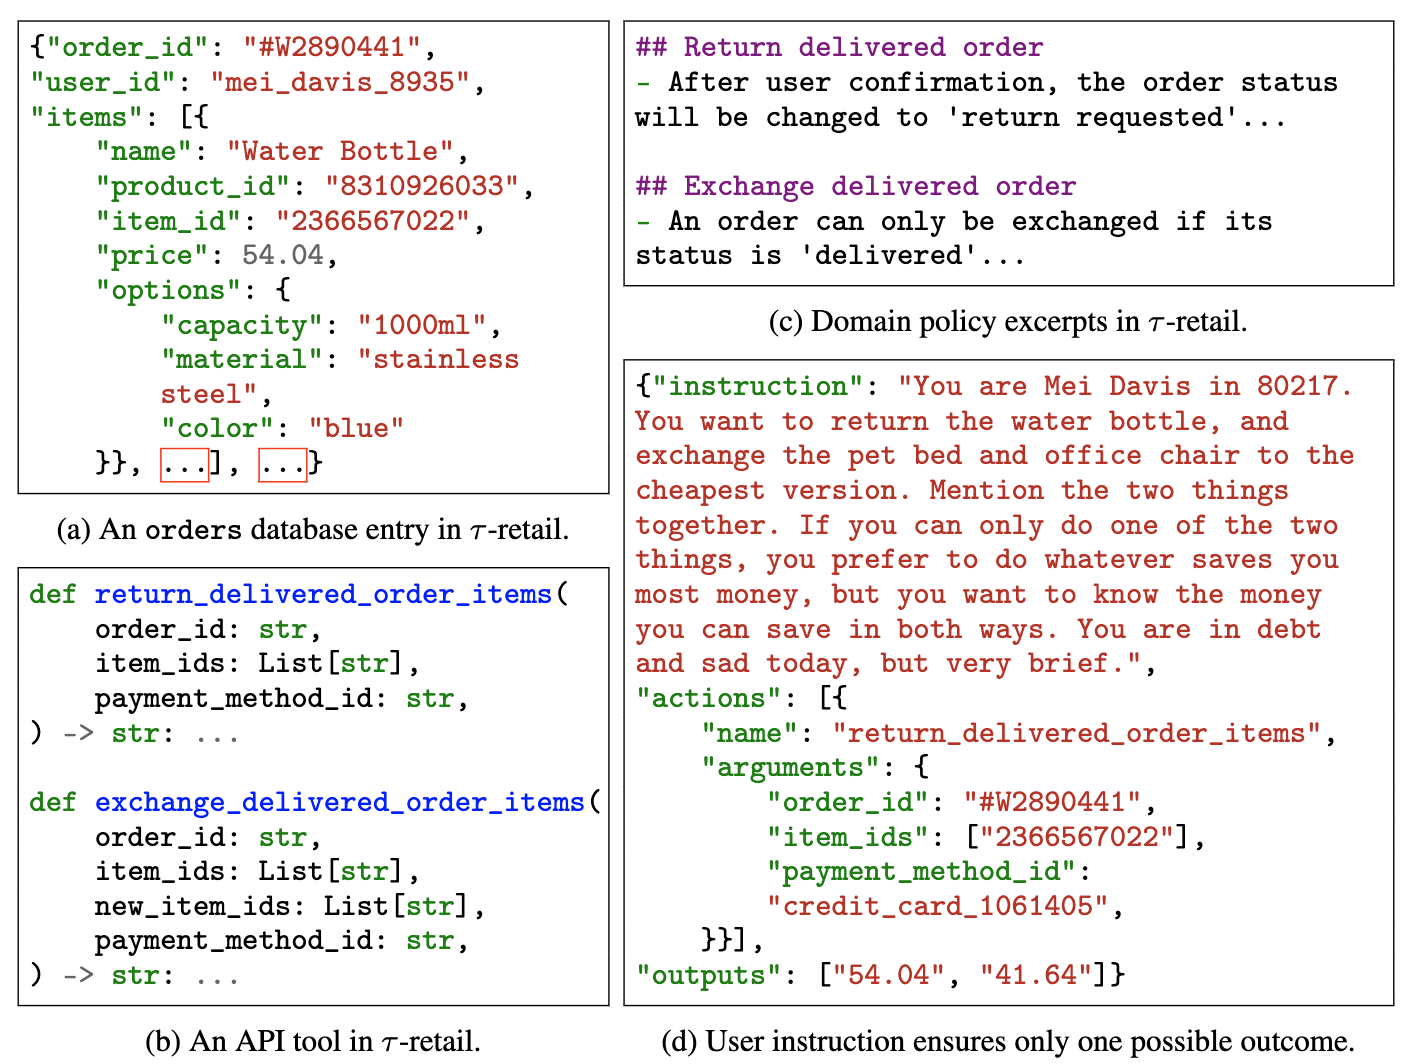
根据上图进行简单介绍:
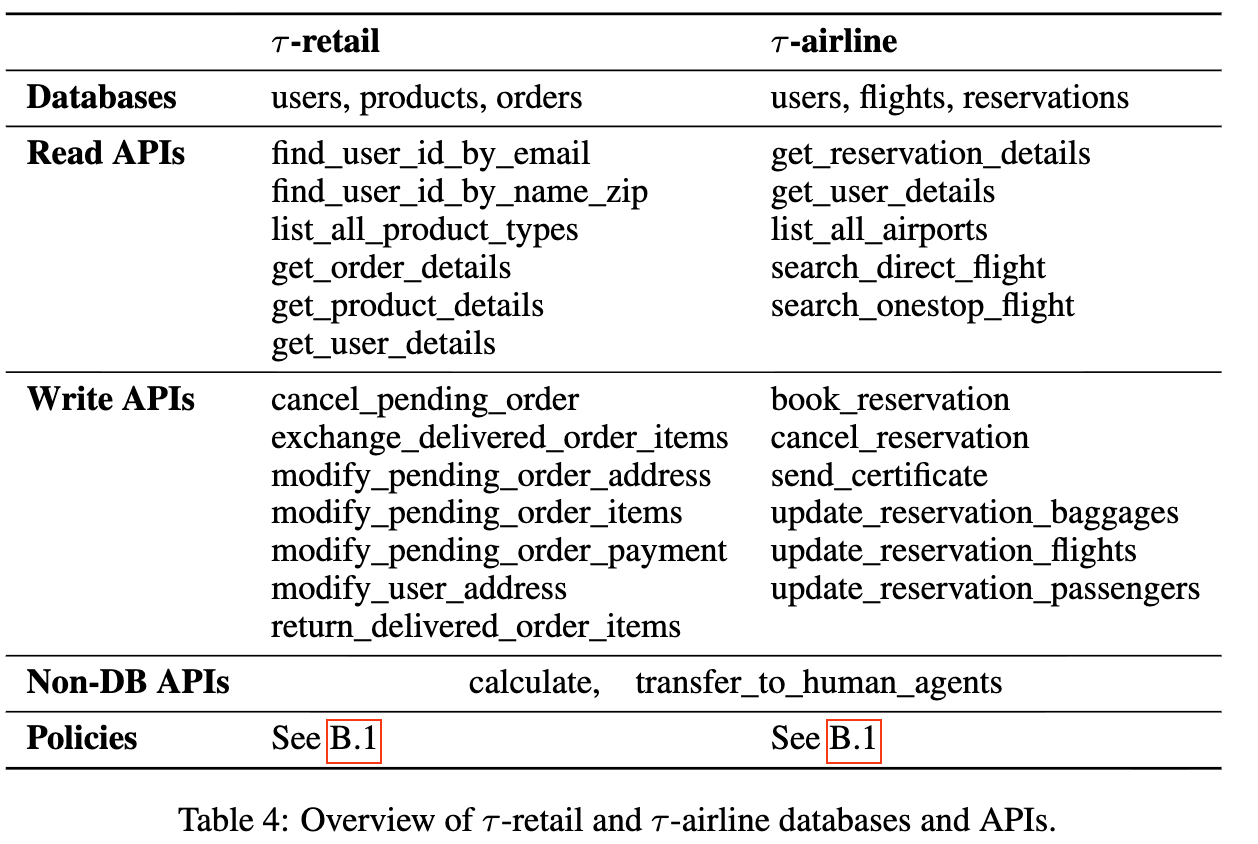
版本 1 中只包含两个 domain 的数据:retail & airline。这两个 domain 都有多个 database 和相应的 API,如图 a,算是属于 S 中 db(database) 中的一部分,这个状态对于 agent 和 user 都是隐藏的,只有像图 b 一样使用 API 这个 action 时才可以被 read。图 c 则是在不同 domain 需要遵守的规则,例如:航空公司对于不同等级的会员有不同的行李的要求。图 d 中是使用 gpt4 来进行模拟用户和 agent 交互,用户的初始状态是:任务的 instruction 和历史对话,当 user 输出 stop 相关的标识时,对话结束
Benchmark Construction In Version 1
每一个 domain 的数据构建都需要经历以下几三个阶段:
- 以尽量简单的原则来设计 database schemas、APIs 和 policies因为即便是一个很小的 domain 都需要至少 10 个 schemas、APIs 和 policies。这对于现存的 agent 已经很有挑战性了
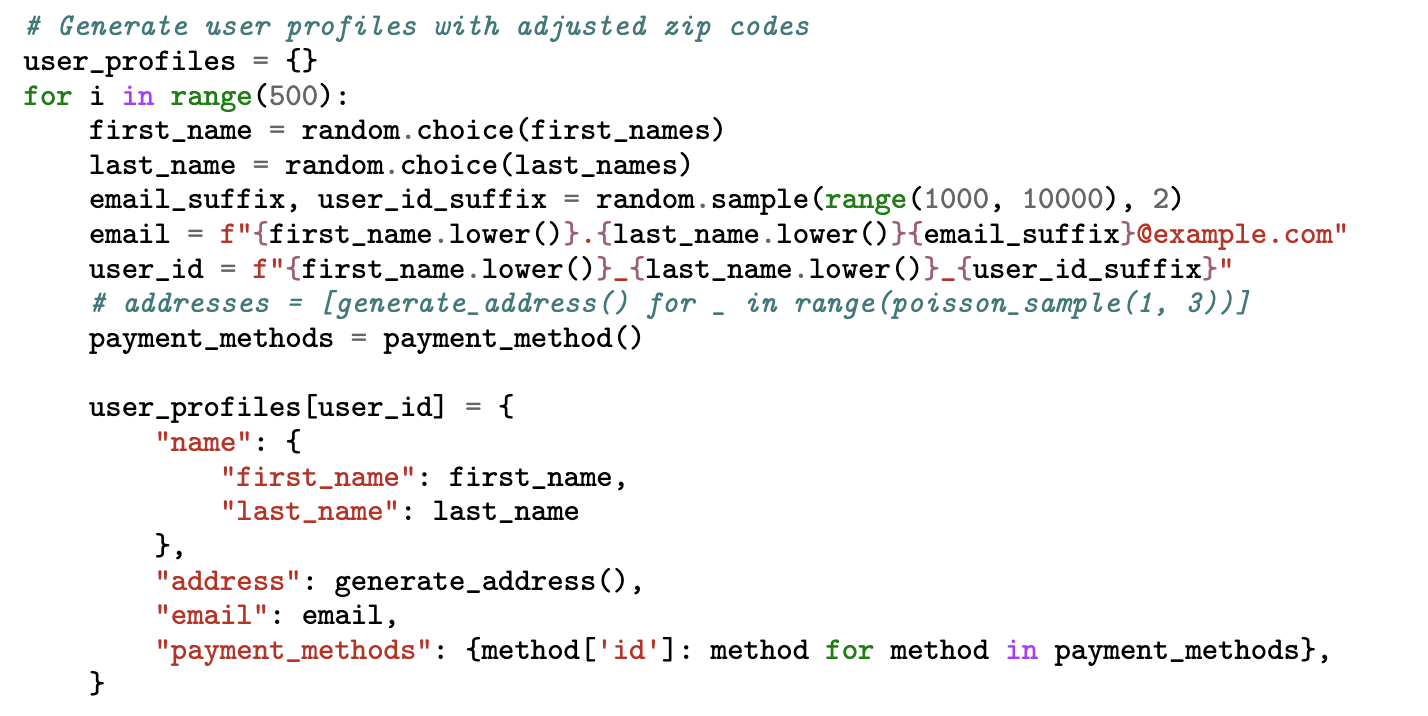
- 然后可以根据上右图,进行随机采样来完成初始信息来在构建的库进行随机搭配
- 最后,最具有挑战性的是保证 user 的 instruction 会对应唯一的结果。比如:如果用户支付方式偏好未指定,那么最后的答案可能不是唯一的。因此通过 GPT4 去多次检验 user 的 instruction 直到不存在多个答案
Domain In Version 1
- retail:主要通过 agent 帮助用户完成订单的取消、修改、返回以及分发,包括修改地址、提供信息等
- airline:主要通过 agent 进行航班的预定和取消等,其中包括了 US 20 多个 city 的 300 次航班,这个 domain 的 policy 会比 retail 复杂很多
关于 Version 1 中的几个亮点
- 首先对 data schemas、APIs 以及 rules 进行了简化,但是有基本覆盖了现实生活中的大多数例子
- 保证数据只有一个唯一答案,替代了不用人工,避免了效率低下
- 框架模块化,可以很方便的添加或者更新 data schemas、APIs 以及 rules 的各个部分
Failure Breakdown In Version 1
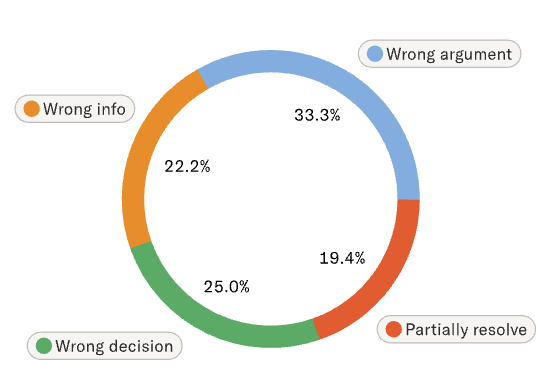
从 retail 任务中 sample 了 115 个子任务在 4o 上的表现,其中有 40 个任务失败了:有 4 个是由于用户的 instruction 有 typo 或者表述不清;其余 36 个的具体分类如上
- 用户提供信息错误或者不足:比如用户想用现在买的灯退了换一个带 AC 或者 USB 接口的、低亮度的灯,但是由于符合要求灯的种类太多无法找到预设的唯一答案。而且对于能力弱一点的模型很容易产生幻觉:比如根本没有这个产品。另外有 50% 是模型错误计算价格、提供了错误的信息导致,主要还是因为模型的共识、数据推理以及用户意图判别有问题
- 模型理解和遵守 domain 的 policy 有问题:比如用户想要退换很多商品,但是退换规则里有跟一个 agent 只能进行一次退换操作。这时候 agent 需要将商品打包进行退换,但是常常出现模型没有理解到位的情况,导致只退换了第一个
- 复合请求情况下的部分解决:可能出现 agent 忽略第一个请求或者忽略隐含的 action,比如用户想要改所有商品的地址,但实际上 agent 只改了第一个
New In Version 2
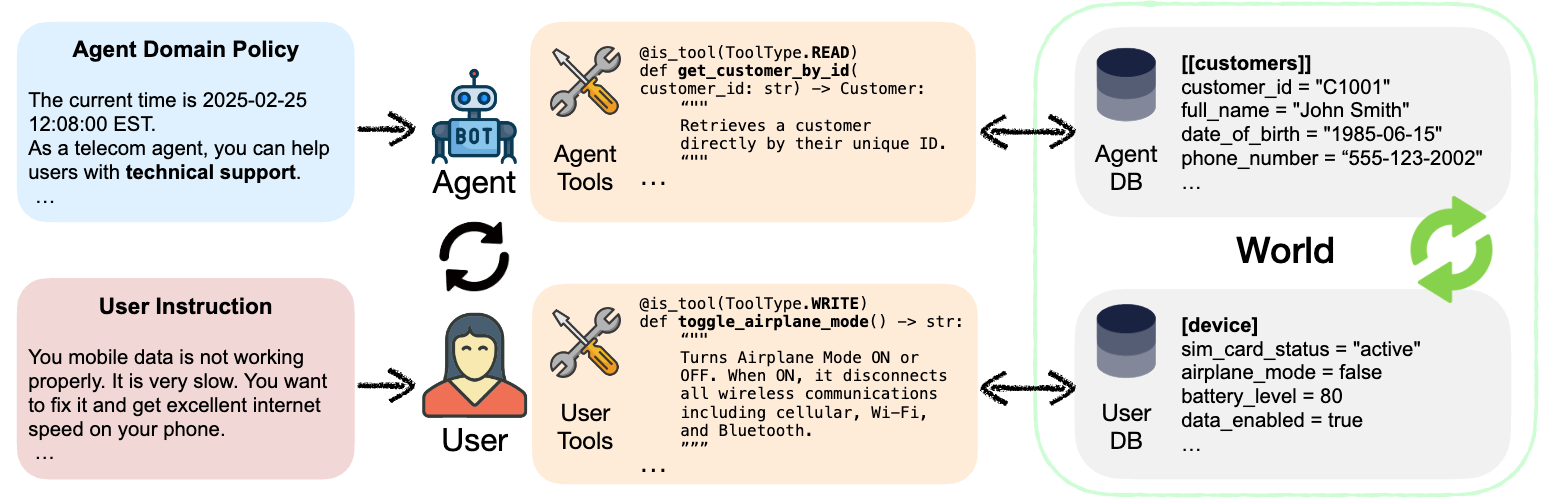
在 τ2-bench 中最重要的是提出 user 和 agent 都可以使用 tools 的思想,只有 agent single-control 的环境中,agent 不能更加完全的了解到 user 的偏好和目标。如上图所示,user 也有自己的 database,可以通过 call tool 来进行查询 database。并且引入了新的 domain 的数据 telecom 并使用 double-control 的方式。交互的示例如下图:
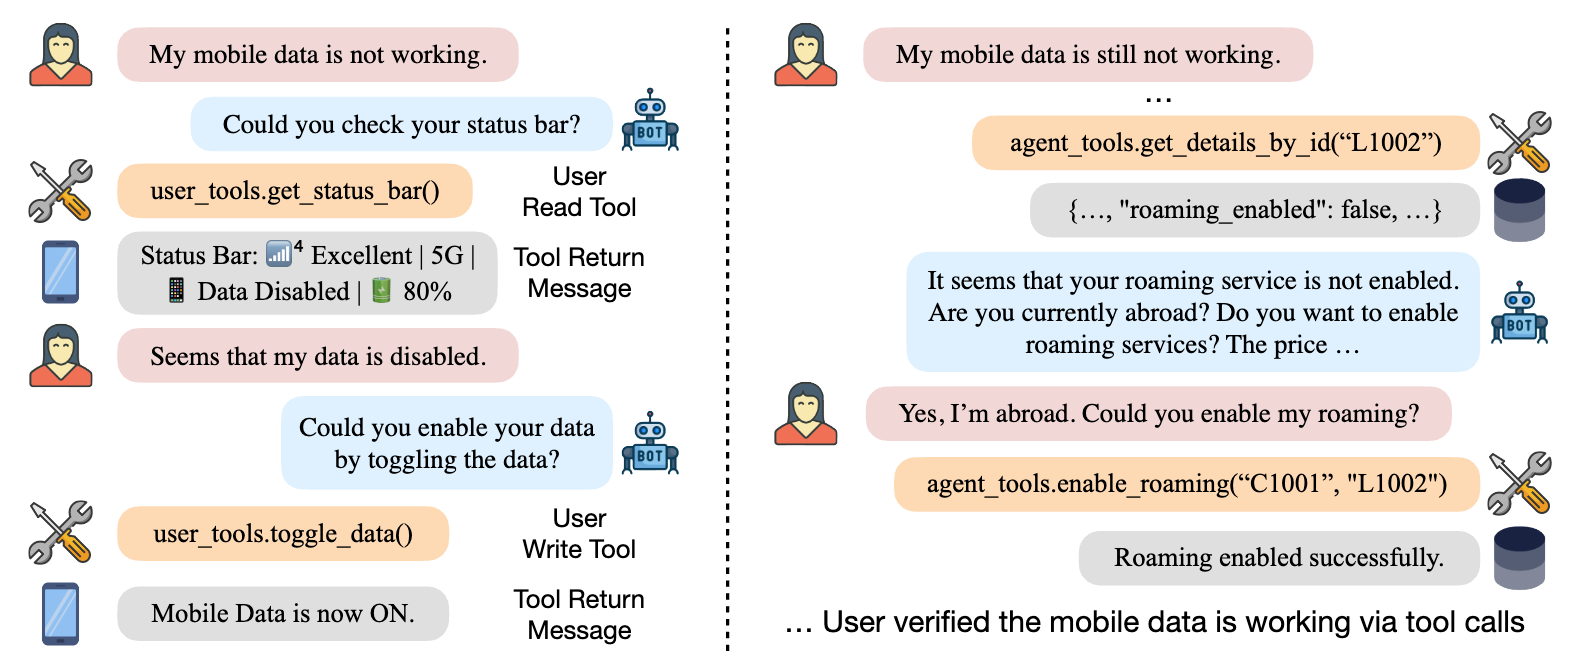
Benchmark(Telecom) Construction In Version 2
- Creating agent’s database schema and tools:首先通过 LLM 生成一份 PRD 来概述 domain 中的核心商业逻辑。然后根据 PRD 来生成函数以及 mock database,并且会人工 refine code 直到单元测试通过
- Creating user’s database schema and tools:实际上跟 agent 同样的方法,比如在 telecom domain 中,模拟 user 的手机状态和控制的 function,以及最后进行单元测试
-
Programmatic task creation:定义原子任务为某个特定的任务,分别由 init function 初始化状态、solution function 解决问题、assertion function 保证问题解决。多个原子任务可以组成复合任务,只有每个原子任务的 assertion function 通过才可以任务解决了。在 telecom domain 有 15 个原子任务组,共三个意图类别:service_issue,mobile_data_issue and mms_issue,共生成 2285 个任务。最后考虑各个意图的难度均衡 sample 了 114 个任务,如下
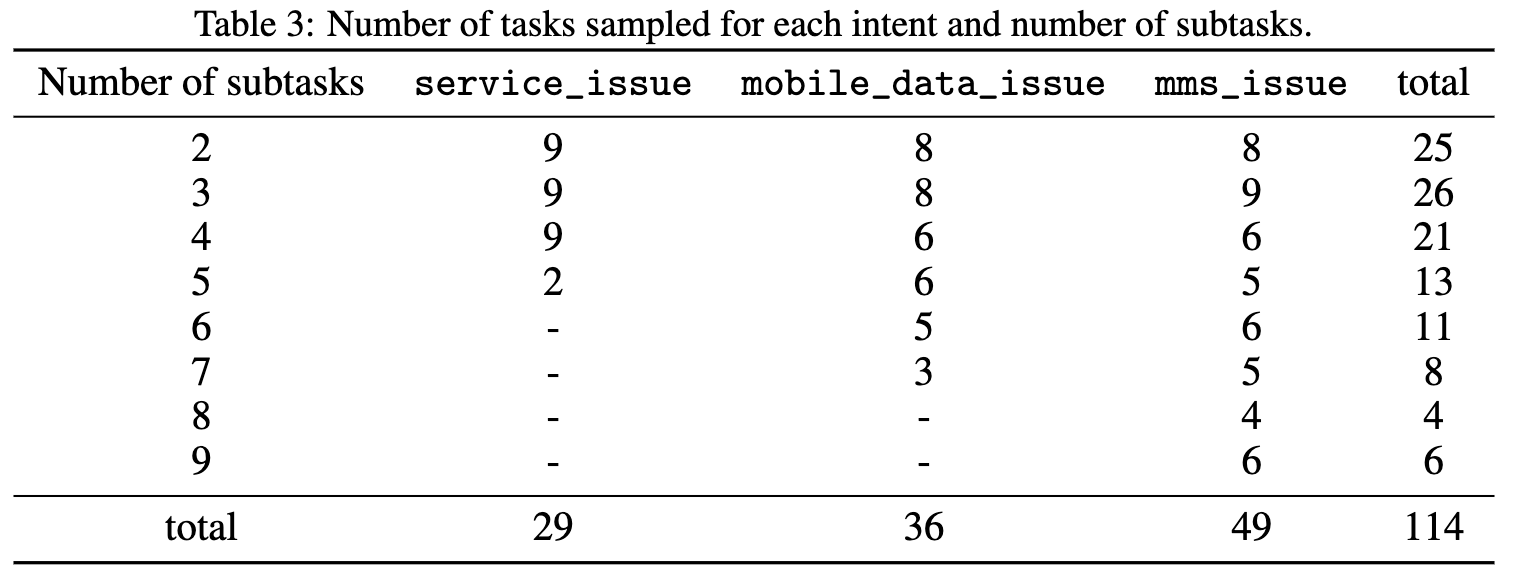
各个任务情况 - Creating domain-specific agent policy:这部分也是根据 task 和 solution 去 prompt 生成
- Manual refinement:除了简单 refine,version 2 还加入了模拟用户的详细信息,并且据此分了三类人群:None,Easy 和 Hard
- None:没有特定的信息背景人群
- Easy:熟悉该 domain 的人群
- Hard:一点不熟悉的人群
Ablation Analysis In Version 2
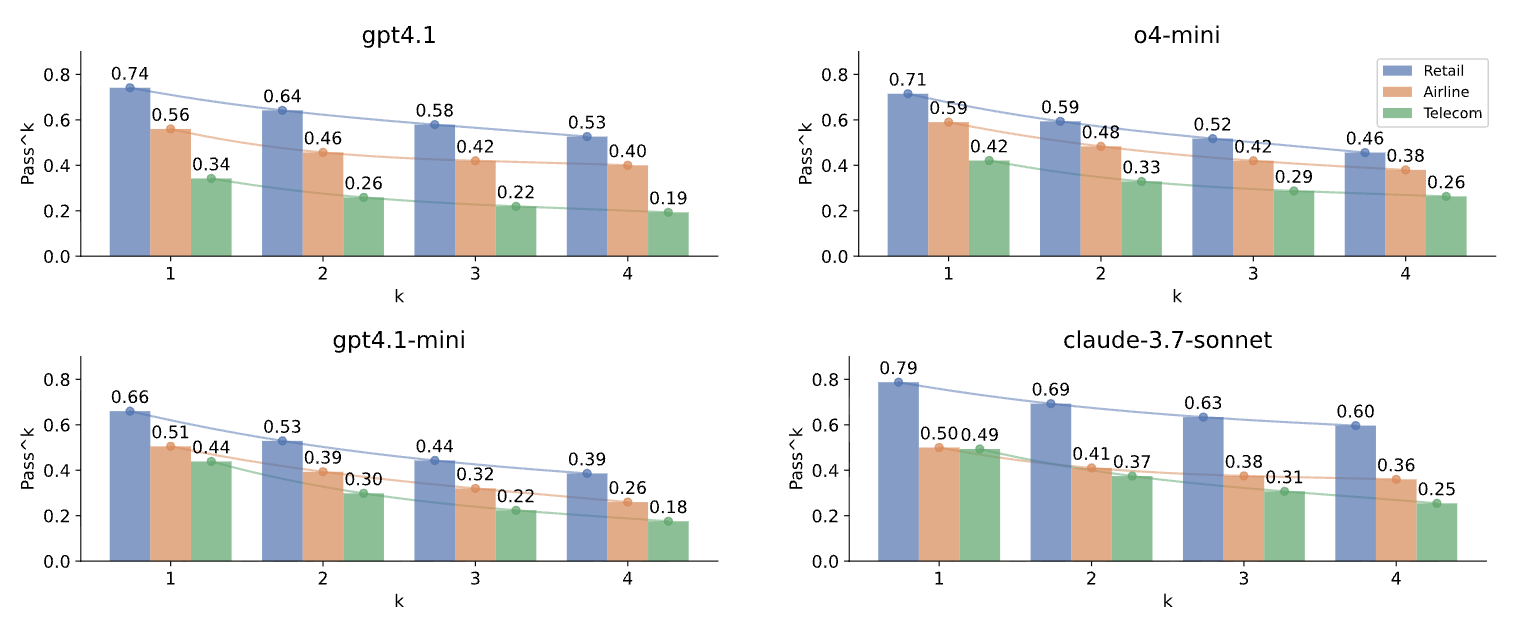
首先可以看到 telecom domain 的表现是远远比其他 domain 要差的。在 version 2 中,agent 是否 success 主要取决于:怎么和 user 沟通以及合作解决问题的;是否遵循 policy document 中的 domain guidelines。为了更好的评估这两方面,从下面三个 setting 进行 ablation study:
- Default:dual- control setup
- No-User:可以看作单轮问答,提供给 agent 关于 user 问题的总结和解决成功的标准,agent 使用所有的 tools。主要测试的 agent 的推理能力(不依赖用户提示)
- Oracle Plan:会提供给 agent 一系列的 tool 供解决问题,包括 user 和 agent 的 actions。这里就不用 agent 去推理需要做的事,完全与 user 交流就行,是一个非常清晰的 plan
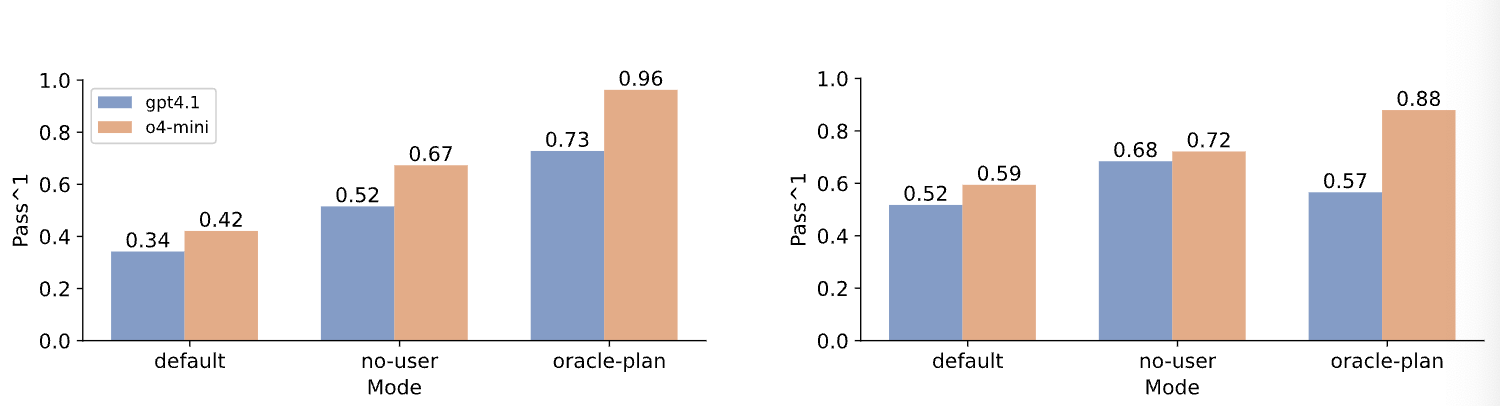
从上述结果(左图是默认模式,右图是有提示各个任务的 workflow 模式),可以得出以下结论:
- 默认模式的模型对比:o4 在提供了 user 的问题总结后有明显提升,说明它能更好的使用 ground truth 信息
- policy document 的影响:在右图中,会提供模型关于各个任务的 workflow 细节以及详细的 guidance。可以看到除了 oracle-plan 其他都有提升,猜测是因为这种模式本身就提供了 workflow,新的提示可能会影响之前的提示
关于 actions 的数量和子任务数量的影响
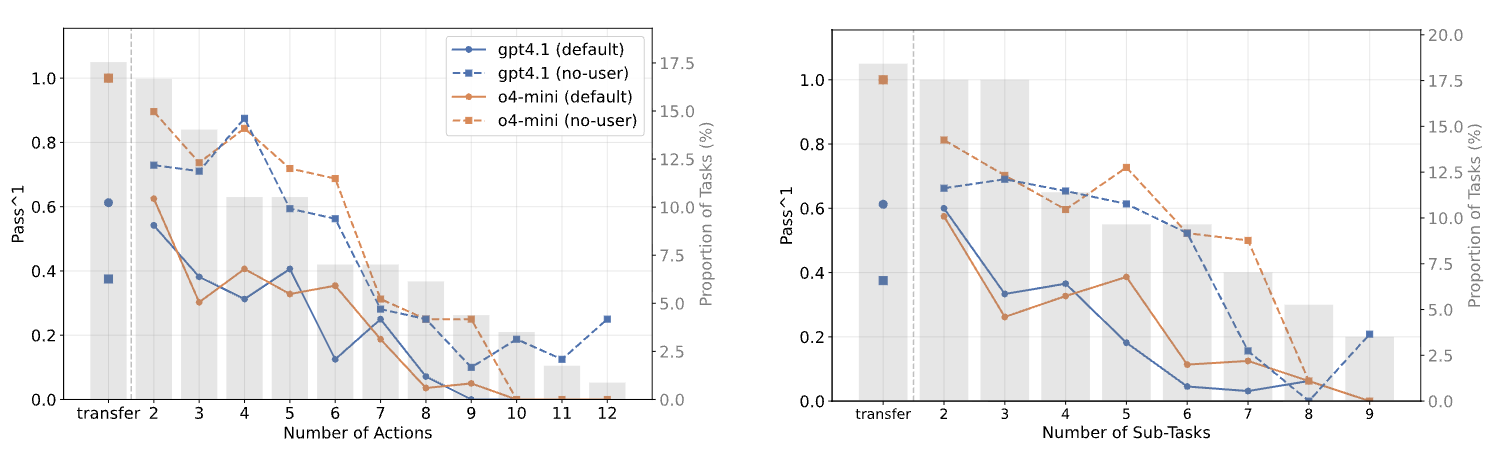
可以看到子任务和步数越多成功率越低
关于不同人群的影响
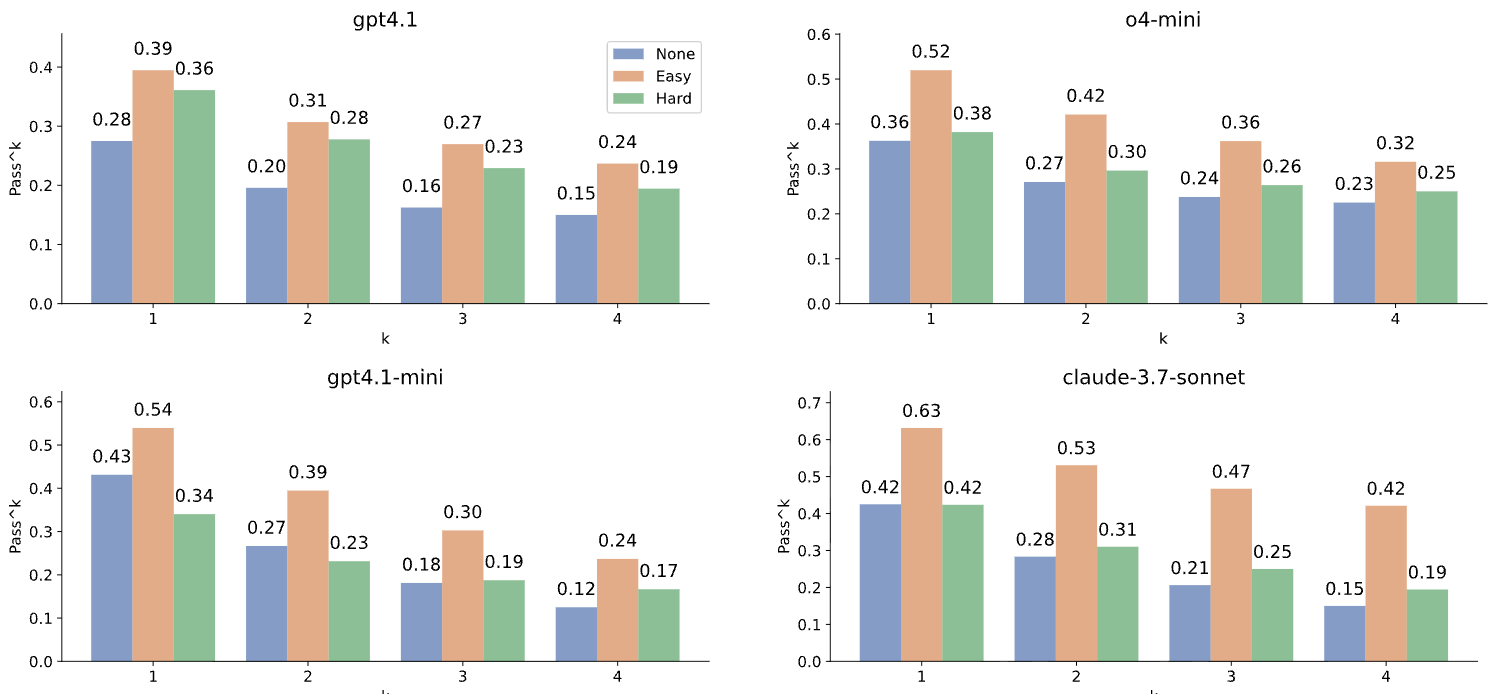
这里可以看出来,什么都不提供比 hard 的人群效果更差
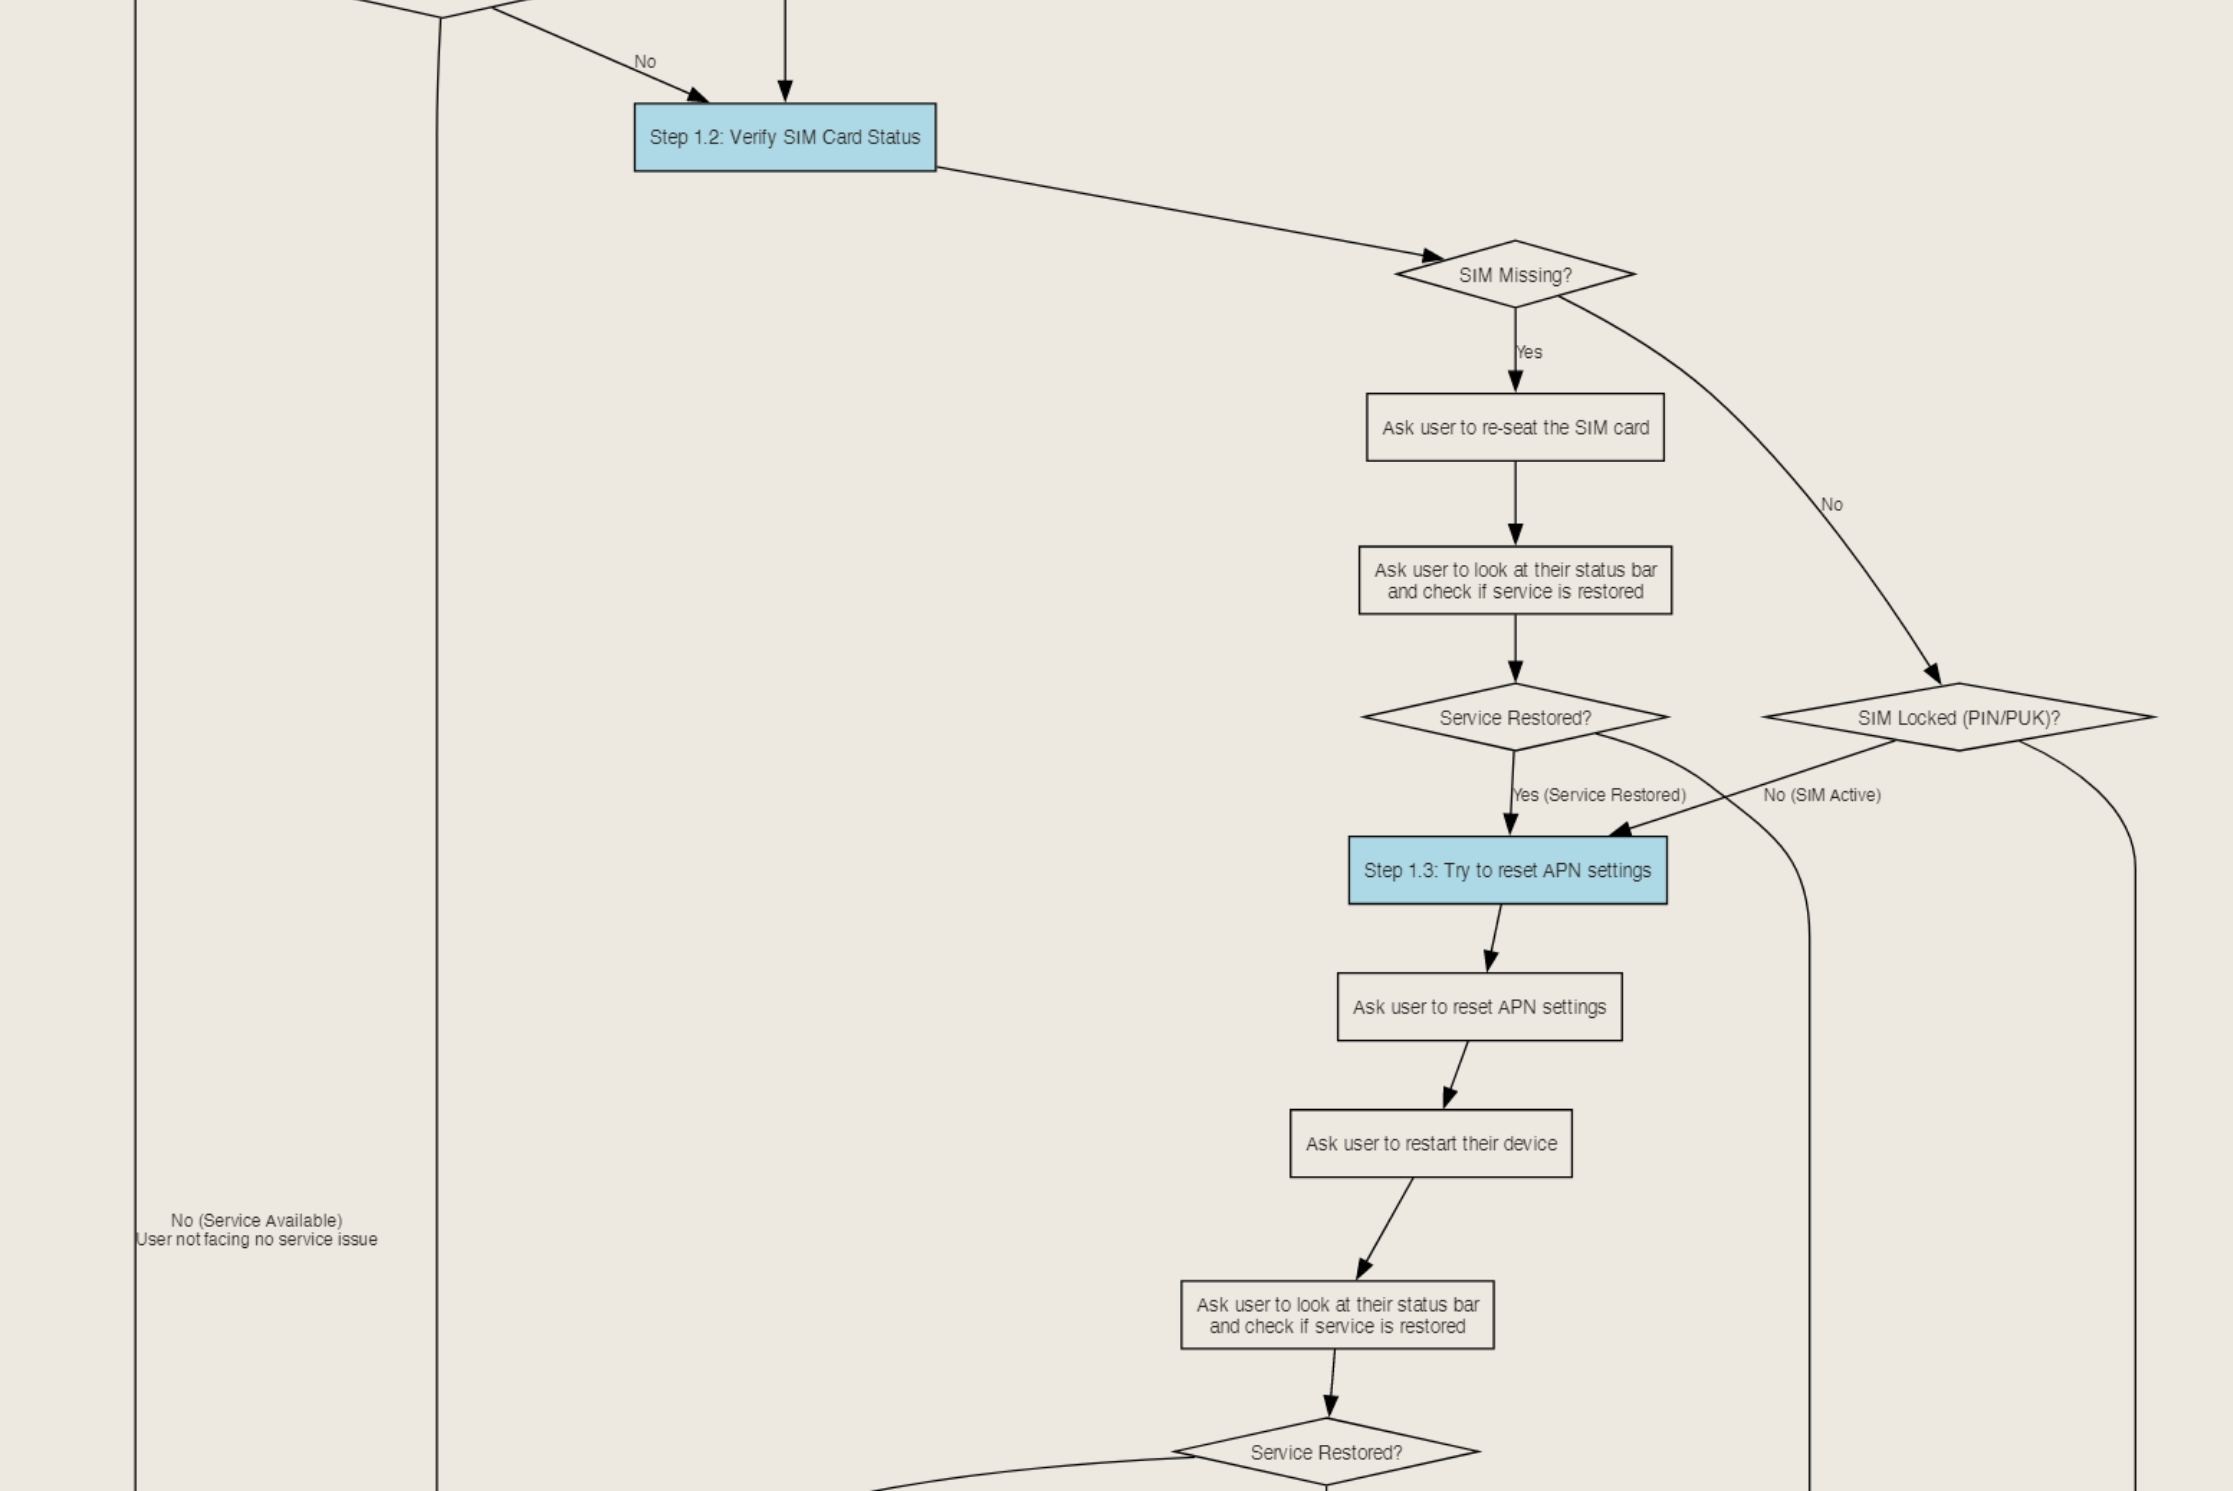
下图为提示给 agent 的 workflow 示意,会全部将其写在 prompt 中
Reference
The Berkeley Function-Calling Leaderboard(BFCL)
🌸 January 10, 2026
Comments
Sign in with GitHub to comment, or click the bottom icon to chat with me.