GLM-4.6V
这篇 blog 主要还是从数据上进行解析 GLM-4.6V,结构和训练方面只进行简单提及
Structure
首先 4.6V 还是采用的 VIT+MLP+LLM 的结构,VIT 使用的 AIMv2-Huge 作为的 Pretrain,关于这部分我们不深入进行介绍了。4.6V 对 rope 进行了一些 norm 方面的改造,总体上跟 QwenVL 系列思路一致。LLM 则使用的 GLM-4.5,相关训练细节会在后面介绍
Data
Pre-Training
Image caption data
图像文本对在预训练中尤为重要,最初的收集数据源来自:LAION, DataComp, DFN 和 Wukong 等以及互联网,共 100 亿条。通过以下 pipline 进行筛选:
- Heuristic-based filtering:主要是一些规则为主的过滤方式,包括 minimum image resolution, solid color detection, caption length constraints 以及 image-level deduplication
- Relevance filtering:使用 CLIP 检验图片文本相关性,只有阈值大于 0.3 的 pairs 会被留下
- Concept-balanced resampling:通过使用 MetaCLIP 重采样的办法来缓解长尾分布
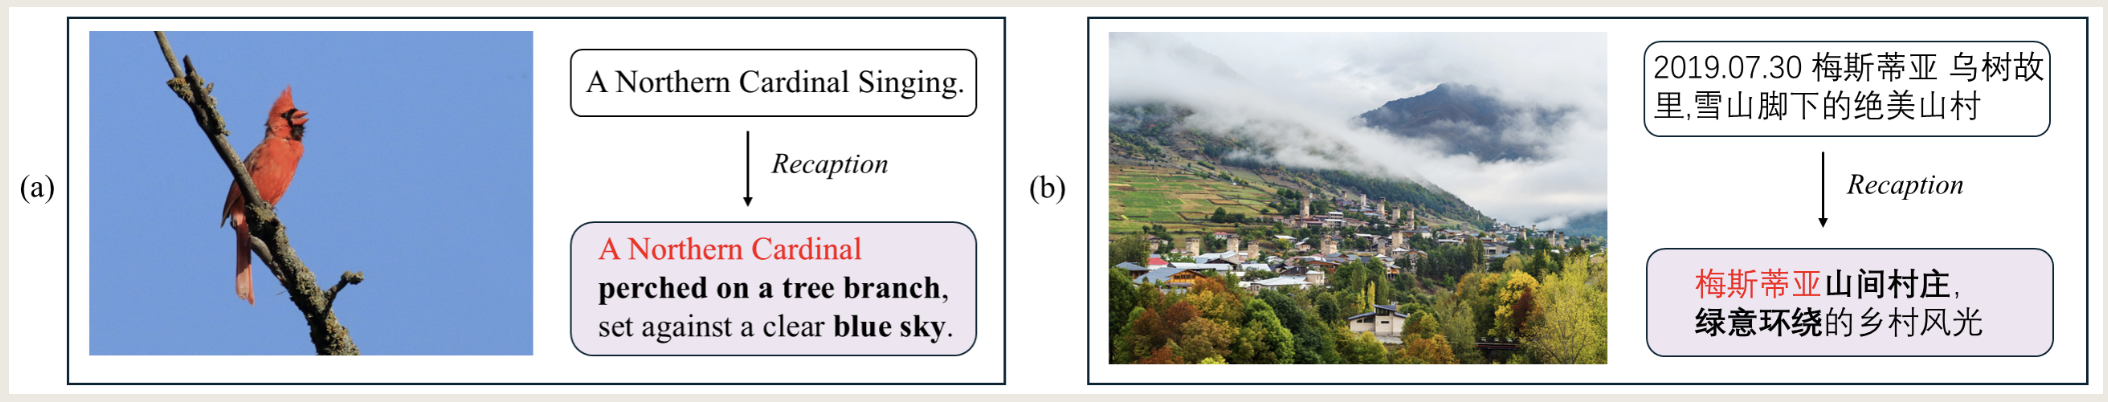
- Factual-centered recaptioning:通过一个训练的 recaption 的 model 来对 caption 进行事实纠正,文本丰富recaption model 的数据和训练怎么来的?
Interleaved image-text data
这类数据常出现于 Web 页面和书籍中,它的问题在于:量非常大,但是噪音也非常大,信息分布不均匀。并且之前的工作很少利用这类数据来提升视觉-语言能力,特别是用来帮助模型适应多图片类型中的图文交错布局的形式。文中通过以下 pipline 解决:
- Web data processing pipeline:首先从开源数据集 MINT, MMC4 和 OmniCorpus 出发;使用 CLIP 去除图文不符的数据;结合规则和分类模型对二维码之类噪音严重的图片进行去除和以图片为主的相册;最后通过训练高信息密度分类器高信息密度分类器没有详细介绍 来筛选出信息密度高的数据,如 academic charts, scientific illustrations, engineering schematics, instructional diagrams 和 maps 等。而不是主要以图片为主的相册
- Academic book processing pipeline:弄了 1 亿本电子书,先通过是否是 science, technology, engineering, and mathematics (STEM) 相关进行筛选,其次再使用 PDF 解析工具进行解析
OCR data
这部分数据一共有 2.2 亿条,主要分为:
- Synthetic document images:使用不同的字体、字号、颜色以及朝向对 LLM 预料库进行在 LAION 数据集中图片为背景上渲染
- Natural scene text images:使用 PaddleOCR 对现实生活中的图片进行提取,并保留至少有一个文本提取结果
- Academic documents:和 Nougat 类似通过 LaTeXML 工具将 arXiv 的 LaTeX source code 转化为 HTML,再转换为轻量级标记语言(Markdown 之类的)。最后变为可以训练的 PDF 数据
Grounding data
这部分数据主要用来提高模型的视觉定位能力,主要分为两部分数据:
- Natural image grounding:以 Natural image grounding 为基础,使用 GLIPv2 通过解析 caption 中的名词并且得到图中的 bounding box。最后仅保留至少有两个有效 box 的图片,一共 4000万条数据
- GUI grounding:对于 GUI 领域,本文是从 0 构造的。从 CommonCrawl一个非营利项目/开放数据集,长期在互联网上大规模抓取网页内容,并把抓到的原始数据免费开放给公众使用 上最近的快照中提取 URLs。使用 Playwright framework 跟网页进行交互,从而获得 visible DOM elements 精确的 boxes,这部分数据一共有 1.4 亿条
Video data
主要使用人工标注和 embedding based 去重的方式,同时去除了一些无效的视频文件
Instruction tuning data
为了增强模型的泛化性和通用能力,增加了以下数据:
- Task coverage and taxonomy:设计了一套更细粒度的分类体系(taxonomy),用来优化数据采样,从而扩展并提升模型对世界知识的覆盖范围。这使得我们可以根据语义结构、任务目标、一些类别特定的前处理和均衡采样策略来组织 prompts
- Complex scenario augmentation:为了处理与公开数据集的 gap,使用复杂的合成规则来进行约束生成数据
- Data contamination check:为防止从公开的评测基准(benchmark)中发生数据泄露例如把测试集内容混入训练数据 ,我们对所有开源数据集都进行了人工审核和自动化审查
Supervised Fine-Tuning
文中指出与之前的工作不同,其将 SFT 当作模型使用高效的思考和回答的风格来对齐已经在 pretraining 视觉-语言的理解。其在 SFT 阶段生成了一个 long CoT 的数据集来训练模型多步解决问题的能力,也使得 RL 更加稳定和可扩展
Data composition
这个数据集包含各个 Domain 里面可验证和开放式答案的数据,主要以数学和英语为主以及一部分其他语种。并使用 pretrain 阶段的模型进行数据筛选,去除过难和过简单的数据没有提及怎么进行筛选的
Response formatting
每个 response 都遵循格式:<think> {think_content} </think> <answer> {answer_content} </answer> ,其中 <think> 包裹的是推理的内容,reflection 和 backtracking。<answer> 很明显就是答案,但对于可验证的答案,需要被包裹在 <|begin_of_box|> 和 <|end_of_box|> 之中
Response curation
对于 poorly constructed data 容易导致训练不稳定和崩塌。文中设计了严格的清洗 pipeline(没详细提及),使得上述格式能够严格执行以及去除了语言混合、重复思考的数据
Iterative data enhancement
从 RL 训练的 checkpoint 中 sample 高质量的 Cold Start 数据。实现 RL 阶段对 SFT 阶段的反哺
Reinforcement Learning
主要分为几个阶段来构造数据
Task identification
定义了一系列 VLM 中各个 Domain 中各个任务可验证的形式,比如 video caption 的答案是开放的,但是对于每一帧的 grounding 是清晰的答案
Data curation
过滤和生成问题答案对,使得其可以进行用验证器进行高精度的验证其回答是否正确。另外对于多个选择的答案,会将其转换为一个唯一答案(没有讲怎么做)以减少噪声
Quality validation and offline difficulty grading
使用现有的 RL model 来进行正确性的检查以及 passk 的 evaluation,再结合人工标注进行难度等级的分类
Pilot RL experiments
进行初步的 RL 实验来确认各个领域数据质量和模型在该领域的潜在 performance
Training
简单对训练超参数和一些 trick 进行介绍
Multimodal Pre-Training Recipe
TP: 2
EP: 8
PP: 4
# balanced expert utilization
router-bias-update-rate: 1e-3
auxiliary-sequence-level-balance-loss-with-a-coefficient: 1e-4
sequence-length: 8192
global_bs: 1536
steps: 120000
Long-context continual Training Recipe
TP: 2
EP: 8
PP: 4
CP: 4
# balanced expert utilization
router-bias-update-rate: 1e-3
auxiliary-sequence-level-balance-loss-with-a-coefficient: 1e-4
sequence-length: 32768
global_bs: 1536
steps: 10000
Supervised Fine-Tuning Training Recipe
Global batch size 为 32,其余和上述基本一致。其中包括的数据有:多模态数据、数学问题解答、多轮对话、agent planning 和指令遵循。其中一个发现是:对于 cold start 数据里即便有噪声数据(格式不一致 or 重复 patten)依然不影响后续 RL 训练的效率。当然更干净的数据肯定对于 RL 的训练更有帮助。文中对于 thinking 和 non-thinking data 都进行了训练,使用 /nothink 来进行开关
Reinforcement Learning
Reward System
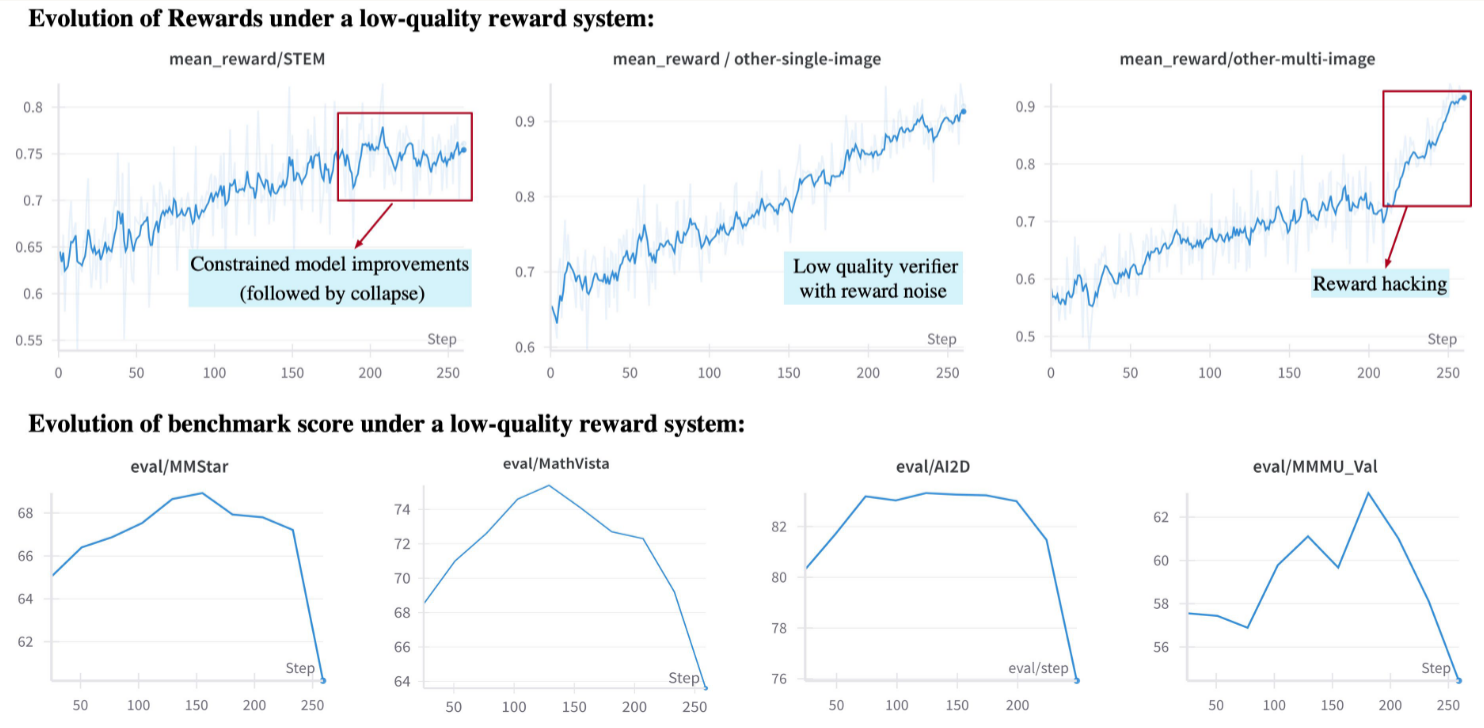
设计了一个对 RLVR 和 RLHF 都可用的系统。对于 RLVR 来说,高精度的 reward 是 outstanding 结果的重要原因。虽然有些研究表明随机或者有噪声的 reward 有时候会让model 往着有效的输出 pattern 走,但事实上当在多个领域训练模型的时候,任何一个领域中的 reward 出现偏差都能 derail 整个训练注意这点和 SFT 是不同的 。如下图所示,在 multi-image 中出现了 reward hacking,大概 200 step 的时候其他领域(下方的四个图)出现了 collapse
The extraction of the final answer
对于 RLVR 的答案提取往往有两种方式:规则提取(根据 box markers)和 LLM 提取。文中发现 LLM 对于简单的学术问题(比如一个数字)或者单类任务来说,设计 prompt 进行提取很容易。但是在多模态领域答案可能千奇百怪,这时候 LLM-based 的方法就显得不太准确了,为了解决整个问题,专门设计了 box tokens 来将答案进行包裹便于提取,即:<|begin_of_box|>{FINAL_ANSWER}<|end_of_box|> (有了这个,是不是直接 rule-based 就行了)
Domain-specific reward system
特定领域的 reward 需要不同的设计,比如 “43” 和 “43.0” 在数学领域是相等的,但是对于 ocr 来说就是不同的,文中设计的 domain-specific reward system 有以下特点:
- Shared verification functions:对于有些公用的 check 则可以共用,比如什么 box 内容的提取
- Domain-specific modules:对于每个领域有自己模块来进行特殊的支持,比如 branching workflows, functional evaluations, and model-based judgments driven
- Unit testing:使用单元测试来对齐 domain 的输出分布以及迭代 reward logic
最后 reward system 还有 format check 以及 style check
Reinforcement Learning with Curriculum Sampling (RLCS)
主要是考虑到在 200 step 后出现大量 accuracy 达到 90% 的情况,这时候该 batch 对训练是作用不大的,但是时间消耗又主要在 rollout 阶段。因此设计了 RLCS,首先进行了 online 和 offline 的难度测验,通过现有 VLM 对整个数据集进行 pass@k 的测试并且综合人工的难度标注,从而获得从非常容易到非常难的多个难度标注等级。online 和 offline(人工)的对比,也可以实时反应模型当前的能力。根据模型的 performance 进行 reweight the ratio of sample,主要的目的是增加中等难度的数据
Improving Effectiveness
在 RL 阶段使用以下 tricks
- Larger batch size:相对大的 batch size 有更高的天花板
- Dynamic sampling expansion via ratio EMA:还是针对全对或者全错的情况,使用参数
expansion_ratio = 1/(1 − not_valid_sample_rate)来判断额外 rollout 的比例(其中not_valid_sample_rate是上一个 iteration 中无效 samples 的比例),并使用了 EMA 来进行计算 - Force answering:主要对于思考过长导致被截断的情况,最终没有答案输出,reward 为 0。使用
</think>进行强制截断,进入输出答案环节这里是根据长度判断强制阶段位置?那需要留多少 token 来给 answer 呢 - Discard KL loss & Clip-higher:这俩其实挺常见的了,在 DAPO 中
其他发现:
-
高分数的 cold-start SFT 不会影响 RL 中的表现,RL 进行合适的调整,即便在不同的 cold-start 上也能获取一样的分数(这里好像和 SFT 说的不太一致?)
Nonetheless, models initialized with clean and consistent data show more stable RL convergence and achieve higher overall performance
-
在与强化学习训练领域正交的未训练或训练不足的领域上的表现可以保持得相当好。此外,经常会观察到跨领域的泛化,即在一个领域的改进可以转移到其他领域
Improving Stability
关于 RL 的训练稳定性
- The quality of cold-start SFT data:尽量不要有大量无意义的思考
- using
top-p = 1instead of a smaller value produces more stable RL training,主要是覆盖了更全面的词表,会使模型输出更清晰的表达 - per sample loss 和 per token loss 在 mean reward 没有差异,但是 per sample 更稳定
- 虽然 format-based rewards 可以帮助模型输出更稳定的结构,但是依然更建议在 cold-start 阶段学习完所有的输出格式而不是依赖 RL
GLM-4.5
这部分主要对 GLM-4.5 后训练相关的内容进行详细的介绍
Supervised Fine-Tuning
这一部分由两个 stage 组成: Expert Training 和 Unified Training。第一部分主要包含 cold start 为后面的 RL 做准备;第二部分则是蒸馏不同 expert models 的能力到一个 hybrid 的用于解决不同类型的任务。下面仅介绍 GLM-4.5 中一些特殊处理:
Reducing Character Escaping in Function Call Templates
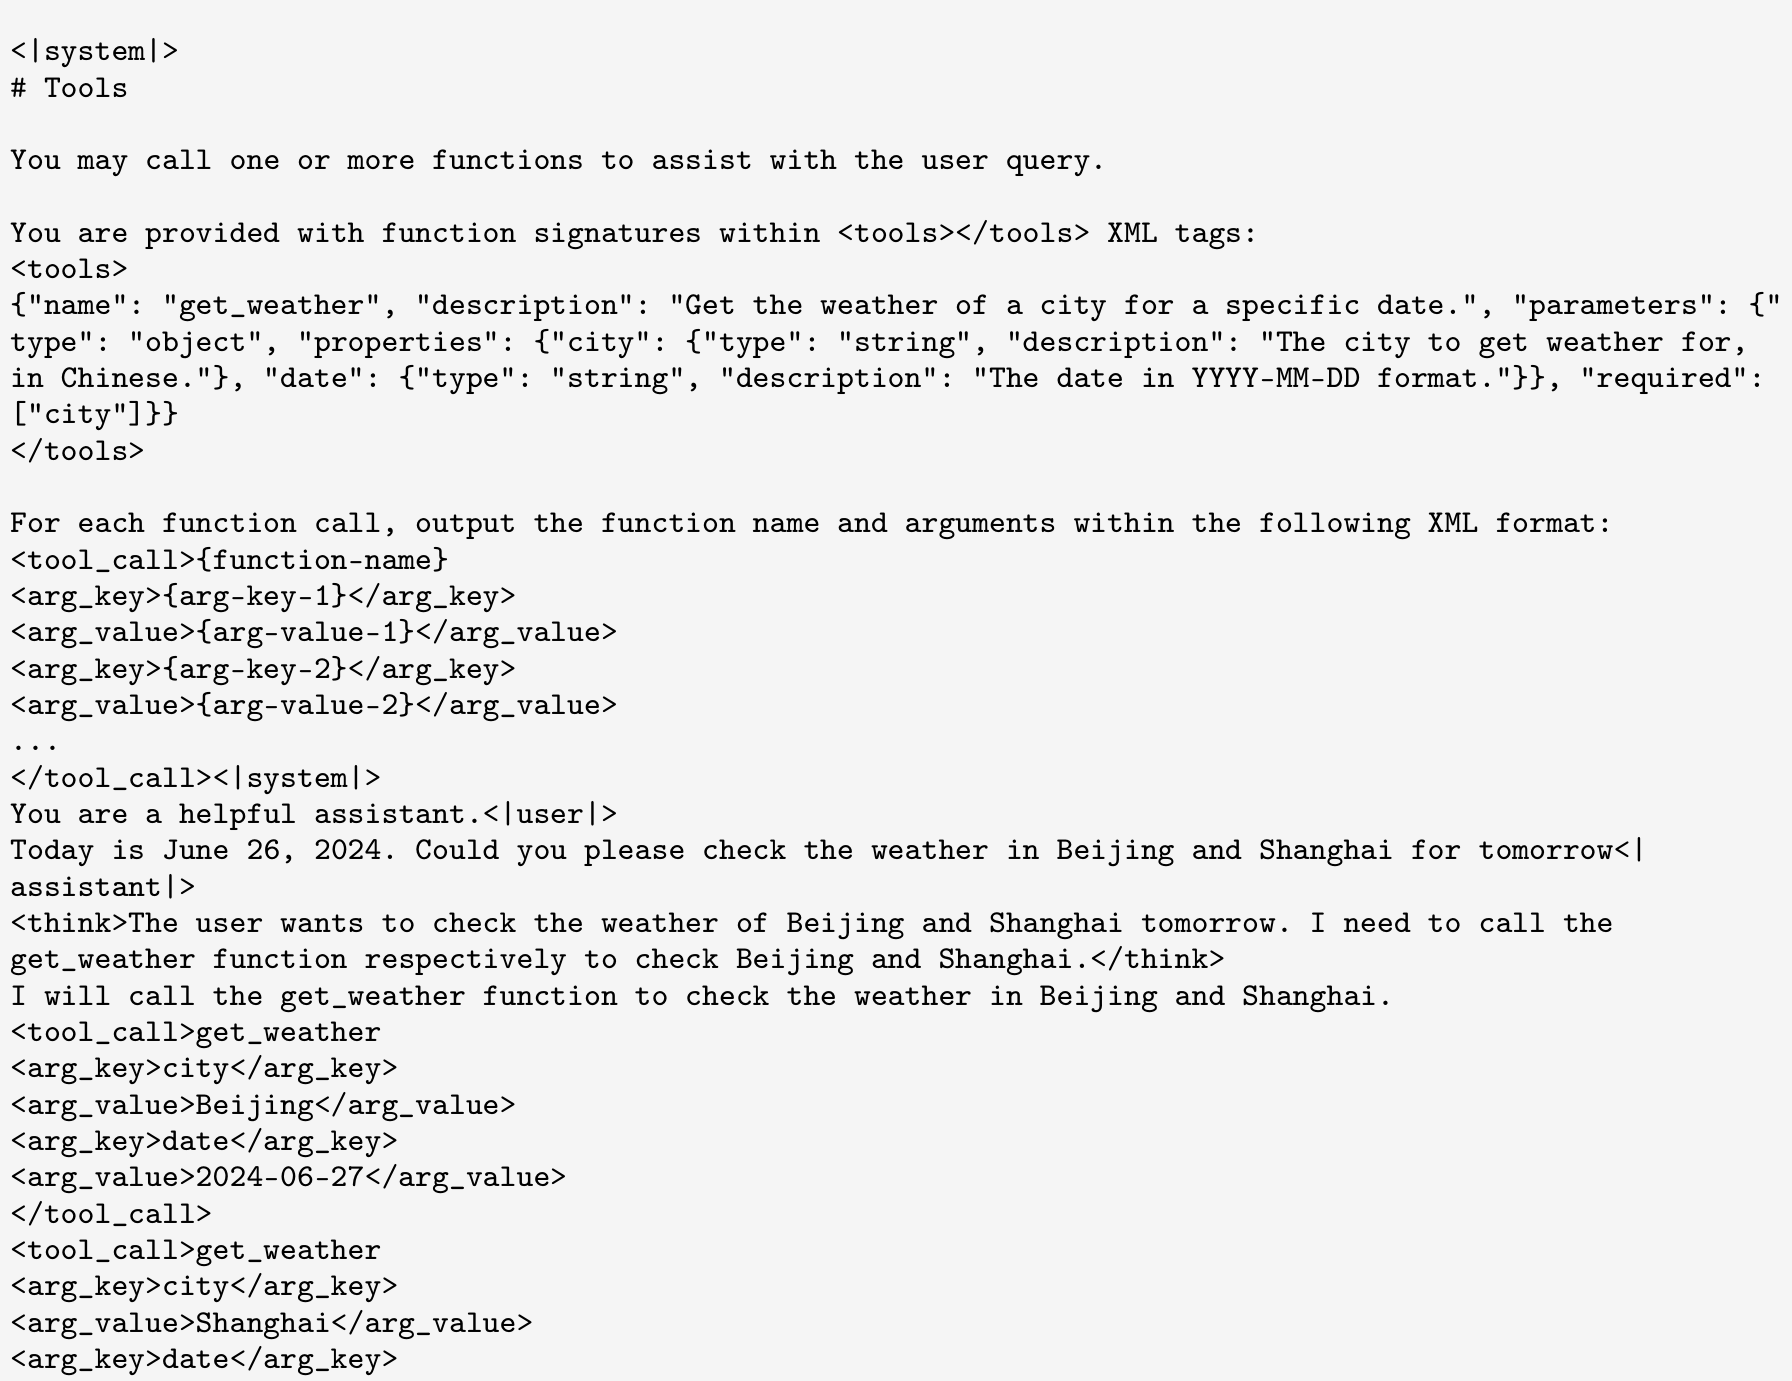
对于 Function Call 而言,在调用工具的时候,目前常用的是 json 格式的。但是这可能需要大量的转义,会给模型学习带来负担。GLM-4.5 则使用 xml 类似的格式,用了一些 special token 将需要调用的函数和参数进行包裹
Rejection Sampling
从不同 expert model 蒸馏的数据,其 filtering rules 如下
- 去除重复、过短或者截断以及无效推理格式的数据
- 对于客观答案进行校验
- 用 reward model 筛选主观答案的问题
- 对于 tool-calling 确保遵守适当的工具调用协议,并验证轨迹是否达到预期的终端状态
Prompt Selection and Response-Level Scaling
- 对于数学和科学问题去除 prompt 底部的 50% 会带来 2 到 4 个点的提升
- 对于 hard prompt,每个 prompt 生成 4 个回答会带来 1 到 2 个点的提升
对于第一点不是很明白为什么去除一部分 prompt 会带来提升,是因为太长了影响到了吗?
Automatic Agentic SFT Data Construction
对于 agentic SFT data 构建主要分为 4 步:
- Agentic Framework and Tool Collection:使用现有的 agentic 框架以及现实世界的 tool APIs 和 MCP 服务结合 LLMs 构建和模拟 tools
- Task Synthesis:对于成熟的 agentic 框架,使用 LLMs 理解 tools 后自动生成相关的任务问题以及子任务问题;对于分散的 tools,则是选择具有代表性的 subset 来用 LLM 生成。这里包含了单步和多步工具调用
- Trajectory Generation:对于每一个合成的任务,使用 LLM 来生成一个 tool-call 的使用轨迹。并使用 LLM 当作 user 将所有的多步调用并入到多轮对话当中
- Quality Filtering:使用多个 judge agents 来判断任务是否完成
Reinforcement Learning
Reasoning RL
这部分主要对模型的逻辑推理、结构化问题的解决以及可验证精度进行增强。主要由 mathematics, code generation 和 scientific reasoning 组成,关于这部分文中做了一下优化:
-
Difficulty-based Curriculum Learning:主要还是针对静态的数据无法满足 model 能力不断增长的需求。文中使用两阶段基于难度的课程学习方式对于极难数据的定义:
pass@8 = 0 & pass@512 > 0,两阶段的方式可以使得模型在后期提点更多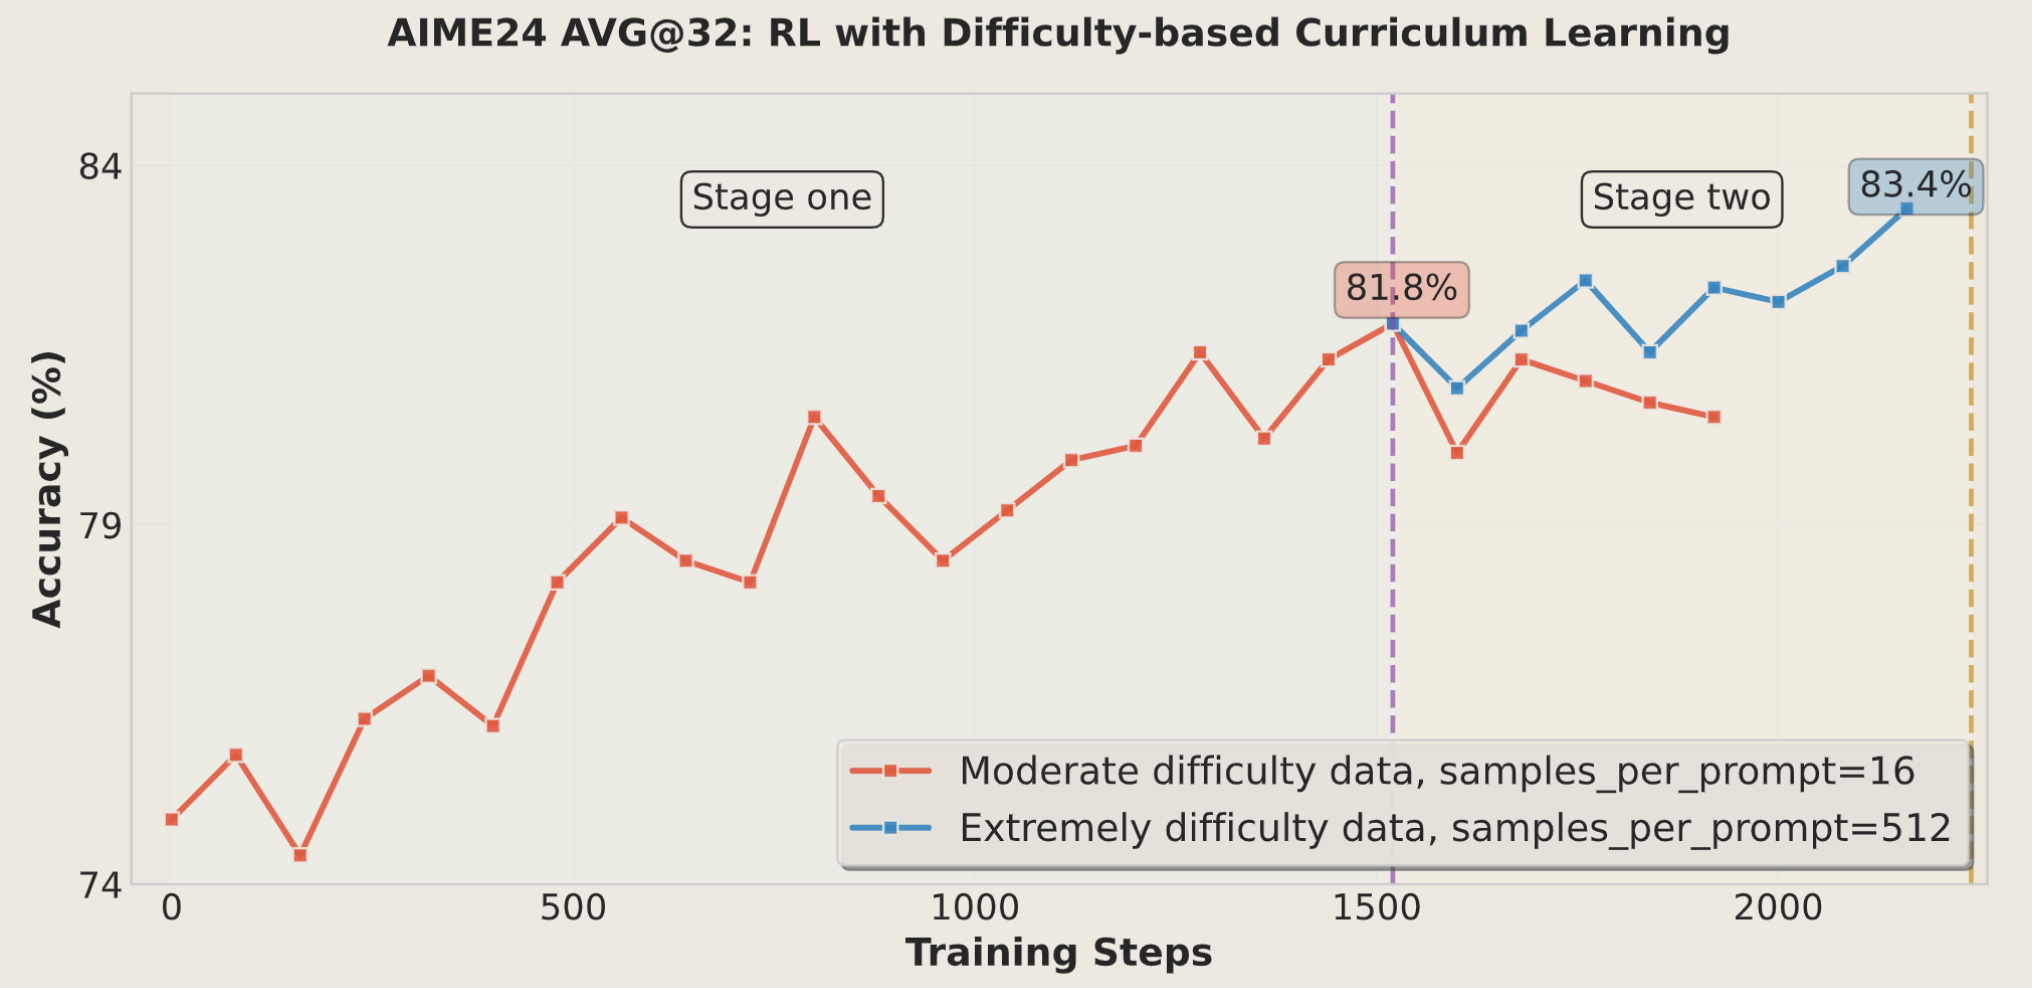
-
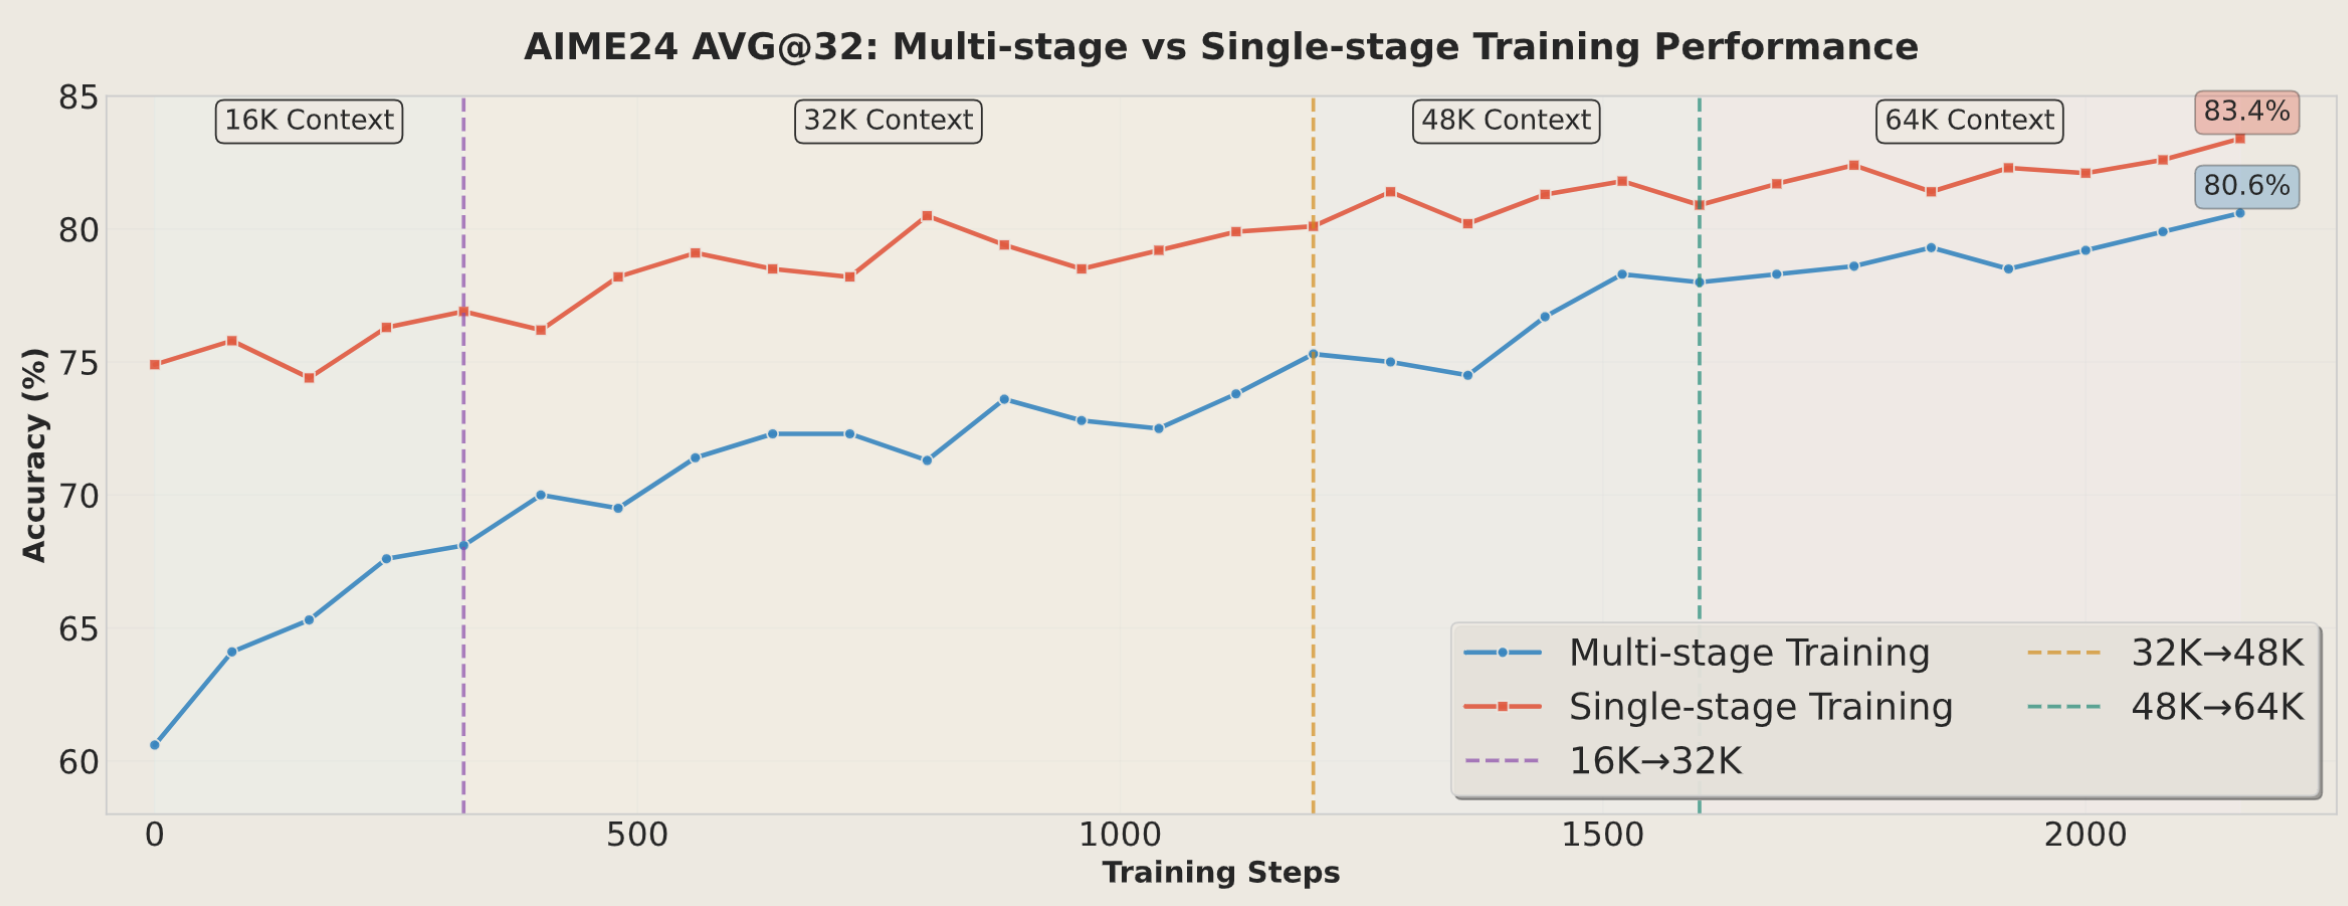
Single-Stage RL at 64K Output Length:对于 RL 的训练长度来说,直接到位比多步提升更明显对于 SFT 本来就已经在 64K 训练的情况下,如果突然在较短的 context 上进行训练,会有明显且不可逆的的性能 drop
- Dynamic Sampling Temperature:对于温度而言,过低缺乏多样性,多高可能导致模型训练不稳定。使用一个固定的温度往往只能获取到局部最优解。那么文章使用一个动态变化的方式:当 reward 稳定时,认为当前温度已经不太适合当前训练了,需要选择一个更高的温度。这个温度的选择是用一个测试集来检验一系列高的温度,当使用这个温度时,性能 drop 在 1 个点以内则是可选的
-
Code and Science RL:对于 code 文中发现使用 token-weighted loss 很重要;science 则是数据本身的质量和类型更重要(通过 the GPQA-Diamond benchmark 发现)如果只使用由专家核验过的选择题(多项选择题)数据,相比使用质量参差不齐或未经核验的数据进行训练,模型性能会显著更好
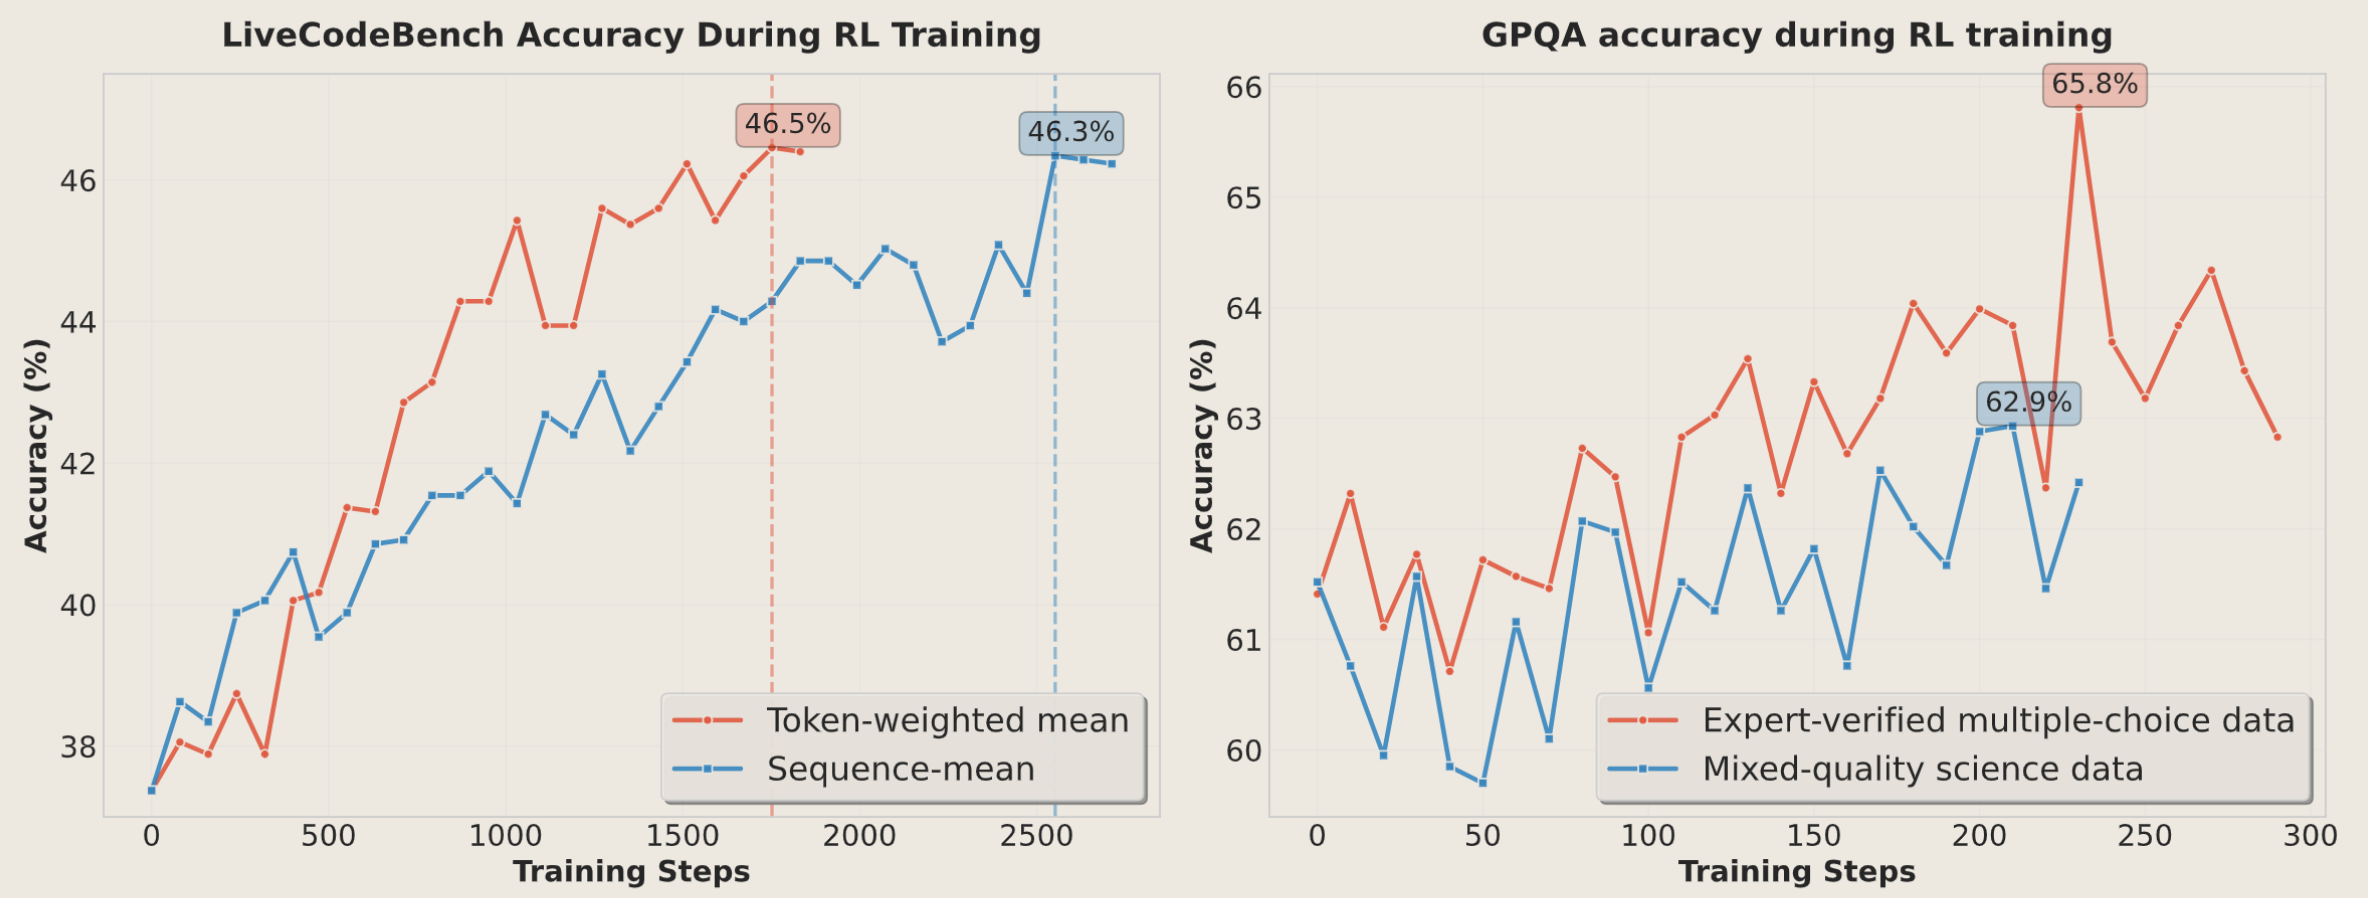
code 和 science 的发现
Agentic RL
Data Collection and Synthesis for Agents
对于 web search 相关,构建了一个合成语料库,这个语料库旨在提升 GLM 在互联网上挖掘那些不容易直接找到、彼此交织关联的事实的能力。数据集构建结合了两种方法:
- 基于知识图谱进行多跳推理(multi-hop reasoning)的自动化流水线
- 引入“人参与”的流程(human-in-the-loop):从多个网页中人工抽取内容,并对其中一部分信息进行有选择的模糊/遮蔽处理,用来准备强化学习训练所需的信号(reward/训练样本)
针对软件工程任务,我们整理了大量来自 GitHub 的 Pull Request 和 Issue,用来构建一个更贴近真实软件开发的基准测试集,其中包含用户提问/需求描述以及可执行的单元测试。所有评测都在一个加固的沙箱环境中、通过分布式系统运行,从而同时提供横向扩展能力(可并行跑更多任务)和强隔离保障(避免互相影响、提升安全性)
Pushing the Limits with Reinforcement Learning and Iterative Self-distillation
论文使用组平均的方式来作为 RL 的 loss
\[L_{\mathrm{RL}}(\theta) = \mathbb{E}_{x \sim \mathcal{D}} \left[ \frac{1}{K} \sum_{i=1}^{K} \left( r(x, y_i) - \bar{r}(x) \right) \right]\]- Outcome Supervision with Process Action Format Penalty:对过程格式施加惩罚,以确保模型生成正确的工具调用格式。如果模型在生成 agent 轨迹(trace)时未能产生正确的工具格式,流程将被终止,并且该轨迹将获得 0 奖励
- Iterative Distillation:使用训练了一定步数的 RL 模型去蒸馏 cold start data 去替代之前的 cold start data 获得一个更强的 SFT model,然后再对其使用 RL 同时增加数据难度。这使得 RL 的训练效率大幅度提升
General RL
这部分使用多种反馈系统有人工的、有 AI 的,其实应该就是 RLHF 和 RLVR 两种
Holistic RL
构建了一个大约 5000 左右的 prompts 的 dataset,其中包括: 7 个主类别,33 个子类别以及 129 个三级类别(构建细节没讲)
Instruction Following RL
这部分旨在增加模型遵循复杂指令的能力,包括 7 个大类以及 151 个子类别。使用 verification rules, a trained reward model 和 a critique model (并没有详细讲怎么用的)的综合评价来作为反馈系统。通过观察可以有效降低 reward hacking 的情况
Function Calling RL
- Step-wise Rule-based RL:对于调用清晰的情况,每一步的 function call 调用都会进行标注,而且会对比每次调用的格式以及内容是否完全匹配来决定 reward (0 or 1)
- End-to-end Multi-turn RL:Rule-based 的方式限制了 agent 自由探索的能力,因此还需要进行模型生成路径以及是否完成任务的方式进行学习。主要关注两类复杂任务场景,单轮多步骤任务(Single-Turn Multi-Step Tasks),在此类任务中,模型需要执行多步函数调用,并与外部环境进行交互以完成任务目标。我们采用基于 MCP 服务器自动合成的复杂任务,同时结合若干具备可运行环境的开源智能体(agentic)数据集以构建高复杂度的评测与训练场景。多轮多步骤任务(Multi-Turn Multi-Step Tasks),在该类任务中,模型不仅需要与工具执行环境进行交互,还必须与一个由大语言模型(LLM)模拟的用户智能体进行多轮对话,以逐步获取完整的任务信息,并最终完成整体任务目标
Pathology RL
最后是 Pathology RL,虽然说语言混杂、格式出错以及不断重复这个问题可以直接在 General RL 进行纠正,但是由于出现概率太低导致采样效率很低。文中直接通过 prompt 来更高概率的触发错误的形式构建数据集进行训练
Reference
GLM-4.5: Agentic, Reasoning, and Coding (ARC) Foundation Models
🌸 February 23, 2026
Comments
Sign in with GitHub to comment, or click the bottom icon to chat with me.